智东西9月20日报道,今日,阶跃星辰发布新一代MoE旗舰模型Step 5 Preview。该模型专为真实世界Agentic任务打造,总参数量600B、激活参数27B,支持100万Token上下文窗口,原生支持文本与视觉输入。
在全球AI榜单Artificial Analysis Intelligence Index中,Step 5 Preview得分44分,位居开源模型第三,排在其前面的开源模型是Qwen3.8 Max(0902)、GLM-5.3(max)。

根据Artificial Analysis的榜单,该模型的输出速度为100 token/秒,排名第6。

在成本方面,据阶跃官方数据,Step 5 Preview单任务成本为Claude Opus 5(max)的1/8。Artificial Analysis的数据显示,前者单次总开销0.71美元(约合人民币4.76元),后者为5.86美元(约合人民币39.25元)。


Step 5 Preview目前已全量开放,将于10月15日开源。
国内开放平台API接入:
https://platform.stepfun.com/
国外开放平台API接入:
https://platform.stepfun.ai/
Studio平台在线体验地址:
studio.stepfun.com
我们将Step 5 Preview的博客链接上传,让其直接生成面向非技术人员的PPT。可以看出,整个PPT内容重点明确、风格统一,在关键的数据上有突出显示,并且在每页PPT的下方还为演示者划了重点。

第二个案例,智东西上传了一个抽象的提示词“一曲流动的诗篇:驾驭风与线条,在由光影变幻、斑斓色块、温柔记忆与空灵旋律交织的梦幻图景中缓缓穿行。”Step 5 Preview先自己拆解需求,将提示词进行了扩写然后生成对应的视觉网页。


Step 5 Preview扮演创业模拟Agent,进行分步规划。该模型经营过程划分为7轮,分别为商业模式与选址策略、选址落地与证照办理、产品体系与定价策略、供应链搭建与首批备货、装修动线与设备采购、开业引爆与人员就位、终局报告。


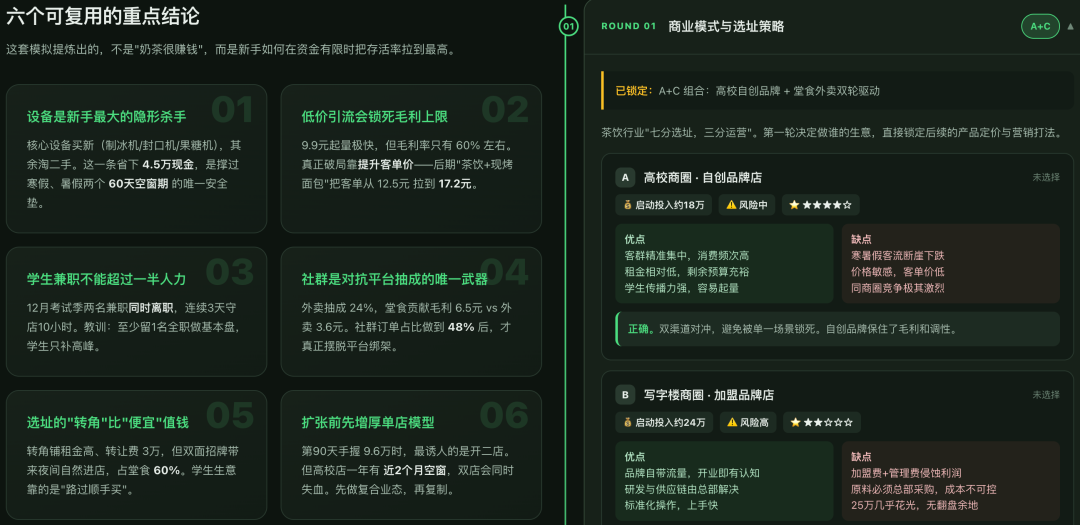
阶跃官方也放出不少Step 5 Preview的案例。
在真实软件工程方面,Step 5 Preview可以进行Web开发与视觉设计。如下面的案例就是模型基于一张照片生成的可编辑3D环境,用户可以在带摆放反馈的情况下移动和旋转家具或以第一人称视角参观房间。

第二个案例是基于历史资料构建的交互式历史图册,其以一本1922年的旅行指南为基础,通过路线、车站、行程规划与票价计算重建九广铁路,让档案资料的呈现形式更生动。

在长程任务执行中,阶跃选择了优化GPU Kernel、训练数据流程两个场景。
首先是优化GPU Kernel案例,Step 5 Preview在24小时内,在一张NVIDIA H100 GPU上从零开始优化一个MLA GPU内核。该模型自主修改、运行内核并测量吞吐量,经过约22小时将峰值性能提升至508 TFLOPS,超越Claude Opus 5的493 TFLOPS。

其次是优化后训练数据流程,Step 5 Preview在24小时内,通过自动化后训练提升了Qwen3-30B-A3B基础模型在AIME24上的表现。经过后训练,模型在AIME24官方测试集上的准确率由53.3%提升至60%,表现与Claude Opus 5持平,消耗的token更少。

除了编程,在没有做任何Pokémon专项优化的情况下,Step 5 Preview还在Pokémon Red游戏中,持续完成超过3000 Turns,累计交互接近600万Tokens。
这一游戏的难点在于需要持续推进一个很远的目标,模型需要记住之前获得的信息、管理资源、完成相互依赖的任务,并在原有计划行不通时重新调整。对于人类玩家来说,完成主线通常需要约26小时。

此外,Step 5 Preview还可以实现大规模研究、结构化分析、交互式报告等。


在真实任务场景,阶跃内部构建了测试集StepCodeBench。
该测试集覆盖553个独立代码仓库、9类任务、20个应用领域和33种编程语言。基于该评测,Step 5 Preview在整体任务成功率和跨场景稳定性等方面的综合得分为49分,超过Kimi K3、GLM‑5.3。

根据博客信息,在获得开发文档和用户授权后,Step 5 Preview可以直接调用相机、COM端口、截图和模拟鼠标输入,完成设备侧的开发与调试。
例如下面的案例就是Step 5 Preview连续工作超过3小时,根据设备反馈不断编写、运行并修改代码。Step 5 Preview根据自然语言需求,自主阅读ESP32设备及相关API开发文档,将一块ESP32-S3开发板改造成支持蓝牙按键与语音输入的Vibe Coding键盘。

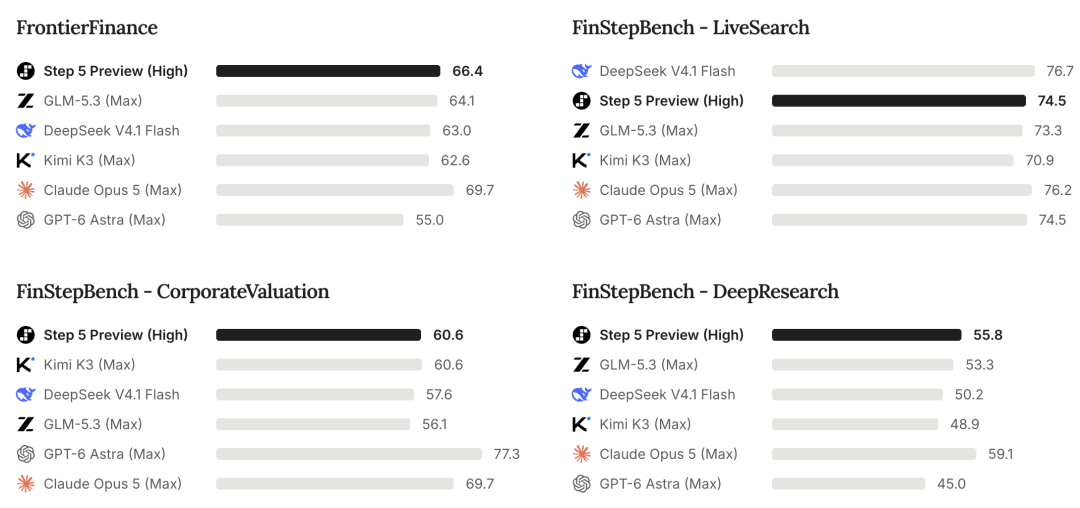
在金融领域,阶跃构建了FinStepBench-LiveSearch、FinStepBench-CorporateValuation、FinStepBench-DeepResearch三项内部测试,考察模型是否具备扎实的金融专业知识,是否能够建立跨行业之间的因果联系,以及是否能在信息不完整、数据口径不一致的情况下借助工具完成严谨分析和建模。
阶跃的博客中提到,过去,大模型Scaling的核心逻辑是用更多计算换取更强智能,但随着模型规模和任务复杂度持续增长,计算成本也被同步放大,Scaling的核心关注变成如何更高效地把计算转化成模型能力。
这也是其从Step 3.5 Flash、Step 3.7 Flash到Step 5 Preview持续探索的问题。他们认为,下一阶段的Scaling,不只是更多计算,也包括更高效率的计算。