在企业的日常数据工作中,数据智能体常常需要处理跨数据库、表格、文档的异构数据查询任务,小到单表的指标统计,大到跨多份10-K报告的行业趋势分析,都需要智能体自主交互获取数据。
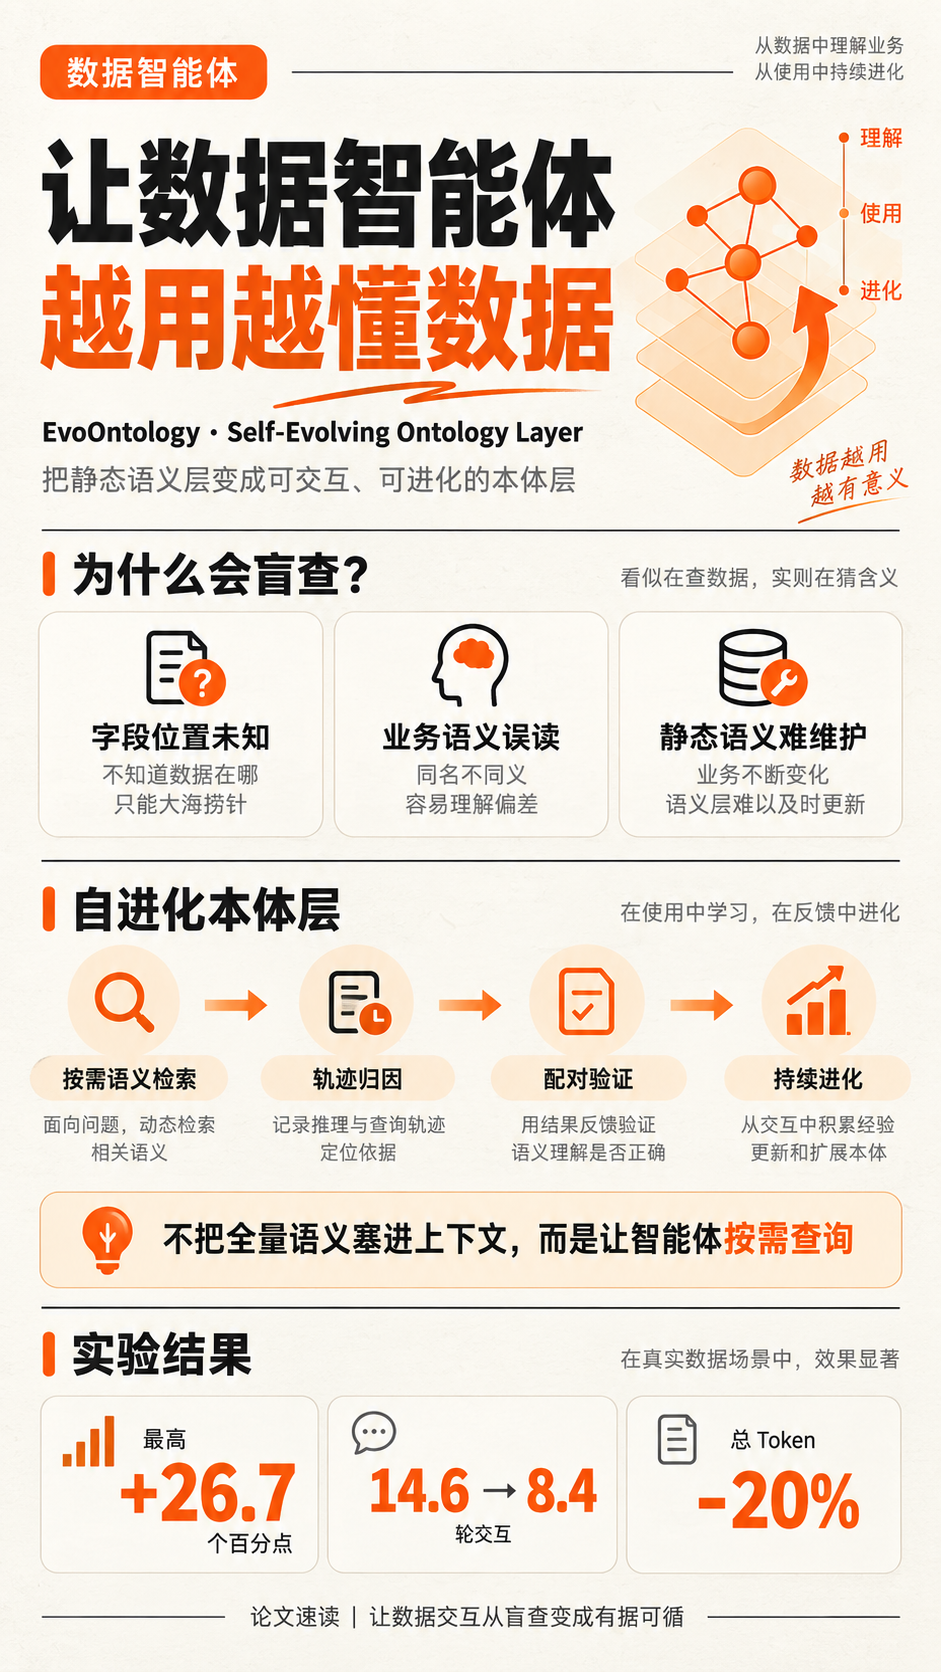
但在实际落地中,这类智能体往往会陷入反复盲查数据的困境:要么猜不到所需字段的存储位置,要么误解字段的业务含义,反复调用工具查询无效内容,不仅效率低,还经常输出错误结果。
针对这一痛点,中国人民大学数据科学实验室团队提出了EvoOntology自进化本体层,为数据智能体和异构数据之间搭建了可动态适配的交互桥梁。
论文标题:EvoOntology: A Self-Evolving Ontology Layer for Data Agents
论文链接:https://arxiv.org/pdf/2609.15779.pdf
开源仓库:https://github.com/ruc-datalab/EvoOntology
研究背景
数据智能体的核心能力是基于自然语言指令,自主完成异构数据的查询、分析、推理任务,随着大语言模型工具调用能力的成熟,这类智能体已经具备了访问外部数据库、读取文件的基础能力,但要实现准确高效的数据交互,仍存在一个核心的“智能体-数据鸿沟”问题:异构数据存储在智能体外部,智能体只能通过SQL接口、文件读取器等通用工具访问,无法提前知晓数据的结构、业务含义和关联关系,只能通过反复发起探询式查询猜测所需内容的位置,很容易陷入无效的重复探索中,大幅降低任务成功率。
目前主流的智能体数据交互方案主要分为两类:
一类是直接裸查询方案,让智能体自主读取数据 schema、发起探索性查询,这种方案在小规模、结构简单的数据源上效果尚可,但面对多源异构的大规模数据时,智能体很容易在探索过程中迷失方向。 另一类是基于静态语义层的方案,提前把数据的元信息、业务语义整理后注入到智能体的prompt中,引导智能体交互,但对于大规模数据源来说,完整的语义层内容会超出大语言模型的上下文长度限制,而且这类语义层大多需要人工编写维护,成本很高,也很难适配不断变化的数据源、任务需求和不同大语言模型的交互习惯。
这两类方案的局限性,也让行业亟需更灵活、可扩展的中间层方案来打通智能体和数据之间的交互通路。

EvoOntology核心架构设计
EvoOntology的核心设计思路是把原本静态的语义描述升级为可交互的本体层,封装为Model Context Protocol(MCP)服务器,智能体可以在运行时通过工具主动查询所需的语义信息,无需把全部语义内容都注入到上下文中,同时整个本体层可以基于智能体的交互轨迹不断自进化,适配不同的数据源和智能体行为习惯。

整个本体层分为三个独立的组成部分:
内容层是类型化的语义图,存储领域术语、数据映射、使用约束和支撑证据四类节点,以及语义关系、结构引用两类边,完成领域概念到底层数据的落地; 模式层定义了内容层的节点字段、允许的语义关系类型和引用规则,可以在不修改已有内容的前提下扩展本体的表达能力; 工具层则对外暴露两个MCP工具和会话清单,分别支持语义检索和实体解析,仅会话清单会被放入初始prompt中,详细的语义记录都可以根据需求按需获取,大幅降低上下文占用。
为了减少人工构建本体的成本,EvoOntology设计了自动初始化流程,由构建智能体基于训练工作流和原始数据源自动生成初始本体:首先从训练任务中挖掘高频的实体、指标、操作等候选概念,针对每个候选概念发起探询查询,验证其在底层数据中的对应字段、关联路径和语义一致性,只有通过验证的候选概念才会被加入初始内容层,同时留存对应的探询结果作为证据,整个过程无需人工标注也不需要访问标注答案。
在初始本体的基础上,EvoOntology还设计了完整的自进化循环,基于智能体的历史交互轨迹不断优化本体。首先对历史轨迹做归因分析,识别当前本体的缺陷,判断缺陷属于内容层、工具层还是模式层,之后针对缺陷提出针对性的修改方案,所有修改都需要在验证集上做配对评估,只有修改后性能提升达到预设阈值的方案才会被采纳,无效修改会被记录避免重复尝试,整个循环可以不断迭代,让本体持续适配新的任务需求和智能体交互习惯。
实验效果验证
研究团队在三类主流数据智能体基准数据集上验证了EvoOntology的效果,分别是面向多源数据研究的DDR-Bench、面向业务洞察挖掘的InsightBench,以及面向文本转SQL任务的BIRD,覆盖了数据智能体的主流应用场景,同时采用了六个主流大语言模型作为骨干,对比无本体层的基线方案、静态语义层基线方案的表现。
从实验结果来看,EvoOntology在所有基准、所有骨干模型上都实现了稳定的性能提升。在DDR-Bench的10-K场景下,EvoOntology的轨迹准确率相比基线平均提升 17.8 个百分点,最高在GPT-5.5骨干上提升 26.7 个百分点;而静态语义层方案不仅没有稳定提升,在部分骨干上甚至出现了性能下降,主要原因是静态语义层会占用大量上下文空间,和智能体的其他指令产生冲突,而EvoOntology的按需查询模式则避免了这个问题。

在InsightBench上,EvoOntology的整体性能相比基线平均提升 1.9 个百分点,在DeepSeek-V4-Flash骨干上提升达到 6.1 个百分点,同时实现了洞察分和摘要分的双向提升,而静态语义层方案在部分骨干上出现了摘要分下降的问题。在BIRD文本转SQL基准上,EvoOntology的执行准确率平均提升 7.4 个百分点,有效效率分平均提升 8.6 个百分点,证明方案不仅可以提升查询的正确率,还能降低无效交互,提升执行效率。


除了性能提升之外,EvoOntology还具备更高的成本效益。统计显示,进化后的本体虽然单轮输入词元相比基线有所提升,但因为减少了大量无效的探索步骤,单任务的平均交互轮次从14.6轮下降到8.4轮,单任务总词元消耗反而比基线低 20%,同时轨迹准确率从 69.5% 提升到 89.5%,实现了性能和成本的双向优化。

核心特性解析
为了进一步探究EvoOntology的能力来源,研究团队还做了一系列 ablation 实验和特性分析。首先验证了自进化循环的收敛性,随着迭代轮数的增加,四个主流骨干的性能都呈现单调上升的趋势,一般经过3-5轮迭代后性能就会趋于稳定,证明性能提升是不断迭代优化的结果,而非单次偶然的修改带来的。
对自进化循环的四个步骤做 ablation 实验发现,配对验证门控和归因是最核心的两个模块,去掉验证门控会让轨迹准确率下降 11.2 个百分点,因为没有过滤的修改很容易引入性能回退;去掉归因步骤会让性能下降 6.3 个百分点,因为无法准确定位缺陷所在的层级,很容易做出错误的修改。针对三个编辑层级的实验则显示,内容、工具、模式三个层级的修改是互补的,仅开放单个层级的修改都无法达到全层级修改的效果,其中工具层修改贡献了 57% 的累计性能增益,内容层贡献了 34%,模式层贡献了剩下的 9% 。

研究团队还发现,不同大语言模型骨干进化出的本体存在明显差异,不同骨干的本体术语重叠度最高不超过0.62,把一个骨干进化得到的本体迁移给其他骨干使用时,性能会出现 6.6 到 10.9 个百分点的下降,这说明针对不同骨干做专属的本体进化可以获得更好的效果。此外,本体的内容增长也具备可控性,大部分内容增长集中在前3轮迭代,之后内容规模就会趋于稳定,不会出现无限膨胀的问题。

应用价值与展望
EvoOntology的提出为数据智能体的落地提供了新的可行路径,无需人工投入大量成本构建和维护静态语义层,就能实现本体的自动构建和动态优化,同时适配不同的数据源、任务需求和大语言模型骨干,大幅降低数据智能体的落地门槛,尤其适合企业内部多源异构数据查询、业务分析、数据库交互等场景。
未来该方案还可以进一步扩展到更多模态的数据源场景,同时探索更高效的本体跨骨干迁移方案,进一步降低多骨干场景下的进化成本,为数据智能体的大规模落地提供更完善的技术支撑。
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群