出品|搜狐科技
作者|常博硕
9月22日,小米正式发布MiMo-V2.6系列,包括旗舰推理模型MiMo-V2.6-Pro和更强调效率的MiMo-V2.6-Flash,同时推出MiMo-V2.6-Pro-UltraSpeed,官方表示其在保持模型质量的前提下,输出速度最高可达到Pro版本的 20 倍。
其中,MiMo-V2.6-Pro是一款万亿参数级模型,支持文本、图像、视频和音频输入,上下文长度达到100万Token,最大输出长度为12.8万Token。它可以进行深度思考、调用工具、联网搜索,也可以处理结构化输出。Flash则是更轻量的版本,总参数约3090亿,激活参数约150亿,同样支持100万Token上下文。

每小时烧20万,小米要上桌
9月17日,罗福莉就在社交媒体上披露了小米MiMo-V2.6的训练细节,并随帖发布了MiMo-V2.6-Pro和MiMo-V2.6-Flash的实时训练数据看板。训练步数、Token消耗量、任务通过率、累计花费,甚至哪个节点的显卡出了故障,全都实时可查,把两款模型的训练过程做成了一场面向全网的直播。
按页面设定的费用速率计算,两轮训练合计每小时约3.08万美元,约合人民币20万。
根据小米最终公布的数据,MiMo-V2.6-Pro和MiMo-V2.6-Flash分别完成30个强化学习Step,累计约75万条轨迹,两轮训练成本分别约为262万美元和85万美元,合计347万美元,折合人民币约2328万元。
模型发布当天,罗福莉在社交媒体上发文表示,MiMo-V2.6很可能是迄今为止任何开源模型团队根据计算量进行的最大的单一RL运行。在推文中她还公开表示:“今天,它(MiMo-V2.6)是排名第一的开源模型。我强烈推荐阅读技术报告。我相信它将成为AgentRL从业者反复打开并每次都发现新内容的论文之一。在我看来,它背后的研究创新和工程挑战超过了DeepSeekR1,后者我曾部分参与。”
从模型结构本身看,小米这次并没有把全部赌注押在“更大的模型”上。
MiMo-V2.6技术报告题为《Scaling Reinforcement Learning Towards Self-Improvement》,小米团队把这项工作的核心概括为:继续扩大强化学习规模,并把它作为模型走向自我改进的一条路径。
从外部结果看,MiMo-V2.6确实完成了一次明显跃升。MiMo-V2.6-Pro 在 Artificial Analysis Intelligence Index v4.3 中获得 46.32 分,超过 Kimi K3 和 Qwen3.8 Max,与马斯克新发的Grok4.7持平,目前是全球开源模型首位。
 图片源自Artificial Analysis官网
具体到各项基准测试成绩,Pro在DeepSWE v1.1中获得71.9分,接近DeepSeek V4.1 Flash的74.2、Claude Opus 5与 GPT 6 Astra 的74.0;在Toolathlon-verified中获得76.9 分,高于GPT 5.6 Sol的 74.9。
看模型本身,Pro是一个1.02万亿参数的稀疏MoE模型,但每个Token实际激活的参数约为420亿,Flash是3090亿参数、150亿激活参数。
在底层架构上,Pro的语言骨干共有70层,其中60层采用128 Token窗口的滑动窗口注意力,10层采用全局注意力。
Pro和Flash两者都是稀疏MoE结构,通过局部注意力和少量全局注意力结合,在长上下文场景下降低计算和显存压力。
多模态部分也不是简单外挂几个模型,文字、图像、视频和音频最终进入的是同一套模型体系,而不是多个彼此独立的模型拼在一起。
在推理速度上,MiMo-V2.6继续采用多Token预测机制。官方数据来看,它加入了5层SWA结构的MTP推测解码器,每次前向过程可以提出后续多个Token,再进行并行验证。
当然,小米自己也承认,MiMo-V2.6和目前顶尖的闭源模型依然有差距。不过如果按照性价比来看,MiMo-V2.6非常能打。
搜狐科技整理了目前主流的一些大模型的API价格。
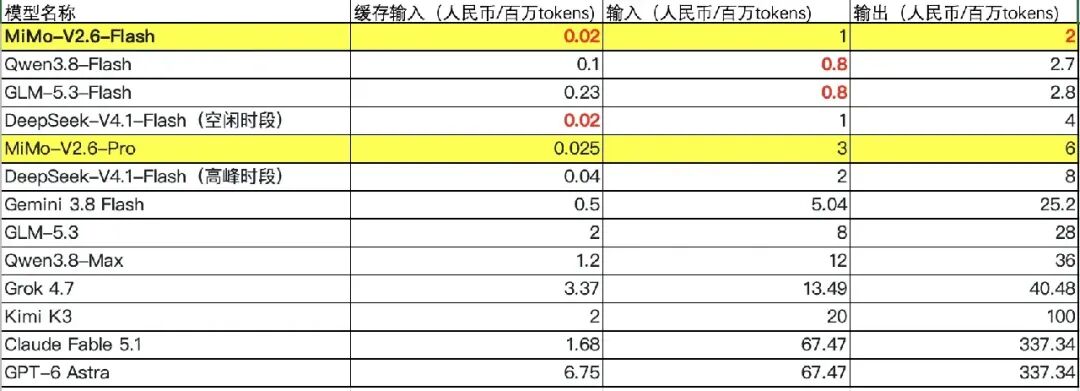 搜狐科技制图,数据源自网络

“You Only RL Once”
DeepSeek R1已经证明,模型在经过足够的强化学习后,可以出现明显的推理能力跃升。但如果把问题继续往前推一步,就会遇到新的瓶颈。如果题目越来越复杂,模型需要执行越来越长的任务,训练就需要更多尝试;任务变得开放之后,过去简单的答对还是答错又开始不够用了。
MiMo-V2.6解决的就是这几个问题。小米在这次训练中同时扩大了三件事。
第一是训练本身的规模。每个RL Step使用1568个样本,每个样本可以进行16次尝试,单Step处理约27亿到37亿Token,最长上下文达到100万Token。因为不同任务的执行时间差异非常大,系统还需要让代码、通用Agent、视觉、网络安全等任务在同一轮训练中并行运行。
这看上去只是一个算力问题,但真正落地以后,很快会变成一个工程问题。
一个简单的数学任务几秒钟就能结束,一个Coding Agent可能要读完一个代码仓库、修改代码、运行测试,再根据报错重新修改,如果是一些游戏或者3D任务则可能需要更长时间。如果所有任务都按同一种节奏进入训练,快任务会不断等待慢任务,训练资源也很难被充分利用。
因此,小米在报告里花了相当大篇幅讲训练基础设施,包括异步训练、统一轨迹表示、高并发多框架Rollout,以及控制面和数据面的解耦。
第二是训练环境。MiMo-V2.6没有把强化学习限定在数学题或者代码题里,而是把代码、通用Agent、视觉和网络安全等任务混在一起训练。小米希望不同任务之间形成能力迁移,而不是让模型在一个孤立的Benchmark上取得局部提升。
第三件事是怎么给模型打分,这是这份技术报告最精华的地方。
传统强化学习最简单的一套反馈机制是二元的,通过测试就是正奖励,没通过就是负奖励。但Agent任务很容易出现另一种情况。两个程序都通过了测试,一个只改了十几行代码,解决了真正的问题;另一个虽然也通过,却十分冗长,甚至修改了任务范围之外的代码。从“通过”这个指标看,两者没有区别,但从实际工作质量看,完全不是一回事。
MiMo-V2.6因此加入了Groupwise Agentic Grading。它不再孤立评价一个答案,而是把同一道题的一组Rollout放在一起比较,让一个Agent式的评分器去判断解决方案的质量。
其中一部分工作叫Groupwise Reward Synthesis,简称GRS。它先离线从不同轨迹中提炼任务本身的评价标准,再结合测试结果给不同方案提供更细的奖励。
另一部分是Groupwise Advantage Redistribution,也就是GAR。GAR处理的是“大家都做对了以后怎么办”。
小米的做法,是把同一道题产生的多条通过轨迹放到一起比较,然后继续区分解决方案的质量,把更多正向训练信号给那些更精准、更简洁、更符合任务要求的方案。
如果奖励机制只要求“完成任务”,模型很容易找到一条看似有效、实际上并不理想的路线。技术报告中的消融实验显示,在没有GAR的情况下,模型的平均交互轮数和Token长度会快速上升,模型越来越倾向于用更长、更保守的方式完成代码任务,最终通过率的提升也会趋于停滞;加入组内质量评分以后,模型的提升可以继续维持更长时间。
也就是说,MiMo-V2.6真正扩大的一部分,并不是模型参数,而是“反馈系统”,模型可以继续生成更多答案,但只有更好的评分器,才能告诉它哪些答案值得继续学习。
按照技术报告的披露,仅评分器一项就约占MiMo-V2.6-Pro整轮RL成本的12.7%。这意味着,当强化学习进一步规模化以后,需要增加的并不仅仅是训练模型的GPU,还包括给模型做“裁判”的GPU。
报告中还分享了一些小米团队的探索,比如MiMo-V2.6在RL过程中如果继续更新Router,会出现越来越严重的专家负载倾斜:少数专家收到大量Token,大量专家逐渐“闲置”。技术报告给出的实验数据显示,20个Step之后,专家负载的变异系数从0.78上升到2.0,峰值负载从平均值的6倍上升到16倍,冷专家比例从0.5%增加到22%。研究团队随后恢复Router原始权重,负载很快恢复,模型性能并没有因此受到明显影响。于是,小米最终选择在RL阶段冻结MoE Router。
还有一个问题,是哪些任务可以一起训练。
小米这次并没有试图把所有东西塞进一轮RL。对于代码、通用Agent这类可以比较清晰地验证结果的任务,MiMo-V2.6采用MixRL,让多个任务共同进入主RL过程。但对于游戏、3D以及一些非常长、非常主观、很难自动判断对错的任务,小米选择单独训练,再用MOPD2把这些能力整合回主模型。
因此,MOPD2承担了一个“能力合并”的角色。它使用Multi-Prefix Multi-Teacher On-Policy Distillation,把不同来源的教师轨迹、SFT示范和模型自主Rollout重新组织,在关键决策位置训练模型,而不需要把整个前置过程重新生成一遍。
这也是小米首次比较明确地把MiMo-V2.6和RSI,也就是“递归自我改进”联系在一起。
另外,MiMo-V2.6公开的不只有两个模型。小米还同步开源了训练所使用的RL环境和框架,并释放了超过7000个训练环境,同时提供了一个更小的MiMo-V2.6-Distill-Qwen-9B模型,帮助研究者在更低成本下复现这套训练思路。
正如罗福莉所说,MiMo-V2.6只是开始。“在智能易于复制的时代,我们仍然选择通往自我改进和AGI的这条艰难之路。未来的大部分仍未知。但我们愿意继续投入所需的时间、计算资源和热情,一个接一个地面对棘手问题,并将它们彻底解决,直到智能跨越进入一个新范式。”

运营编辑 | 曹倩 审核|孟莎莎