> 作者:李剑锋
1. 简介
在上一篇中,我们沿着一次模型调用,认识了输入处理、Prefill、KV Cache、Decode 和输出返回等环节。对于普通的自回归生成,模型需要先处理已有输入,再利用缓存逐步预测后续 token,最后由服务将生成结果转换成文本并返回。

但是,理解一个请求怎样生成回答,还不足以解释多个请求怎样高效地共同运行。
假设课程问答系统已经向整个班级开放。学生甲正在等待模型继续生成实验提交要求,学生乙又提交了一份实验手册,希望模型整理操作步骤;过了一会,学生丙也提出了一个简短的问题,只想确认提交时间。
三个请求都需要经历前面介绍的生成过程,但它们到达的时间不同,输入长度不同,所处的计算阶段也不同。此时,推理引擎需要解决的问题就变成了:怎样让新请求开始计算,同时继续推进已有请求,并为这些计算保存必要的状态?
下面以 vLLM V1 的典型 GPU 文本生成服务为例,重点观察学生乙的请求。为了便于逐轮分析,我们将计算规模缩小:假设乙有 12 个输入 token,丙在第二轮开始前到达,有 3 个输入 token;甲已经进入 Decode,并在第二轮计算后结束生成。服务每轮最多安排 8 个新 token 的计算,最多允许 3 个请求参与。这些数字只是教学示例,并不代表真实实验手册的长度,也不是实际部署参数的推荐值。
本节假设模型已经加载,三个请求使用同一个模型,每个请求只生成一条回答,采用保留完整历史 KV 的普通自回归生成方式。暂时不考虑前缀缓存共享、推测解码和多机部署等情况,并先假设缓存容量足够。
接下来,我们不按技术名称分别讨论,而是跟着乙的请求,从进入服务一直走到结果返回,观察请求调度、输入分块和缓存管理怎样在同一个执行过程中相互配合。
2. 请求接入与调度
2.1 记录请求状态
首先,在学生乙提交实验手册后,应用先整理系统提示词、课程资料和问题,再通过 API 客户端向 vLLM 发送请求。服务完成消息格式处理与分词,得到模型使用的 token ID,然后将请求交给引擎推进。
根据我们前面的学习可以知道,在 vLLM 的架构中,API 服务层负责 HTTP 请求接入、输入处理与结果返回;引擎核心负责运行调度器、管理 KV Cache,并协调 GPU Worker 执行模型。因此,请求被接收,并不等于它已经立即开始模型计算。
为了让一个请求能够跨越多轮计算,引擎还需要持续记录它的状态。例如,请求的输入有多长,已经处理到哪个位置,当前生成了哪些 token,以及是否已经结束。vLLM 的请求对象中,就包含输入、输出和已计算 token 数等信息。
对于刚刚进入的乙,可以先将其状态理解为输入共有 12 个 token,已处理 0 个,尚未生成回答,等待获得计算机会。这些状态不是额外的业务内容,而是引擎后续安排工作的依据。否则,即使输入被分成了多轮处理,服务也不知道下一轮应该从哪里继续。

2.2 连续批处理:逐轮调整
在乙的输入到达时,甲仍然在生成回答(也就是在 decode 阶段)。如果程序采用“处理完甲的整个请求,再处理乙”的方式,乙就只能一直等待。即使将多个请求提前组成一个固定批次,只要必须等这个批次全部结束才能加入新请求,仍然会出现类似的问题。
但是,前面已经知道,甲的回答是通过多轮计算逐步生成的。因此,推理引擎可以将安排工作的时机,从“整个请求结束以后”,细化到“准备下一轮模型计算时”。这种以迭代为单位重新安排任务的思路,使新请求不必始终等待当前批次全部完成。
例如,下一轮可以继续推进甲的 Decode,同时开始处理乙的输入。甲不需要让出整个生成任务,乙也不需要等甲的整段回答全部结束。
这种在执行过程中持续调整批次成员,让新请求加入、让已完成请求退出的机制,就是连续批处理(Continuous Batching)。 在 vLLM 中,它通过调度器与模型执行循环共同实现,而不是请求需要额外经过的一个处理阶段。

这里的“加入”,发生在后续计算安排中,不是把新请求临时插入一个已经运行到一半的 GPU 算子。调度器仍然需要先形成一份明确的执行安排,再交给模型执行。因此,乙进入服务后,首先获得的是一种新的可能性:不必等待甲完成整个请求,而是等待资源允许的某一轮计算。不过,能够加入,并不等于乙的全部输入都应该一次处理完。接下来还需要决定:这一轮究竟给乙安排多少计算?
2.3 分块 Prefill:按预算推进
假设本轮最多安排 8 个新 token 的计算。甲已经进入 Decode,在本节讨论的普通逐 token 生成过程中,需要处理刚刚生成的 1 个 token。为甲安排这一步后,本轮还剩下 7 个 token 的预算。
乙有 12 个输入 token,因此可以先处理其中的 7 个,将剩余 5 个留到后续轮次。本轮安排可以概括为:甲:Decode 1 个 token;乙:Prefill 7 个 token;合计 8 个 token。

这里的“8 个 token”,指的是本轮新送入模型处理的位置数量,既可以包含输入中的 token,也可以包含此前刚刚生成、现在需要继续处理的 token。它不代表本轮一定生成 8 个回答 token,也不包括将历史 KV Cache 中的所有位置重新计算一遍。
在 vLLM 中,max_num_batched_tokens 等配置用于限制一次迭代的处理规模,max_num_seqs 则限制一次迭代中处理的序列数量。在本节每个请求只生成一条回答的场景中,可以将后者理解为本轮参与计算的请求数量上限。
将同一个请求的 Prefill 分成多个部分,根据预算安排到不同轮次中完成,就是分块 Prefill(Chunked Prefill)。 vLLM 的优化文档描述了一种典型安排:优先推进待执行的 Decode,再利用剩余预算处理 Prefill;如果输入无法全部放入本轮预算,就只安排其中一部分。
这样,甲可以继续生成,乙也能开始处理输入,而不是为了处理乙的长输入,让其他请求长时间得不到推进。需要注意,这里的分块不是将实验手册拆成几个独立问题。乙仍然只提交了一次请求,后续各块也必须接着前面的计算状态继续处理。
至此,调度器已经将两种机制结合起来了:连续批处理让乙能够加入,分块 Prefill 则让调度器控制乙加入后这一轮推进多少。但这份计算安排还需要满足另一个条件:计算产生的 K、V,必须有地方保存。
3. 首轮计算与缓存
3.1 检查计算与缓存条件
乙本轮准备处理 7 个输入 token。模型在各注意力层计算这些 token 时,会产生后续还要使用的 K、V。如果没有足够空间保存这些结果,后面的输入处理和生成就无法按预期继续推进。
因此,调度器不能只检查 token 预算,还需要与 KV Cache 管理器配合,检查请求已有的缓存容量,并按需申请新的缓存位置。vLLM 的缓存管理接口会根据请求及本轮新增 token 数,为计算提供相应的存储槽位。
这意味着,所谓“本轮安排乙处理 7 个 token”,实际上包含了两项相互关联的判断:
这一轮是否有足够的计算预算处理它们? 这一轮是否有足够的缓存空间保存它们产生的状态?
如果第一项满足,第二项不满足,这份安排仍然不能直接执行。调度器可能需要减少本轮接纳的工作,或者让部分请求继续等待。
于是,问题进一步落到了缓存怎样管理:这些空间是否容易分配,后续增长时是否容易扩展,请求结束后是否容易重新利用?
3.2 PagedAttention:分页缓存
假设采用一种简单方式:每个请求进入后,都为它预留一整段连续的 KV Cache 空间。
如果预留得很大,请求最后却只生成很短的回答,就会有较多空间未被使用;如果预留得较小,后续缓存增长时又需要考虑如何扩展。多个请求不断加入和结束,还可能使空闲空间分散,形成不容易利用的碎片。

这类空间浪费会限制能够同时运行的请求数量。PagedAttention 所针对的,就是动态增长的 KV Cache 在分配与访问方面的问题。
PagedAttention 的关键思路,是让一个请求的 KV Cache 按固定大小的块组织,并允许这些块存放在不连续的物理位置。 请求通过映射关系找到各块,注意力计算再根据这些映射访问需要的 K、V。这样,就不必要求每个请求始终占据一整段连续区域。
为了观察这一过程,假设每个缓存块可以容纳 4 个 token 对应的 K、V 数据。实际模型会在相应注意力层维护缓存,这里将它们统一简化为“每个块容纳多少个位置”。
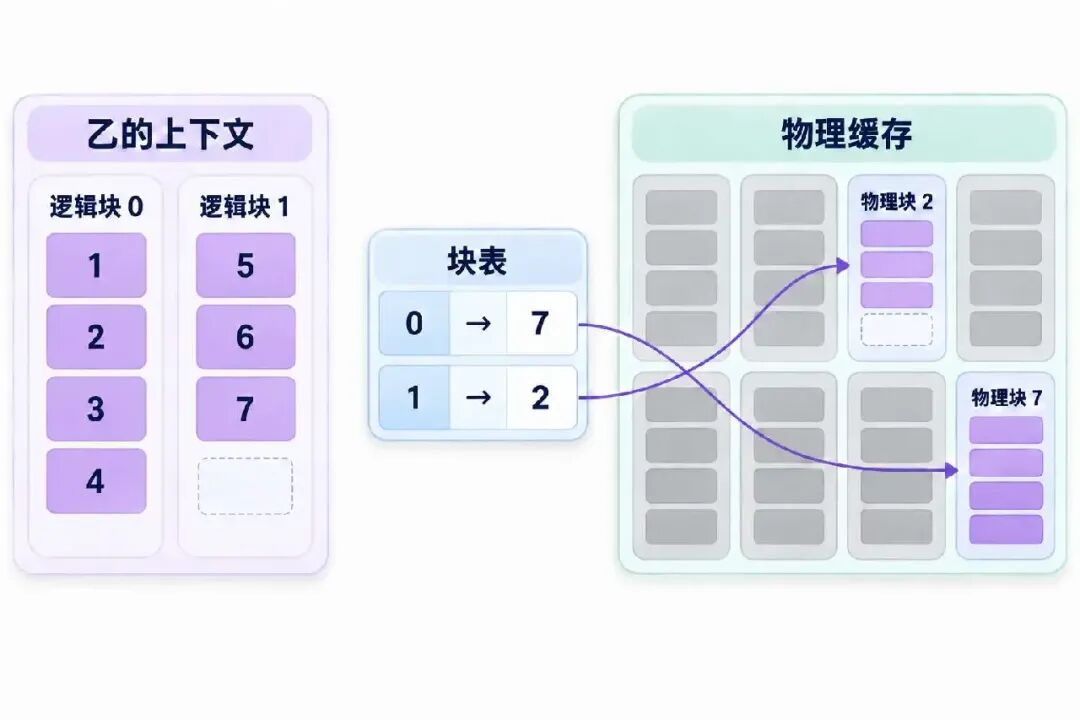
乙本轮准备处理 7 个输入 token,至少需要两个这样的块。可以安排为:
从乙的上下文顺序看,前 7 个输入仍然按照原来的次序排列;但在物理存储中,相关数据分布在物理块 7 和物理块 2。
乙的块表(Block Table)记录了“逻辑块 0 对应物理块 7、逻辑块 1 对应物理块 2”。因此,物理位置不连续,并不意味着上下文顺序被打乱。
这里讨论的是一种按需分配的简化过程。实际引擎还可能提前预留部分空间;示例中的块数用于说明存储需求与增长关系,不是某个具体版本的运行日志。
3.3 执行计算并写入 KV
完成空间安排后,缓存块中并不会自动出现正确的 K、V。分配空间与产生计算结果,是两件不同的事情。
接下来,由 GPU Worker 及模型执行组件处理本轮任务:甲执行一次 Decode,乙处理前 7 个输入 token。模型权重已经加载完成,不需要因为乙加入就重新加载一份模型。
对于甲,模型使用甲自己的历史缓存,处理它最新生成的 token。而对于乙,模型按照乙的输入位置执行 Prefill,并将产生的 K、V 写入刚才准备好的位置。执行组件除了需要知道“这轮有哪些 token”,还需要知道它们属于哪个请求、位于各自上下文的什么位置,以及应该读写哪些缓存区域。
因此,多个请求共同参与计算,不等于将它们拼成一段共同对话。甲与乙使用同一个模型,但各自的序列边界和缓存映射仍然保留。注意力计算按照这些信息访问各自的上下文。

从资源利用的角度看,组织更多有效工作共同执行,有机会改善单个请求逐 token 生成时计算规模较小的问题。但这不意味着批次越大越好,也不意味着混合计算完全没有相互影响。不同请求仍然共同承担本轮执行的耗时。
因此,在第一轮完成后,乙的状态变为:12 个输入 token 中,已经处理 7 个,还剩 5 个;前 7 个输入对应的 KV Cache 已经建立,但尚未完成输入处理,不能开始正式回答。
到这里,三个机制已经作用在同一项任务上:调度器让乙加入,并为它安排部分输入;缓存管理器提供相应块;GPU 按映射执行计算并保存状态。执行结果随后又成为下一轮调度的依据。
4. Prefill 阶段
4.1 重新安排第二轮
第二轮开始前,学生丙提交了一个简短问题。完成输入处理后,丙共有 3 个输入 token 等待计算。
此时,甲仍然需要继续生成,乙还有 5 个输入 token 尚未处理,丙则刚刚进入等待状态。调度器不需要继续沿用上一轮的请求组合,而是根据新的请求状态和资源条件形成下一轮安排。
在本例中,可以安排为:
甲:Decode 1 个 token;乙:Prefill 5 个 token;丙:Prefill 2 个 token;合计 8 个 token。

这一轮,乙能够完成剩余输入,丙也开始获得计算机会。丙的输入虽然较短,但本轮剩余预算只有 2,因此仍然有 1 个 token 留到下一轮处理。
这说明,Chunked Prefill 的分块大小不一定提前固定,也不要求每块都一样长。同一个请求这一轮处理多少,可以随其他请求的状态和剩余预算变化。 vLLM V1 可以用“请求 ID → 本轮处理 token 数”的形式表示这样的调度安排。
调度器并不是先单独执行一次“连续批处理”,再执行一次“输入分块”。在形成这一份安排时,它已经同时决定了参与者与各自的计算量。
4.2 按需增加缓存块
乙第一轮已经处理了 7 个输入 token。在每块容纳 4 个位置的示例中,第一个块已经填满,第二个块还剩一个空位。
现在,乙要继续处理第 8~12 个输入 token。其中,第 8 个位置可以使用第二个块中剩余的空间,第 9~12 个位置则需要增加一个新的缓存块。
假设新分配的是物理块 12,那么乙的块表就可以扩展为:逻辑块 0 → 物理块 7;逻辑块 1 → 物理块 2;逻辑块 2 → 物理块 12。
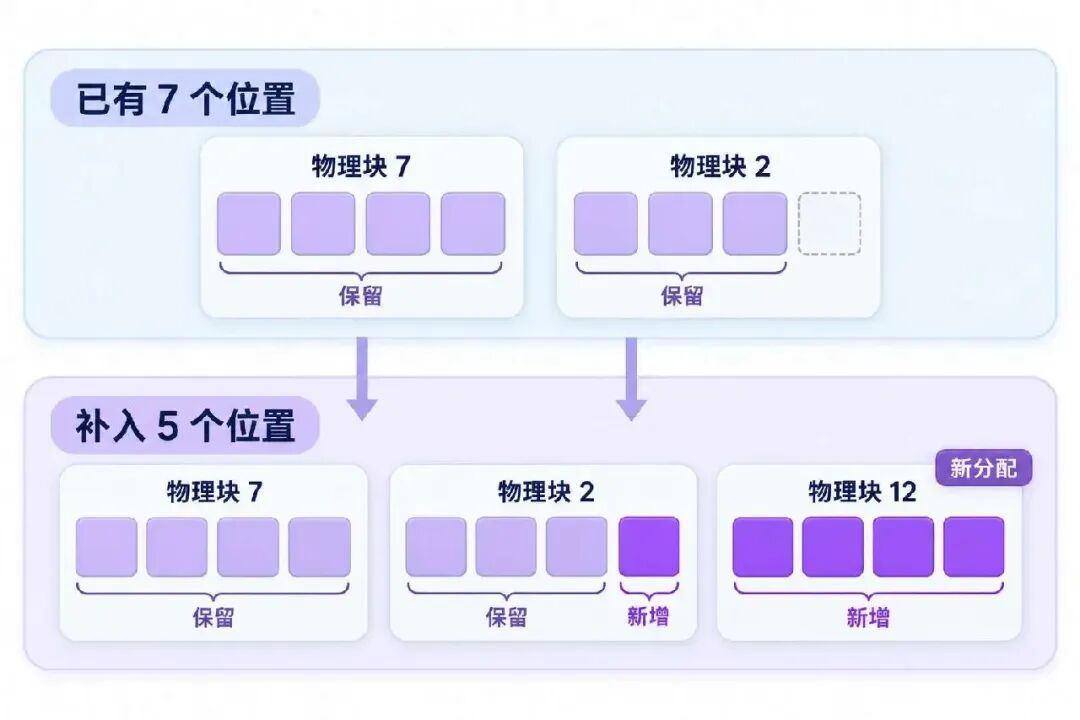
此前保存的数据不需要为了保持连续而搬到另一块更大的区域。新块可以来自其他空闲位置,已有块仍然保留原来的内容。这样的按需扩展,正是分页式管理支持持续生成的方式。
同时也要看到,PagedAttention 并没有压缩每个 token 本来需要保存的 K、V 数据。它主要改善的是空间如何分配和利用,而不是让相同上下文所需的计算状态凭空减少。
对于本轮调度来说,它提供的支持非常具体:乙可以在保留前 7 个输入计算结果的情况下,为后面 5 个输入继续取得存储位置。
4.3 接续上下文计算
缓存位置准备完成后,乙开始处理第 8~12 个输入 token。这时,模型不会把它们当成一段全新的、只有 5 个 token 的输入。前 7 个输入已经形成的 K、V 仍然保留,后面的输入会结合这些历史结果继续计算。
这里除了缓存内容,还需要保持正确的位置信息。第 8 个输入仍然位于原上下文的第 8 个位置,不能因为它被安排到新一轮,就重新当作第 1 个位置。缓存位置的管理,正是为了让后续 token 接着已经处理的上下文继续推进。
因此,分块 Prefill 并不是简单地“把文本分段送进去”。它需要同时保留同一个请求的身份、已经完成的计算状态,以及后续 token 在原上下文中的位置。
这也解释了它与 KV Cache 的关系:如果不保留前面已经完成的状态,后续就可能需要重新计算此前的输入,失去按轮次接续执行的意义。
需要注意,复用历史缓存,不代表这一轮只看后面的 5 个 token。它们仍然需要利用前面的上下文,只是通过已有 K、V 继续参与注意力计算,而不是重新生成历史位置的 K、V。
4.4 选出首个输出 token
当第 8~12 个输入 token 处理完毕后,乙的完整输入已经参与模型计算。接下来,可以根据最后一个输入位置的预测结果,选择第一个输出 token。
更具体地说,模型前向计算先产生对候选 token 的预测分数,再依据生成策略进行选择。例如,可以选取分数最高的 token,也可以按照相应的概率分布采样。最后得到的仍然是 token ID,而不是已经排版好的中文回答。
假设乙选出的第一个输出 token ID 是 645。这里的数字仅用于观察数据流,不指定它在某个真实分词器中的文字含义。
此时需要区分两个结果:一方面,12 个输入 token 对应的 KV Cache 已经建立;另一方面,第一个输出 token 645 刚刚被选出。
645 自身的 K、V 还没有因为“被选出”就自动产生。它需要在下一轮作为新输入送入模型后,才会形成自己的计算状态。
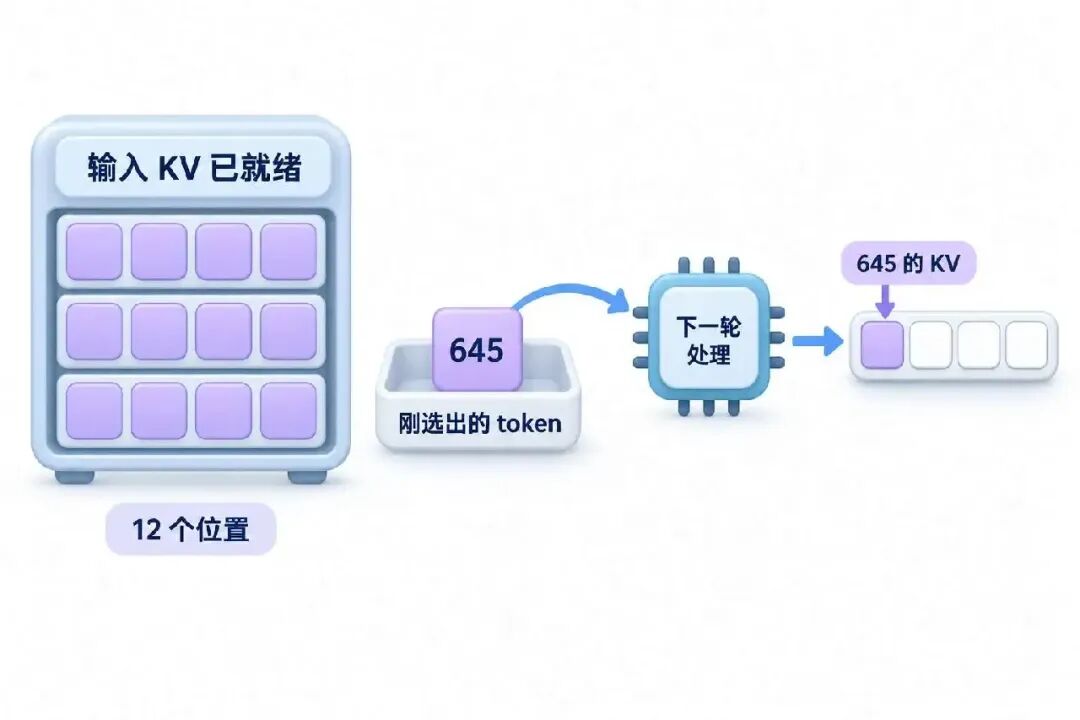
这时,如果采用流式返回,服务已经可以开始处理当前可输出的内容;但只要尚未满足停止条件,乙仍然需要继续参与后续调度。得到第一个输出 token,不是引擎调度的终点,而是这个请求开始进入 Decode 的位置。
5. Decode 阶段
5.1 资源释放
按照示例设定,甲在第二轮计算后结束生成。此时,乙已经获得第一个输出 token,丙还有 1 个输入 token 尚未处理。下一轮可以调整为:乙:Decode,处理 645;丙:Prefill,处理剩余 1 个输入 token;甲不再参与。
甲退出后,不仅不再占用后续计算名额,它所占用且不再被引用的缓存块,也可以重新进入可分配状态。vLLM 的缓存池会通过引用计数和空闲块管理,支持这些块的回收与再次分配。
这时,连续批处理与缓存管理的配合就更加直接了,即调度器将甲移出后续计算,缓存管理器让甲的可回收空间重新可用,下一轮安排再依据更新后的资源条件形成。
如果只调整批次成员,却不回收不再需要的缓存,服务仍然可能因空间不足而难以接纳新任务。反过来,如果缓存已经可用,但执行方式仍然要求等待固定批次全部结束,新请求也可能继续等待。
因此,请求退出、缓存回收和后续任务加入,是同一个循环中的连续变化。
5.2 复用缓存继续生成
第三轮开始时,乙已有 12 个输入 token 对应的缓存。模型将 645 作为新的输入,通过乙的缓存映射读取前面 12 个位置的 K、V,结合当前 token 继续计算。处理 645 时产生的新 K、V,也要保存下来,随后再选出下一个输出 token。
假设下一个输出 token ID 是 822,这一步可以理解为:处理 645,复用已有 KV → 保存 645 对应的新 K、V → 选出 822。这里仍然存在同样的先后关系:这一轮被送入模型的是 645,所以新增的是 645 的缓存;822 只是本轮刚选出的结果,需要下一轮再处理。

在缓存容量方面,乙此前已经保存 12 个输入位置,正好占满 3 个块。现在需要保存第 13 个位置,因此执行前需要再准备一个缓存块。
假设缓存管理器分配了物理块 5,那么乙就可以将 645 对应的 K、V 写入这个新块的第一个位置。这个块可以来自缓存池中的其他空闲区域,也可以来自甲结束后回收的资源,不必与乙原有的块相邻。
所以,这一轮并不是“调度器在调度、PagedAttention 在做另一件事”,而是调度器决定乙处理 645,缓存管理器为新增状态提供位置,模型执行组件再按照映射读取历史缓存并写入新结果。三者围绕同一次计算协同完成工作。
5.3 缓存增长与块分配
第三轮完成后,乙已经得到 822,丙也完成了输入处理并得到自己的第一个输出 token。而到了第四轮,乙和丙都可以进入 Decode。对于乙,模型处理 822,复用已有缓存,继续选择下一个 token,例如 415。
此时,乙的缓存从 13 个位置增加到 14 个位置。但第四个缓存块中还有空位,所以不必再次分配新块,只需要在已有容量中写入新增结果。每处理一个新 token,缓存内容可能继续增长;只有现有容量不足时,才需要扩展新的物理块。

将前四轮放在一起,可以得到下面这张表。表中的缓存块数,按照每块容纳 4 个位置计算,只表示本例的最低容量需求。
645 | ||||
645, 822 | ||||
645, 822, 415 |
可以看到,请求组合、每轮输入量、输出 token 和缓存容量,是在同一条执行时间线上共同变化的。
乙的输入跨两轮完成,之后又通过多轮 Decode 持续生成;甲的结束影响了后续批次成员,也改变了缓存池的可用资源;丙则在乙尚未回答完时,就开始并完成了自己的输入处理。
这里的共同计算,也不是让一个请求一次生成多个尚未知晓的 token。在普通自回归生成中,每个请求仍然遵守自身的先后依赖,只是不同请求的当前工作可以组织在一起执行。
5.4 预算不必用满
虽然第三轮和第四轮都只处理了 2 个新 token,没有用满 8 个 token 的预算。但是这不意味着调度错误。预算是允许安排的上限,不是每轮必须完成的指标。此时乙和丙各有一个新 token 等待处理,不能为了凑满 8 个,就让普通自回归模型提前处理尚未生成的未来 token。
同样,有剩余 token 预算,也不代表一定能够继续接纳请求。 如果缓存条件不满足,请求仍然可能需要等待。对于分块 Prefill,vLLM 还可以在接纳新请求时检查完整输入是否能够容纳,而不只是检查第一小块能否放下,以避免过度接纳造成缓存反复紧张。
这里还需要注意,token 预算并不是严格的时间预算。不同上下文长度、不同阶段和不同批次组合,可能产生不同的执行耗时。
因此,Chunked Prefill 的分块并不是越小越好。较小的块能够限制长输入在单轮中带来的工作量,但也可能增加执行轮次;较大的块能够更快推进输入,却可能拉长其他请求等待下一次输出的时间。实际需要在输入处理、持续生成和整体处理能力之间权衡。
本节的示例重点展示这种安排怎样发生,并不能仅凭轮次数量或 token 数量,直接推算实际加速倍数。
6. 流式返回与回收
6.1 计算与流式返回并行
前面主要观察了调度器、模型执行和缓存的变化。但对于乙来说,第二轮得到第一个输出 token 后,服务就已经可以开始处理已有输出,而不必等到所有 Decode 全部结束。
模型产生的是 token ID。服务需要使用分词器进行反分词(Detokenization),将这些编号转换成可读文本,再按照接口格式组织响应。这个步骤处理的是已经生成的结果,不会再次运行模型去重新组织答案。
如果采用流式返回,后续每当有新的可输出内容,服务就可以继续发送增量结果,应用接收后更新页面。一次返回的文本片段不必恰好对应一个 token,实际输出还会受到反分词、缓冲及服务配置的影响。
因此,运行到这里,服务并不是简单地“模型全部算完,再开始处理网络返回”,而是可以一边推进后续计算,一边处理已有输出。

vLLM V1 将 API 服务与引擎核心等工作分开组织,使分词、反分词和流式响应等处理有机会与核心执行循环重叠,减少这些外围工作对模型执行的阻碍。
对于应用来说,乙仍然只有最初的那一次调用。它不需要为了获得 822 或 415 再发送新的请求,也不需要接收和管理服务内部的 KV Cache。
这里需要区分两种“复用”:模型内部复用 KV Cache,是为了减少重复计算;应用持续接收同一次请求的响应,则是结果交付方式。 两者发生在同一个生成任务中,但承担不同职责。
6.2 请求结束与资源回收
当乙生成结束标记、匹配指定停止内容,或者达到最大输出 token 数时,服务会根据相应条件结束这次生成。应用除了读取文本,也应关注结束原因,因为达到长度上限时,回答可能尚未完整表达。
引擎确认乙不再需要继续执行后,就不再为它安排后续 Decode。其可回收的缓存块也会重新变为可分配资源,供丙或其他新请求使用。
这里的“归还”,主要指归还给推理引擎内部的缓存池。在预分配缓存池的配置下,请求结束后,可用块数量可以增加,但模型进程整体占用的显存不一定立即下降。

因此,一个请求完成后,发生的不只是“用户收到答案”,还包括服务内部的一次资源更新:计算任务减少了,可用缓存增加了,等待中的请求又可能获得新的执行机会。乙的一次调用到这里结束,但引擎的循环仍然继续:根据新状态安排下一轮,执行模型,更新缓存与请求,再继续安排后续工作。
7. 总结
沿着学生乙的请求,可以看到,vLLM 并没有改变“先处理输入,再逐步生成回答”的基本过程,而是进一步解决了:这个过程怎样在多个请求之间灵活安排,怎样获得必要的缓存支持,以及怎样将完成后的资源继续用于其他任务。
乙刚刚进入时,调度器可以将它加入后续计算,不必等待甲的整段回答结束,这体现了连续批处理。安排乙的输入时,又可以根据本轮预算先处理一部分,这体现了分块 Prefill。为了执行这些工作,缓存管理器需要提供相应的存储位置,模型则依据分页映射读写 KV Cache。执行结束后,输入进度、输出结果和缓存使用情况,又共同影响下一轮调度。
因此,更符合运行逻辑的主线是:请求进入 → 根据状态安排本轮参与者与计算量,同时确认缓存条件 → 执行模型并读写缓存 → 更新状态、处理已有输出 → 继续下一轮 → 请求结束后回收资源。
Continuous Batching、Chunked Prefill 和 PagedAttention 并不是这条链上三个互不相关的步骤。连续批处理使参与者能够变化,分块 Prefill 使计算量能够分轮安排,分页式缓存管理与访问则支持这些变化持续执行。 它们在同一轮任务中相互配合,也会在后续轮次中反复发挥作用。
还需要保留一个边界:KV Cache 的计算复用本身不是 vLLM 独有的能力,分页管理也不会让显存容量变得无限。这些机制希望减少的是不必要的等待、过大的单轮输入计算,以及缓存预留和分配中的浪费,而不是保证所有请求在任何条件下都同时变快。
理解了这一过程,后续再学习部署配置与性能评估,就能把参数和现象对应起来:限制每轮 token 数,影响的是计算安排;调整请求数量上限,影响的是参与规模;改变缓存容量,影响的是哪些任务能够被接纳和持续推进。
-- 完 --
关注机智流并加入 AI 技术交流群,不仅能和来自大厂名校的 AI 开发者、爱好者一起进行技术交流,同时还有与、、、、等。
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群
-- 完 --
关注机智流并加入 AI 技术交流群,不仅能和来自大厂名校的 AI 开发者、爱好者一起进行技术交流,同时还有与、、、、等。
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群