新智元报道
新智元报道

GPT-6还没玩明白,GPT-7就已经在路上了?
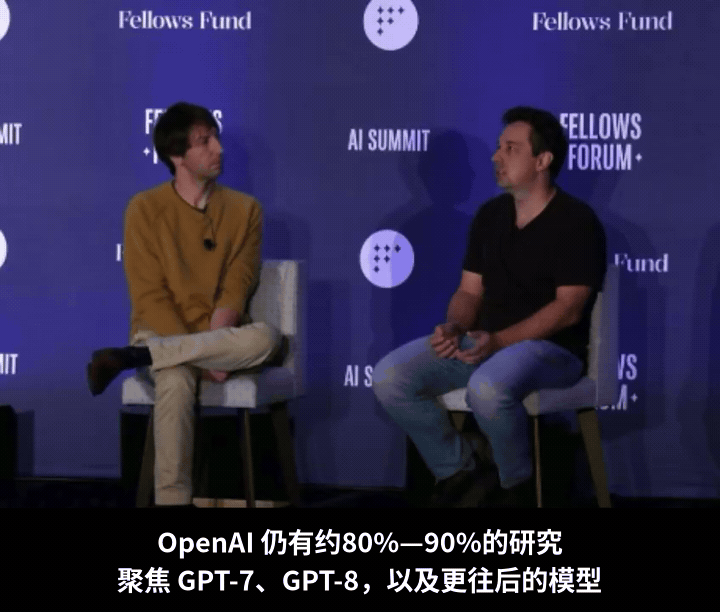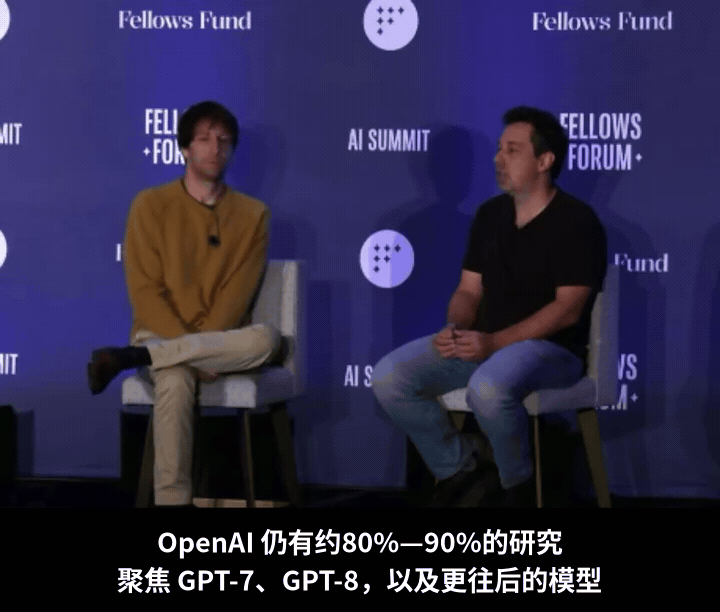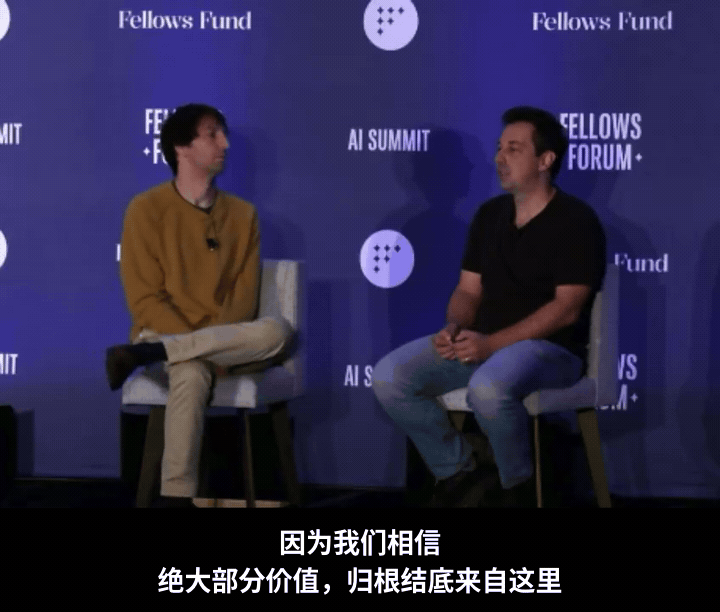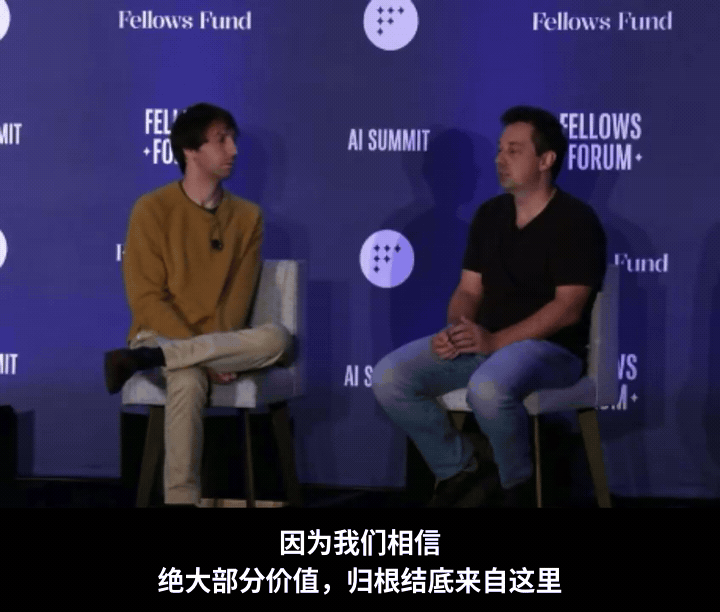
近日,OpenAI应用研究负责人Boris Power透露,OpenAI已把目光投向下一代模型:
公司大约80%到90%的研究,已经聚焦GPT-7、GPT-8,以及更新代际的模型。
但眼前的GPT-6,OpenAI仍然没少下功夫。
就在本月,OpenAI先推出主打能力上限的GPT-6 Astra,又在9月22日推出更快、更实惠的Sol和Luna。
这边已经将绝大部分研究精力投向GPT-7、GPT-8等下一代模型,那边还在不断给GPT-6家族添油,这就引出了两个问题:
既然OpenAI把研究重心押在下一代,为什么还要不断优化现有模型?
既然要把大模型越练越强,为什么同时还要做更小、更便宜的版本?

用Power的话说,部分针对现有模型的优化投入,在OpenAI内部甚至被视为「极度短视」。
这些工作能帮助团队今天更快迭代、更快学习,但长期的押注,仍然放在下一代模型上。

这就要分清两件事:今天值得做的优化,它的适用期是多久?
比如,模型现在调用工具容易报错,团队就收集数据、调整训练,把这个窟窿补上。
每修好一个问题,产品就更好用一点,团队也多积累一份经验——这在Power看来是必要的,但他也提醒,里面有一个坑:
当下一代模型一来,今天费劲补的短板,可能就不再是问题了。
新一代模型会让许多事情变得更容易。因此,团队也得重新判断:接下来,哪些问题最值得花精力解决?
也就是说,模型进化得越快,有些方案的价值就越需要重新掂量。
但明天可能过时,不代表今天不值得做。用户现在就要用产品,眼前的短板,该补还得补。
OpenAI在Astra的官方介绍里也提到,团队仍在针对实际工作训练模型,并改进Codex,让AI干活更快、更顺畅。
对普通用户来说,这也意味着今天为了让AI干活,你得反复改提示词、拆步骤、盯过程,但这些麻烦未必会一直存在。
模型升级了,旧的问题可能迎刃而解,新的用法也需要重新摸索。
真等GPT-7、GPT-8下一代模型来了,我们不妨再去试试:过去得手把手让前代模型们干的活儿,现在能不能只交代目标,它就能自己往前干?

既然要把大模型做得更强,为什么还要费力做小模型?
在Power的逻辑里,这两件事恰好连在一起。
先练出一个能力很强的通用模型,再让它当老师,教会更小、更专的模型。
他以Astra和Luna为例,勾画出了这条「先做强、再蒸馏」的路线。
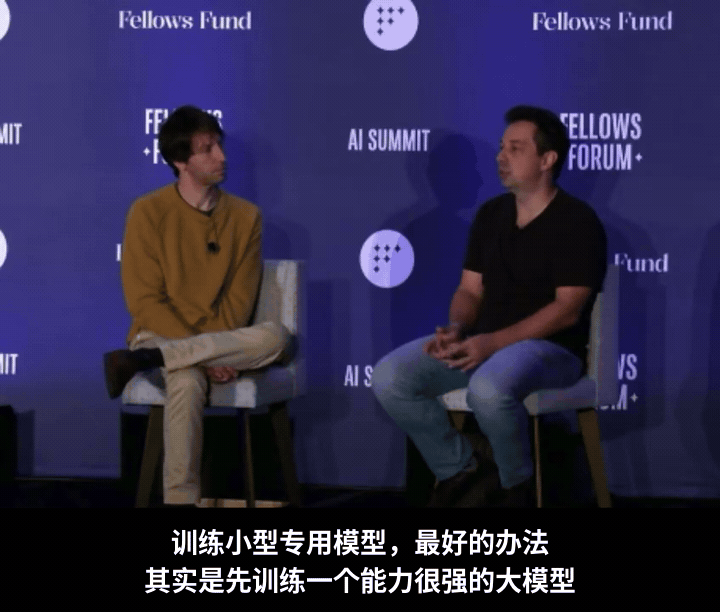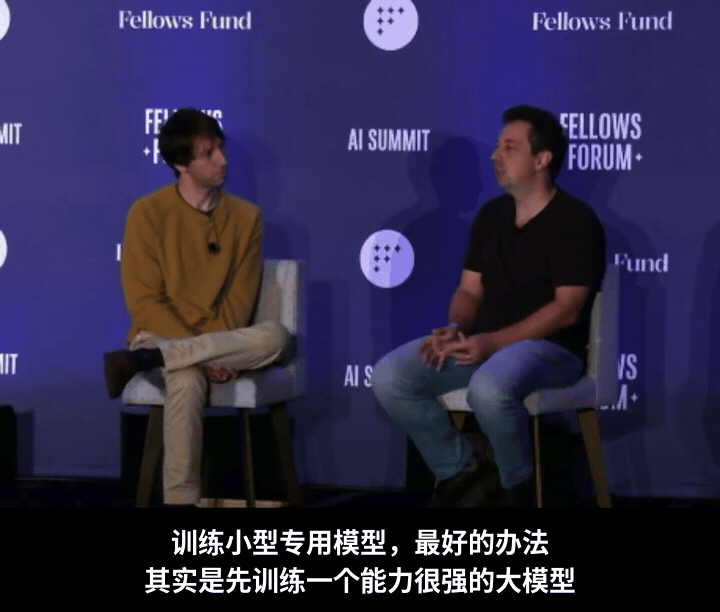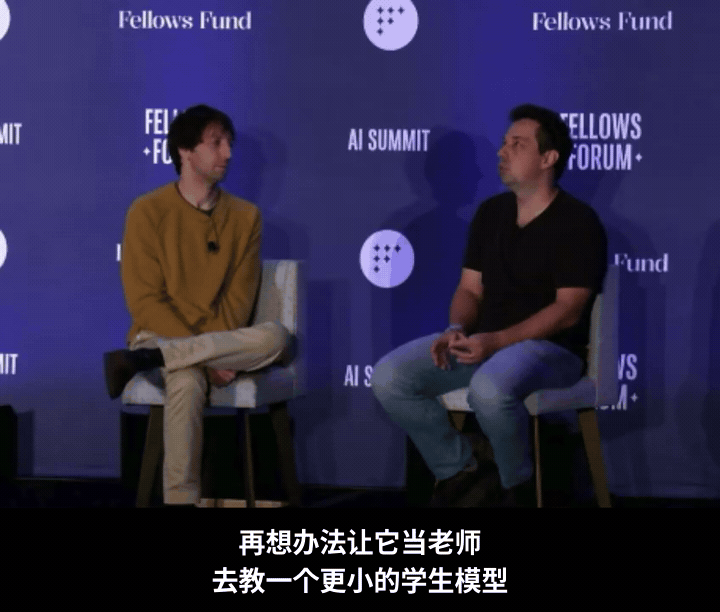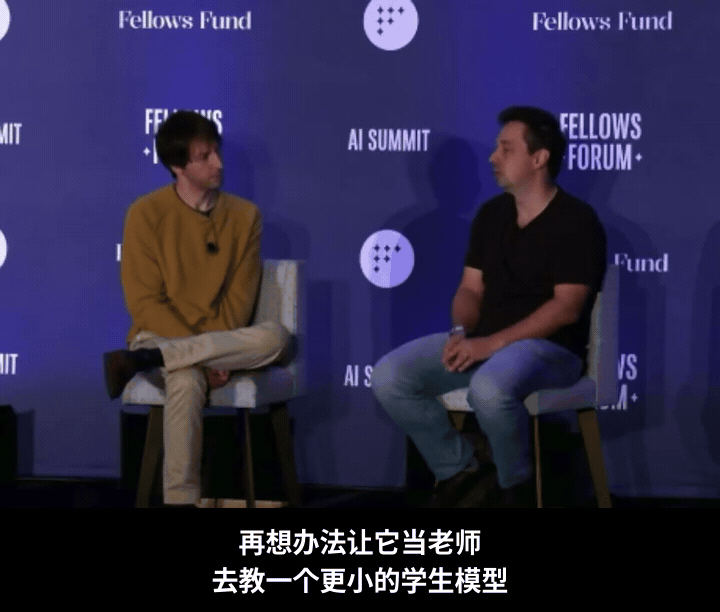
这也能解释OpenAI为什么会将八九成的研究押向GPT-7、GPT-8等未来更强的模型。
它们既能自己下场解难题,也能成为下一批小模型的老师,让部分能力进入更便宜的产品。
从技术上说,一种常见的模型蒸馏方法是:先让强模型生成示范,筛选出高质量输出,再用这些数据训练更轻量的小模型。
而这套方法,OpenAI自己已经驾轻就熟。
2025年3月,OpenAI发布新一代音频模型时,就明确披露:
团队通过蒸馏,把自家大型音频模型的知识传递给更小、更高效的模型,并用模拟真实对话的数据,改善小模型的对话质量和响应表现。
官方还给过一个更直观的教学示例:让GPT-4o当老师,训练GPT-4o mini根据葡萄酒信息判断葡萄品种。
在该示例的300条验证数据上,GPT-4o mini的准确率从64.67%提高到79.33%,接近GPT-4o的79.67%。
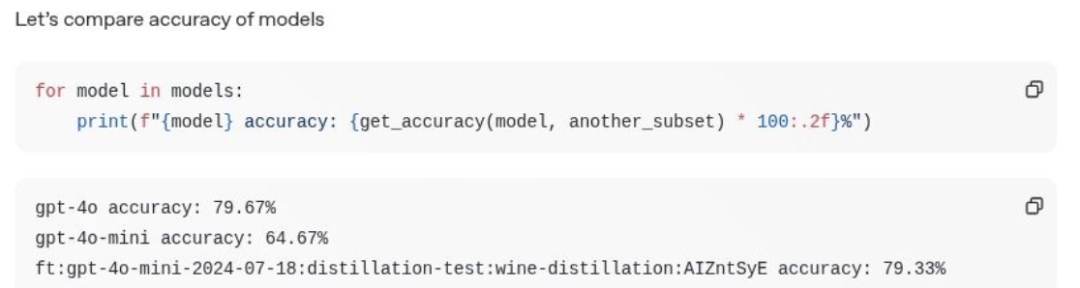
葡萄品种判断任务中,GPT-4o mini蒸馏后准确率升至79.33%。
这是特定任务上的结果,并不意味着小模型全面追平了大模型。
不过,学生本来也不必学会老师的全部本事:
只要在特定任务上达到需要的水平,又把成本降下来,这笔账就可能划算。
回到GPT-6家族,类似的能力迁移与成本分工仍在继续。
9月22日,OpenAI推出GPT-6 Sol和Luna,强调更快、更实惠。
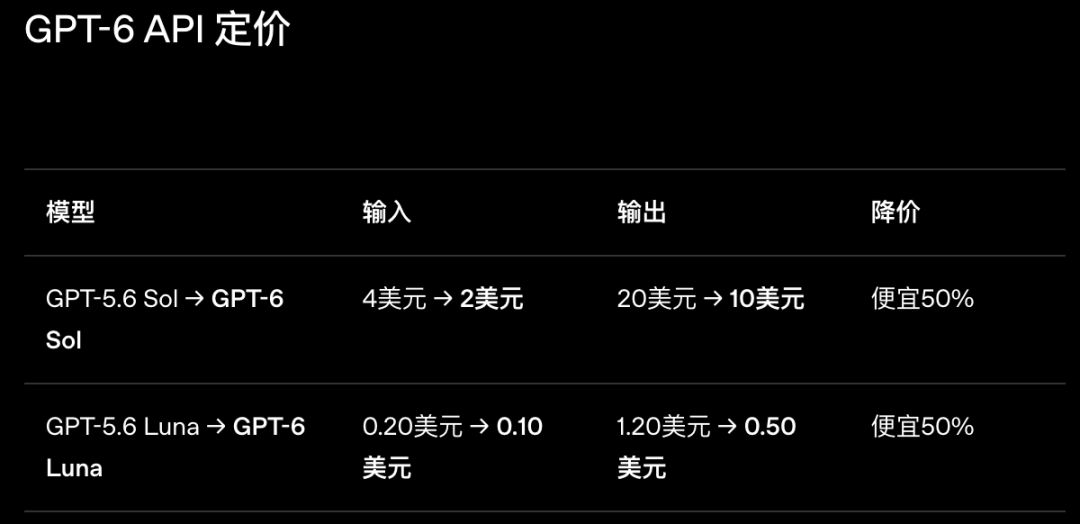
官方称,它们采用与Astra相似的方法训练,把相关能力进步带向成本更低的模型。
虽然具体训练配方并未完整公开,也不能直接把Luna说成一个「缩小版Astra」,但方向已经很清楚:
大模型抬高能力上限,小模型降低使用门槛。
对普通用户来说,这意味着哪怕你日常选的是便宜模型,也可能间接受益于更强大模型的研究成果。

不是所有任务,都必须用最顶级的模型。
一份工作里,有些环节需要深度判断,有些只是把已经明确的要求执行到位。让大小模型各接一部分活,才有机会把钱花在刀刃上。
来看一个准备项目汇报的例子。
几份材料说法不一,数据口径互相打架,核心结论也没想清楚。
这时,可以先让更强的模型梳理逻辑、找出矛盾,指出还缺哪些证据,再搭起报告框架。
等关键事实核实了、方向确定了,后面的工作就可以尝试交给小模型。
遇到材料无法解释的新问题,或者需要重新判断结论,再交给更强的模型处理。
这样,大模型负责啃难题,小模型负责接住那些要求明确、反复要做的活。
当然,具体怎么分,还得看模型在这项任务上的实际表现。
对于用户来说,便宜固然有吸引力。
但如果每次都得自己试模型、拆任务、判断何时切换,出了错还要返工,那么省下的模型费用,很可能又变成了额外花掉的时间。
合理的分工,是让小模型以更低的成本,把要求明确的日常工作做好;让大模型在关键时刻,接手那些需要更强判断力、值得多花成本的难题。
这笔账,最终要看完成整项工作的总成本:既包括模型费用,也包括人花在解释、检查和收尾上的时间。
便宜的账单,不能靠用户多打一份「管理AI」的工来换。
Power认为,这几代模型的变化,也在改变人的角色。
比如,用GPT-4时,用户需要精心设计提示词;到了GPT-5,虽然更容易上手,仍然得不断反馈纠偏;GPT-6则已经更像一个能接下目标、往前干活的同事。
这还只是Power的判断,不能看成所有任务都可以彻底放手,但OpenAI的官方已经提到一些具体的变化。
在Codex中,Astra可以向用户提问,同时继续处理不依赖回答的工作;遇到重要决定,则等待用户输入。
官方还称,它能在接收新要求时,更好地记住原来的目标和约束。
这些变化没有跑分那么直观,却直接关系到AI能不能从「工具」走向「同事」。
背后考验的,是AI自主推进任务、持续扛活儿的能力:要记得住目标,能把工作往前推,也知道哪些决定必须请人拍板。

未来的GPT-7、GPT-8,能把这种协作能力推进到什么程度,还要看后续产品的表现。
但对用户来说,模型升级的价值,要算一笔更实在的账:
交代完一个目标,还要替它拆多少步骤、催多少次进度、收多少烂摊子?
只有这些负担实实在在减轻了,模型的进步才能真正让我们的工作和生活更轻松。
这既需要大模型不断攻克难题、抬高能力上限,也需要小模型把更多能力带进日常,让人用得起,也愿意天天用。
参考资料:
编辑:元宇