谷歌突然开源!端侧 AI 的 GPU 底座,要变了

边缘计算社区 2026-10-10 12:48
10 月 8 日,Google AI Edge 团队正式开源 ML Drift。
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图1
这是一个面向端侧 AI/ML 推理的跨平台 GPU 计算引擎,采用 Apache 2.0 许可证。目前,ML Drift 已经成为 LiteRT 的核心 GPU 加速引擎,同时也可以作为独立库使用。
它支持 OpenCL、OpenGL ES、Metal 和 WebGPU,覆盖 Android、iOS、Web,以及 Windows、Linux、macOS 等平台。
如果只看这些介绍,ML Drift 很像又一个“端侧推理框架”。
但真正值得关注的地方,不在于 Google 又开源了一个项目,而是它正在重新搭建端侧 AI 的 GPU 推理底座。
一个非常明确的信号是:随着 ML Drift 推出,原来的 TFLite GPU delegate 将不再获得新的功能更新。Google 正在把过去为传统机器学习建立的 GPU 推理体系,逐步迁移到一套为生成式 AI 重新设计的架构上。
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图2
图:ML Drift 对不同平台及 GPU API 的支持情况

01
为什么端侧 GPU 推理需要重做?
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图3

TensorFlow Lite 的 GPU delegate 并不算失败。
恰恰相反,它已经支撑了很多年的手机视觉、音频、图像分割和实时特效。
问题是,模型变了。
过去端侧 AI 的典型任务,是图像分类、目标检测、语音识别。模型规模有限,计算图相对稳定,很多优化方法也已经比较成熟。
现在不一样了。
大语言模型、扩散模型、多模态模型开始进入手机、PC、浏览器甚至各种边缘设备。模型规模更大,内存占用更高,对带宽的压力也完全不同。
尤其是大语言模型。
LLM 的 Prefill 和 Decode,本质上就是两种不同的计算负载。
Prefill 阶段更吃计算能力;进入逐 Token 生成之后,Decode 又越来越受内存带宽和 KV Cache 访问效率限制。
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图4
图:ML Drift、MLX Swift LM 与 llama.cpp 在 Apple A20 Pro 上运行部分端侧 LLM 的 Prefill/Decode 吞吐量对比
这时候,如果还按照过去传统机器学习模型的思路设计 GPU Runtime,很快就会撞到瓶颈。
另外一个现实问题是硬件碎片化。
数据中心里的 GPU 集群通常高度标准化。但端侧完全不是这样。
不同手机使用不同 SoC,不同 GPU 架构对应不同驱动;Android 常见 OpenCL、OpenGL,苹果设备走 Metal,Windows 和 Linux 又涉及 WebGPU、Vulkan、Direct3D 等不同技术路径。
开发者面对的,不只是“模型能不能跑”。
而是同一个模型,怎么在这么多不同 GPU、驱动和 API 上都跑得稳定,而且还要跑得快。
这才是 ML Drift 想解决的问题。

02
ML Drift 改了什么?
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图5

ML Drift 有不少技术细节,但如果从工程角度看,核心思路其实很明确:
尽量把上层模型和底层 GPU 的差异拆开。


张量虚拟化
一个比较关键的变化是 Tensor Virtualization,也就是张量虚拟化。
以前维护 TFLite GPU delegate 的 Shader,需要针对 OpenGL、OpenCL、Metal 等不同后端处理张量和 GPU Texture、Buffer 之间的映射关系。
不同后端往往意味着不同实现。
ML Drift 则把逻辑上的 Tensor 和 GPU 上真正的物理存储进一步解耦,再通过运行时生成 Shader 的方式完成映射。
简单理解,就是上面的模型尽量不用关心底下到底是哪一种 GPU API。
这样做的价值不只是少写几套代码。
更重要的是,当设备、GPU 和驱动越来越碎片化时,Runtime 才有机会真正成为中间的“统一层”。


原生支持 5D Tensor
Google 还补上了 5D Tensor 支持。
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图6
图:ML Drift 在 Arm Immortalis G925 上运行部分 5D 模型的性能表现
过去 TFLite GPU delegate 在结构上主要围绕 4D Tensor 设计,一些涉及三维空间、时序和复杂 Transformer 结构的模型需要额外处理。ML Drift 开始原生支持 5D Tensor,为 3D 卷积、空间模型以及时空模型提供更直接的 GPU 执行路径。

03
对大模型,重点已经从“算得快”变成“数据少搬”
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图7

ML Drift 里更值得边缘 AI 从业者注意的,其实是针对 LLM 的优化。
Google 没有简单地给所有推理阶段套同一组 Kernel。
它会根据当前处于 Prefill 还是 Decode 阶段,动态选择不同的 Kernel 和数据布局。
到了 Decode 阶段,ML Drift 还会调整 KV Cache 布局,并在 Kernel 内做激活量化,减少不必要的数据往返。
这个方向并不意外。
端侧算力一直很贵,但很多时候,更贵的是数据搬运。
模型越来越大以后,决定实际体验的已经不只是 GPU 有多少 TOPS,也包括显存怎么用、Tensor 怎么排、算子能不能融合、KV Cache 怎么管理,以及中间数据到底搬了多少次。
这也是端侧大模型和过去传统 CV 模型很大的区别。
硬件参数相同,并不意味着最终的推理体验相同。
Runtime、编译器和内存系统正在越来越直接地决定一颗芯片最后能跑出多少能力。
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图8
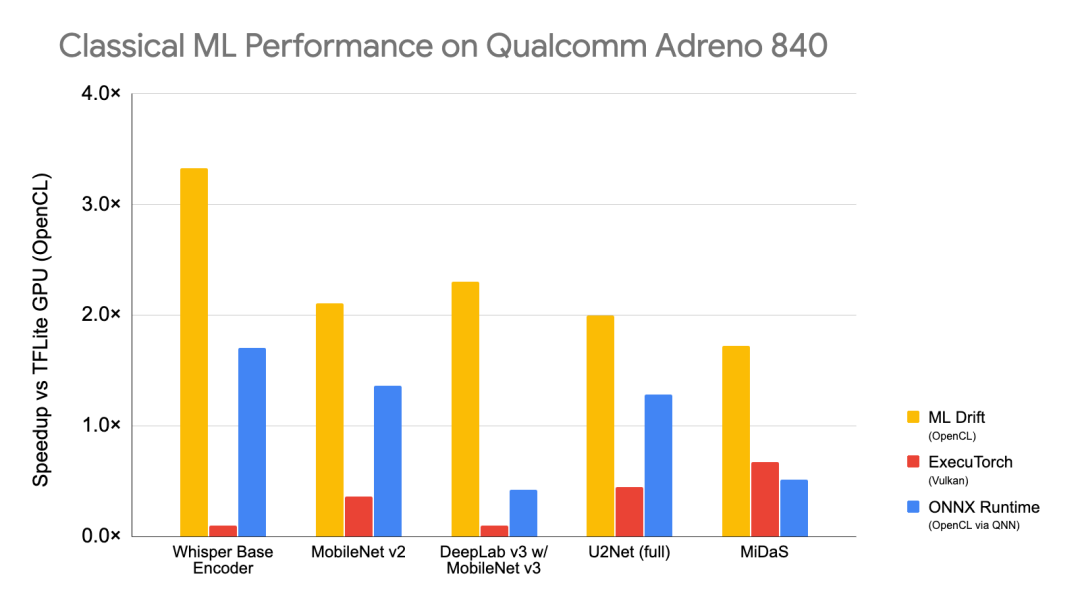
图:ML Drift 与其他端侧推理框架在 Qualcomm Adreno 840 上的部分传统 ML 模型性能对比

04
Google 已经把它用到了真实产品里
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图9

ML Drift 并不是刚开源出来的实验项目。
按照 Google 的说法,这套技术已经运行在每天数百万台设备上,被用于 Chrome、YouTube Shorts、Google Photos、Google Meet 等产品。
Google 给出了一组实际部署数据。
  • YouTube Shorts 将基于分割模型的特效迁移到 ML Drift 后,在 Android 和 iOS 上,平均帧延迟最高降低 40%。
  • Google Photos 在部分计算摄影和图像分割流程中使用 ML Drift,相比旧 GPU delegate,部分处理最高缩短约 2 秒。
  • Adobe Lightroom 和 Photoshop 的 Select Subject、Select Sky、Adaptive Portrait 等端侧 AI 功能迁移后,Google 给出的数据是性能最高提升约 30%。
  • Snapchat 的部分人脸和风格生成特效,则获得了约 30% 的模型延迟改善。
  • 在 Google 公布的 Gemma 测试中,ML Drift 的内存开销最高还可以降低约 12%。
这些数字需要客观看。
它们来自 Google 及合作伙伴公布的测试结果,并不意味着换成 ML Drift 后,任何模型、任何芯片都能得到相同提升。
GPU 型号、驱动、模型结构、量化方式和具体后端都会影响结果。
不过,ML Drift 并不是突然出现的。
今年 1 月 Google 在介绍新版 LiteRT 时就已经披露,基于 ML Drift 的新 GPU 路径,在一组模型测试中平均性能达到旧 TFLite GPU delegate 的约 1.4 倍。
所以这次开源,更像是把一套已经进入 Google 产品体系的 GPU Runtime 正式推向外部开发者。

05
有了 NPU,为什么 Google 还在重投入 GPU?
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图10

这是 ML Drift 背后一个很有意思的问题。
今天手机和 PC 芯片都在强化 NPU。
那么,为什么还要花这么大力气重新做一套 GPU 推理引擎?
原因并不复杂。
NPU 的能效通常很有优势,但碎片化问题也更加明显。
不同芯片厂商有自己的编译器、算子支持、SDK 和部署工具链。对于已经固定下来的模型,NPU 可以做到很高的效率;但对于结构变化很快的新模型,跨平台适配并不轻松。
GPU 则处在另一个位置。
它不一定永远是单位功耗下性能最好的加速器,但覆盖面足够广,计算能力足够通用,而且从手机、PC 到浏览器已经形成相对成熟的软硬件体系。
尤其是在生成式 AI 模型高速变化的阶段,这种通用性很重要。
所以 ML Drift 并不是在告诉行业“GPU 将取代 NPU”。
实际上,Google 自己的 LiteRT 也在同时加强 NPU,并且把 CPU、GPU、NPU 放到统一的端侧推理体系里。
更合理的方向是:
不同任务,交给最合适的计算单元。
GPU 承担更通用、更灵活的计算;NPU负责能够充分发挥专用硬件优势的任务;CPU继续处理控制、调度以及部分轻量计算。
未来端侧 AI 的竞争,很可能不是某一种处理器单独胜出,而是谁能把这些异构算力真正调度起来。

06
真正值得关注的,是 Runtime 开始成为竞争核心
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图11

如果把 ML Drift 放到过去两年 Google 的动作里看,路线会更加清楚。
2024 年,Google 把 TensorFlow Lite 更名为 LiteRT。
当时变化更多还是品牌和定位:从 TensorFlow 体系里的轻量 Runtime,走向一个支持 TensorFlow、PyTorch、JAX 等不同模型来源的通用端侧运行时。
到了 2026 年,这个变化开始进入底层。
新的 CompiledModel API、GPU 加速、NPU 接入、Zero-copy、异步执行,以及现在独立开源的 ML Drift,实际上都在做一件事:
把过去针对“小模型”的端侧推理栈,升级成能够承载生成式 AI 的系统软件栈。
这件事对边缘计算行业同样值得关注。
过去谈边缘 AI,大家最容易比较的是芯片。
多少 TOPS、多少核、多少显存、多少功耗。
这些当然重要。
但随着硬件能力继续提高,软件栈的重要性会越来越突出。
算子融合怎么做,内存怎么规划,量化怎么执行,KV Cache 怎么管理,不同加速器之间怎么切换,数据能不能 Zero-copy,驱动差异怎么屏蔽……
这些事情最后都会变成真实的延迟、功耗和成本。
同样一块芯片,不同 Runtime 跑出来的结果完全可能是两回事。
这也是为什么,今天再看边缘 AI,不能只盯着模型和芯片。
中间那层过去不太被普通用户注意的系统软件,正在成为新的竞争焦点。

07
ML Drift 也没有消灭碎片化
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图12

当然,开源一个统一 GPU Runtime,并不意味着端侧 GPU 的碎片化从此消失。
Google 官方文档本身就能看到这种差异。
目前 LiteRT 在 Android 上主要对应 OpenCL 和 OpenGL,在 macOS 上使用 Metal,在 Linux 和 Windows 上则更多依赖 WebGPU,并分别落到底层 Vulkan 和 Direct3D。
统一的是上层接口,底层硬件和驱动仍然不同。
这意味着真正部署时,开发者依然需要在自己的目标设备上测试。
尤其是大模型。
模型能不能放进去只是第一步。首 Token 延迟、持续生成速度、内存峰值、温度、功耗、长时间运行后的降频,这些指标才会共同决定产品是否可用。
ML Drift 解决的是一个重要问题:
尽量降低开发者面对这些差异时的工程成本。
它并没有让差异本身消失,这点可能比单纯宣传“跨平台”更加重要。

08
写在最后
谷歌突然开源!端侧 AI 的 GPU 底座,要变了图13

过去端侧 AI 比较像一个模型部署问题。
训练一个模型,压缩一下,量化一下,再想办法放进设备。
随着生成式 AI 进入手机、PC、汽车、机器人和各种边缘终端,这套逻辑正在发生变化。
模型只是其中一部分。
Runtime、编译器、内存、GPU/NPU 调度、驱动、功耗控制,正在重新进入舞台中央。
Google 开源 ML Drift,就是这个变化里的一个信号。
它真正要解决的,不是“GPU 能不能跑 AI”,这个问题早就解决了。
现在的问题是:
面对越来越大的模型和越来越复杂的硬件环境,端侧 AI 能不能稳定、高效、跨平台地跑起来。
从这个角度看,ML Drift 值得关注的并不是一个新项目的名字。
而是端侧 AI 的竞争,正在从“谁有模型、谁有芯片”,继续向下走。
走到 Runtime,走到系统软件。
也走到那些真正决定一款边缘 AI 产品能不能长期跑起来的工程细节里。谷歌突然开源!端侧 AI 的 GPU 底座,要变了图14


官方公告文章:https://developers.googleblog.com/ml-drift-next-gen-gpu-aiml-inference-at-the-edge/

关于科技区角:国内科技展会垂直内容策划服务商,提供从论坛内容全案策划、会展市场化IP打造到精准专业观众一站式邀约服务,以产业内容吸引高质量B端人群,打通展会从议题设计、演讲嘉宾邀约、宣传预热、精准邀观到供需对接全链路。
声明:内容取材于网络,仅代表作者观点,如有内容违规问题,请联系处理。
AI GPU 开源
more
中国 AI 硬件的下一个爆款,可能生在「网球场」
安全让位速度?Meta AI智能体Muse背后的博弈与隐忧
腾讯云将内部AI协同利器TeamAI推向开源,已打通十六款智能体工具
00后“戒断”AI短剧:一个月卸载了5次
北京大厂AI核心高管将离职;华南大厂AI Coding负责人被削权;互联网巨头AI数据负责人触碰红线,或将离职丨AI情报局VOL.26
AI赋能,支持双节点管理,适配英特尔OKS平台!赛昉RISC-V BMC方案闪耀Intel Connection大会
iBUYPOWER跨界入局迷你主机,首发AMD AI Halo高端机型
从算力竞争到词元经济:AI推动数据分层,闪存走到岔路口
个人Agent爆发,这家AI手环厂商,融资1000万美元
AI竟然在实体书里说话!出版社:立即销毁
Copyright © 2025-成都区角科技有限公司
蜀ICP备2025143415号-1
  
川公网安备51015602001305号