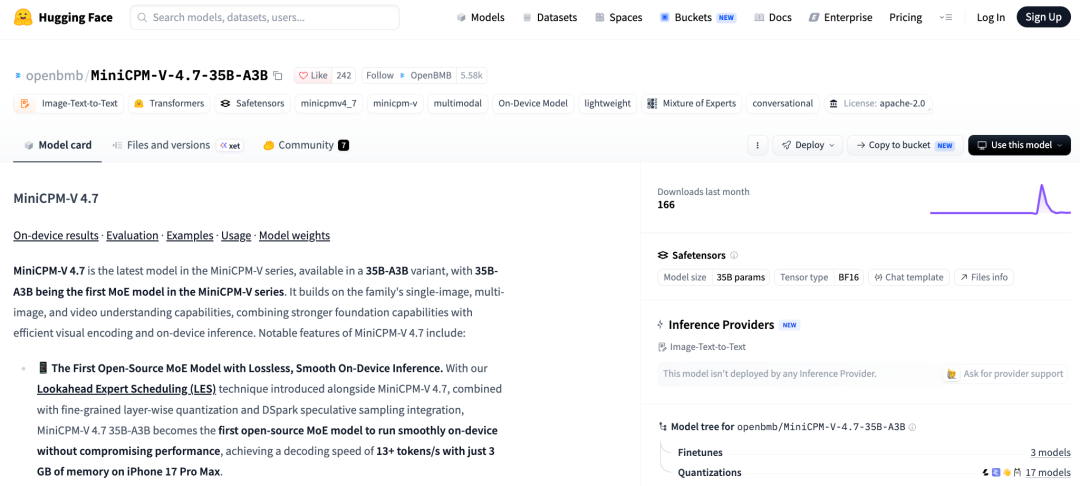
智东西10月13日报道,今日,面壁智能发布新一代端侧多模态大模型系列MiniCPM-V4.7,包含35B-A3B与1B两个版本。官方称,这款35B‑A3B模型,是首个能够在手机端流畅运行、且能力无损的开源大模型。
具体来看,35B-A3B是MiniCPM-V系列首款MoE模型,总参数350亿、每次推理仅激活30亿,仅约3GB内存即可运行。其在iPad Pro实测数据显示,该模型解码速度超15 token/s,以及在iPhone 17 Pro Max上仅使用3GB内存即可实现超13 tokens/s的解码速度。

今天起,该模型便支持瑞芯微、英伟达、英特尔和苹果等国内外主流芯片平台,同时支持iOS、安卓和鸿蒙系统,并提供开源端侧适配代码及主流推理框架。
另一个1B版本模型主打提升端侧效率,实际参数1.3B。根据面壁智能的测试结果,在指令模式下,1B版本在基础功能方面较MiniCPM-V4.6有所提升,并且在总体得分和推理效率方面优于Qwen3.5 0.8B。
截至目前,由面壁智能联合OpenBMB开源社区发布的MiniCPM系列开源模型,全球累计下载量已突破6000万次,覆盖文本、视觉、语音全模态。
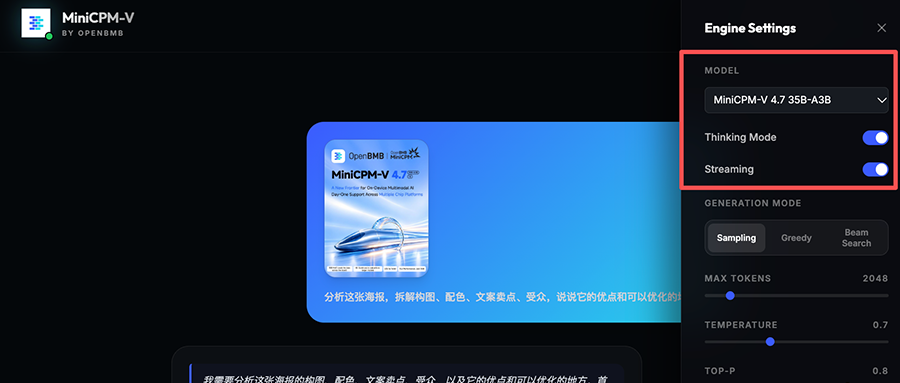
智东西通过面壁智能提供的在线演示平台体验了MiniCPM-V4.7 35B-A3B模型。
我们上传了一个餐厅墙上的英文菜单图片,让模型进行翻译并给出具体的用餐建议。从下方的动图可以看出,35B-A3B模型的生成速度很快,按照图片上的分类对菜单进行了翻译,并按照不同的需求给出了建议,如用户只想喝点东西、吃点轻食、有酒精需求等,可以选择哪些食物。

接着我们上传了MiniCPM-V4.7系列模型的发布海报,让其分析这张海报,拆解构图、配色、文案卖点、受众,说说它的优点和可以优化的地方。
在十余秒时间内,模型逐条拆解分析了上述要点,并在最后生成了一个可视化的表格。


从具体的基准测试结果来看,MiniCPM-V4.7 1B在General通用图文理解、Document/OCR/文档图表分析、多图理解方面更占优势。
此外,长视频时序理解方面,MiniCPM-V4.7 1B的表现超过了V4.6、Qwen、LFM、Gemma。

MiniCPM-V4.7 35B-A3B的基准测试结果显示,其在通用图文、STEM数学、OCR文档、视频理解方面均超过了Qwen3.6 35B-A3B,仅在RefCOCO上得分略低。


MiniCPM-V4.7系列模型的核心突破,得益于面壁智能自研的LES(前瞻专家调度)技术,以及细粒度的逐层量化和DSpark推测性采样集成。
MoE模型总参数大于单次推理激活的参数,但端侧不能只存激活参数。不同token会调用不同层的不同专家,设备内存通常装不下全部专家权重。
一种思路是把权重放在SSD上按需加载、用完释放,但频繁加载会拖慢解码,达不到实时交互要求;另一种办法是缩小可用专家池,给整条提示词固定一批专家,减少加载次数,但缺点是后续token只能从这批专家里选,会漏掉本该选中的专家,降低模型效果。
针对上述挑战,面壁智能提出了三种互补技术:
前瞻专家调度(LES):利用跨层路由预测来预加载下一层可能需要的专家。在实际路由器选择的专家中,LES会优先处理那些成功预取的专家,并将它们计算与加载剩余所需专家的计算重叠进行。预测仅指导预取和调度;计算仍然遵循模型原有的token级路由,预测遗漏的所需专家也会照常加载和评估。

▲前瞻专家调度架构(图源:面壁智能)
细粒度的逐层量化:减少专家权重的存储空间和内存流量,同时保持模型能力,使专家加载更适合设备内存和带宽限制。
DSpark推测性采样集成:将推测性采样融入到设备端推理过程中,与专家调度和量化技术协同工作,以提高解码效率。





