今天 DeepSeek 重磅发布了 V4.1 Flash 1017。按照官方介绍[1],这次更新通过基于自反馈的强化学习,增强从零开发游戏、搭建 3D 项目的能力,并向我们展示了故宫建模等非常出色的案例。“许愿式编程”的边界,正在向三维空间延伸。
3D 创作的一个潜在机会,是把建模、检查、按反馈修改串成可执行的流程。如果智能体能在达到交付要求的前提下,减少人工操作和返工,就可能带来实际收益。这是一个需要验证的价值假设,关键证据应来自与现有工具、人工工作流的比较。
围绕这些环节,在过去几年里,3D-GPT[2] 探索用大语言模型驱动程序化建模,BlenderGym[3] 将图形编辑纳入评测,Autodesk 等提出的 neuralCAD-Edit[4] 则收集了十位专业设计师的 CAD 修改请求。这些工作逐步提供了任务样本与能力评测方法。
最近,千问团队开源了 BlenderWorld,该工作把评测推进到交付环节:给定参考和规格,智能体能否交出符合要求、可以继续编辑的工程?它提供的验收结果,可以帮助识别哪些工作已经能够完成、哪些环节仍需人工介入,为后续比较效率和成本提供基础。

论文:BlenderWorld: Benchmarking Visual Agents for 3D Creation from Real-World References
作者:Xinyu Fang、Yuchi Wang、Weihao Yu 等;通讯作者:Dahua Lin、Guofeng Zhang、Zhibo Yang
单位:浙江大学、阿里巴巴集团 Alibaba Token Hub、香港中文大学、复旦大学、南洋理工大学
论文链接:https://github.com/QwenLM/BlenderWorld/blob/main/docs/BlenderWorld__Benchmarking_Visual_Agents_for_3D_Creation_from_Real_World_References.pdf
开源仓库:https://github.com/QwenLM/BlenderWorld
背景:一张漂亮效果图,离完整工程还有多远
实际的 3D 创作请求往往同时包含外观、结构和用途要求:根据照片重建室内空间,按指定尺寸调整家具,或者参考一段视频制作带运动效果的场景。智能体需要理解参考材料、操作软件、检查结果,再连续修改。
难点在于,这类任务通常没有唯一的标准模型。两份结构不同的工程可能都满足需求;同样,一张渲染图看起来不错,背后的物体却可能没有厚度、悬在空中,或缺少指定的骨骼与动画。
BlenderWorld 选择开源三维创作软件 Blender 作为环境,要求提交可编辑的 .blend 工程以及规定的图像、视频等产物。评测对象由此扩展为整个创作过程最终交付的工程。
创新点:把开放需求拆成可以验收的条件
基准包含 223 项任务 ,覆盖 9 个大类、22 个子类和 16 种应用场景,包括建筑与室内、产品、角色动物、自然环境和科学可视化等。其中 78 项以文本为输入,130 项附图像、15 项附视频;59 项还提供尺寸、材质、相机参数等规格文件。
参考材料承担三种作用:
重建强调保留主要形状和空间关系; 修改要求保留指定结构并完成变化; 参考设计则借用造型、风格或布局,发展新方案。

这些任务由筛选的参考材料和应用场景出发,经多模态模型辅助生成需求,再检查文件可用性、图文对应和约束一致性。它们模拟现实创作请求,并经过专门的验证流程。
更关键的是 2,651 条二元验收条件 :每项任务有 6—22 条,分别检查几何、功能、材质、布局、物理关系等要求。重要程度对应 3、2、1 的权重。条件经过独立模型复核和试评后冻结,对生成智能体隐藏。
方法:多角度看效果,打开工程查结构
交付完成后,评测系统重新打开工程,按任务选择 8 个互补视角进行渲染。它可以调整相机与渲染设置,但须保留提交作品的几何、材质、灯光和动画,不能替参评系统修复模型。
随后,验收条件按证据类型分流。
外观、布局和运动由视觉语言模型结合新视图、原始导出图及视频帧判断; 物体结构、工程属性等要求,则由另一个智能体调用工具检查原生文件。
全部条件中,58.2% 需要场景检查 ,单靠观看渲染图无法完成验收。

系统另外评估保真度、物理合理性、比例尺度、灯光材质等 8 个视觉质量维度。
最终综合分由“加权验收得分”和“视觉质量得分”各占一半组成;缺少工程文件或评测失败的任务记零分。
这套设计将“需求完成了多少”和“整体观感如何”一起纳入评价,并为不同要求保留了对应的检查证据。
实验:综合分领先,全部要求通过仍不到一半
论文比较了 13 个参评系统,每个系统对每项任务运行一次。它们使用隔离的 Linux、GPU 和 Blender 环境;GPT-6-Astra、GPT-5.6-Sol 配合 Codex,其余系统配合 Claude Code。
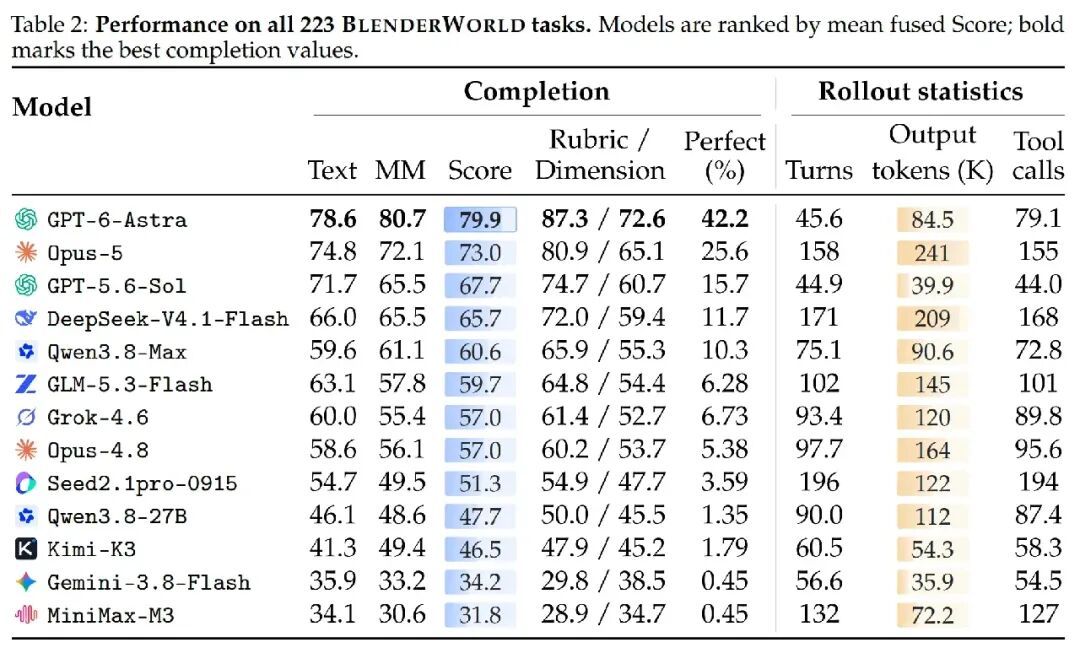
全要求通过率指通过该任务全部二元验收条件的任务占比。排名第一的 GPT-6-Astra 完成了 94 项完整验收;如果将门槛放宽到加权验收得分达到 90%,则有 143 项达到要求(总任务数为 223,占比 64.1%)。接近完成与逐项满足要求之间,仍有明显距离。
GPT-6-Astra 在展示的 9 类任务中领先 8 类,程序化与游戏资产、产品制造类得分较高;Opus-5 则在渲染与仿真类领先。模型的强项随任务类型变化。
论文还发现,更多工具调用没有直接对应更好结果:GPT-5.6-Sol 与 DeepSeek 在多模态任务上同为 65.5 分,平均工具调用却分别为 44 次和 168 次。由于框架和调用策略同时存在差异,作用机制仍需进一步实验拆分。
(这里的 DeepSeek 成绩来自 10 月 16 日的论文,1017 更新后的表现尚待重测。)
分析:看过结果、自检通过,为什么仍会出错
失败轨迹比榜单更能解释当前的瓶颈。
一个任务要求制作有人检查大豆的三维场景,GPT-6-Astra 将照片中的人物裁出,贴到平面上。提交视角里人物存在,转到侧面便几乎消失。另一个强制透视任务中,GPT-5.6-Sol 精确检查了鞋尖与远处塔楼的投影对齐,却遗漏人体接地,最后人物仍悬在草地上方。
最有代表性的是 Opus-5 的尺寸自检。需求规定木腿长 150 毫米,并配黄铜脚轮;智能体在计划中将其改成“包含脚轮在内总高 150 毫米”,于是制作了 102 毫米木腿和 48 毫米脚轮,再测量组合总高,报告通过。外部验收单独检查木腿,发现它比要求短了 32%。

这些案例显示,智能体已经能够执行检查,但检查对象、测量目标和需求理解仍可能偏移。增加观看和验证动作,并不会自动补齐正确的三维约束。
验证与展望:裁判可靠性、评分稳定性与后续方向
论文包含裁判验证和评分权重敏感性分析。作者抽取 150 组作品对,请三位人工评审比较;在形成多数判断的 147 组中,主裁判 GPT-5.6-terra 与人工结果一致率为 82.99% 。在分差较小的 70 组作品中,一致率降至 68.57% ,相近作品的区分更困难。
作者还将验收得分权重从 0 调到 1,比较五种设置。除 Grok-4.6 与 Opus-4.8 的第七、第八名互换外,排序保持稳定。这项分析检验的是评分配方的敏感程度。
在后续实验中,作者计划比较同一模型在不同推理设置或智能体框架下的表现,记录资源预算、词元用量、延迟、工具调用与成本,并通过重复运行估计结果波动和排名稳定性。
任务与评测方面,作者计划增加局部修改、网格修复、拓扑处理,以及对已交付工程的再次修改;引入工程图、尺寸公差和几何约束检查,并邀请专业三维艺术家校准验收标准。
DeepSeek-V4.1-Flash-1017 官方介绍: https://api-docs.deepseek.com/zh-cn/news/news261017/
[2]3D-GPT: https://arxiv.org/abs/2310.12945
[3]BlenderGym: https://blendergym.github.io/
[4]neuralCAD-Edit: https://arxiv.org/abs/2604.16170
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群