RoboPrompt团队 投稿
量子位 | 公众号QbitAI

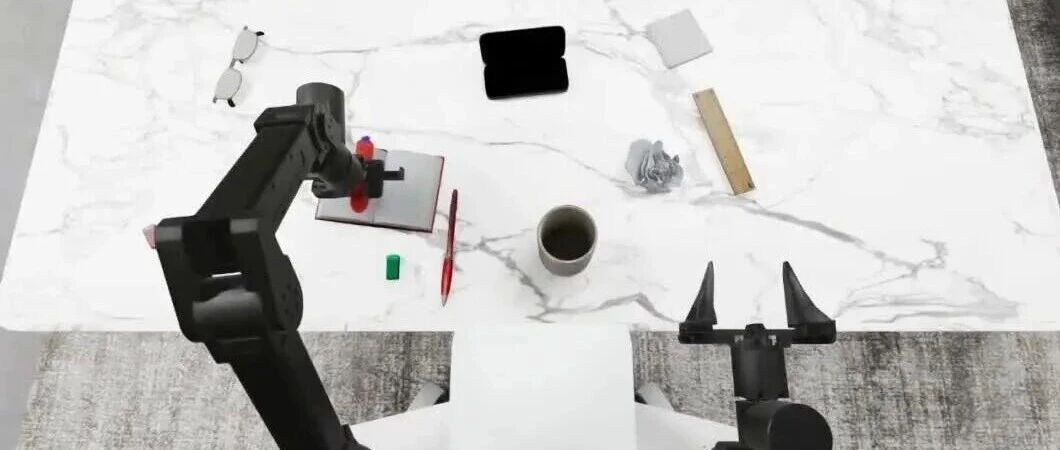
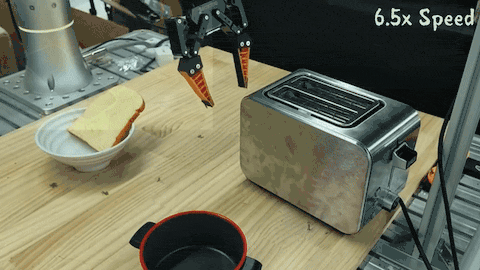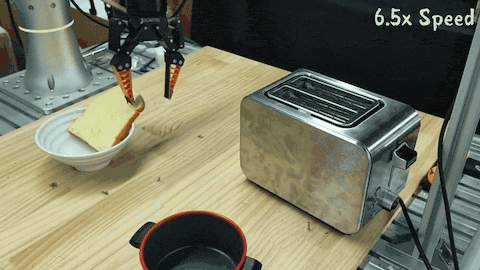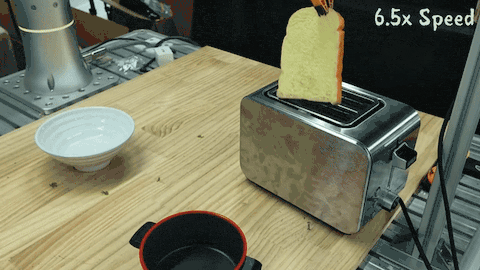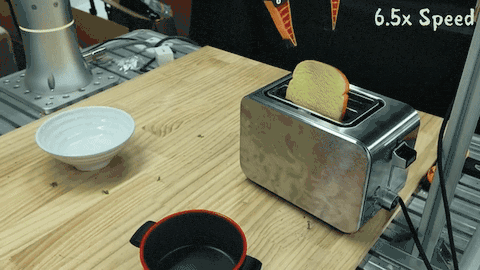
看着机器人抓偏了杯子、迟迟对不准面包机的插口,人们可能会忍不住提醒:“往左一点,再往前一点。”这些对人类来说再简单不过的调整,对机器人却未必容易。
更让人着急的是,人类看出了问题,却未必能顺手帮它一把。端到端策略自主执行过程,往往缺少让普通人方便介入的入口。机器人一旦做错,用户就容易陷入“知道该怎么做,却不知道怎么教它”的困境。
RoboPrompt希望解决的正是这个断点:让用户像在图片上画线、点位置或说一句方向指令一样,直观地“提示”机器人下一步该怎么动。
系统不要求修改底层策略结构,也不要求把策略重新训练成专门的可引导模型,而是在推理时把稀疏人类输入转成动作草稿,再交给原有策略细化执行。

△RoboPrompt整体框架:系统支持点选、轨迹、方向指令等直观输入,并将人类引导数据用于后续策略改进。
核心思路:把人类意图变成可执行动作

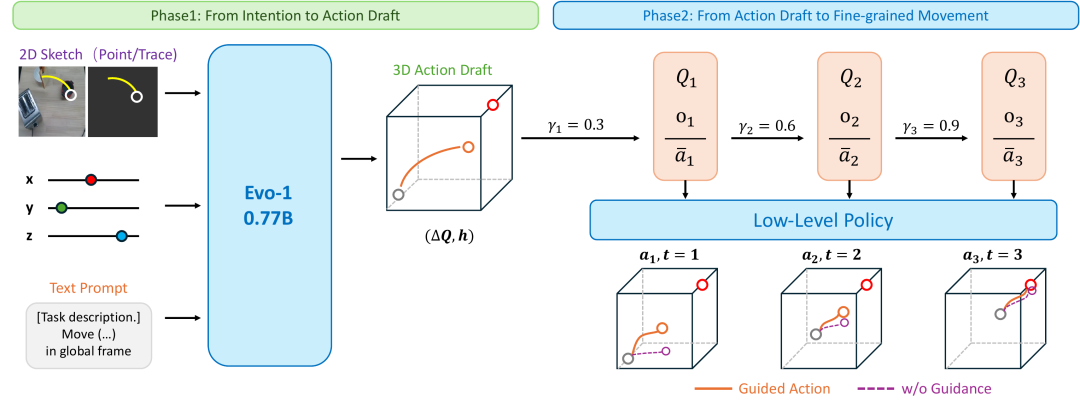
RoboPrompt采用两阶段设计。第一阶段负责“理解人类意图”,第二阶段负责“把意图放回策略能力范围内”。这样做的好处是,用户输入可以非常稀疏,但最终动作仍由经过真实数据训练的底层策略校准,从而兼顾可控性与可执行性。
从点、线和方向指令生成动作草稿
第一阶段使用一个0.77B参数量的轻量VLA模型Evo-1作为意图翻译器。用户可以在相机画面上给出目标点,表示末端执行器接下来应到达的位置;也可以画出一段轨迹,表示希望机器人沿某条路径移动;还可以输入全局方向提示,例如“向左移动一点”。模型会把这些输入转换为连续的6D动作块,也就是后续细化过程的动作草稿。
为了训练这个翻译器,研究团队没有依赖额外人工标注,而是从已有轨迹中自动生成“事后提示”:将未来TCP位置投影到图像上,形成点和轨迹标签;将未来一段时间内的位移累计并归一化,形成方向提示标签。训练时还加入随机位置和尺度扰动,使模型适应真实用户不精确的输入。
用底层策略细化动作,而不是替换策略
动作草稿虽然体现了人类意图,但可能缺少抓取、避碰和接触等低层细节。RoboPrompt的第二阶段利用扩散或流匹配策略的去噪过程进行融合:把动作草稿加到某个噪声水平,再由底层策略从该状态逐步去噪,得到更贴合任务和动力学约束的动作。
其中,Progressive Biased Denoising(PBD)提供了一个关键控制量:去噪水平γ。γ越小,动作越跟随人类输入;γ越大,动作越回到策略先验。对于一个持续时间超过单个动作块的提示,RoboPrompt会让γ随重规划次数逐步增大:先强跟随用户意图完成纠偏,再逐渐把控制权交还给原策略。

让控制权平滑过渡:NA-FRS

直接加噪并不能保证“人类意图—策略先验”之间线性可控。实验显示,很多扩散和流匹配策略在少量去噪步内就会产生很大动作变化,后续变化反而较小。为此,Noise Augmented Flow Reversal Steering(NA-FRS):先沿策略动力学从动作草稿反向推到目标噪声水平,再混入可控比例的随机噪声。
用文本描述其效果就是:先尽量保留第一阶段动作草稿中的信息,再随着γ增大逐步恢复纯策略去噪行为。这样,用户画出的轨迹不会被策略立刻“抹掉”,策略自身的任务知识也不会被完全覆盖。

用TOT筛选可用于DAgger的数据
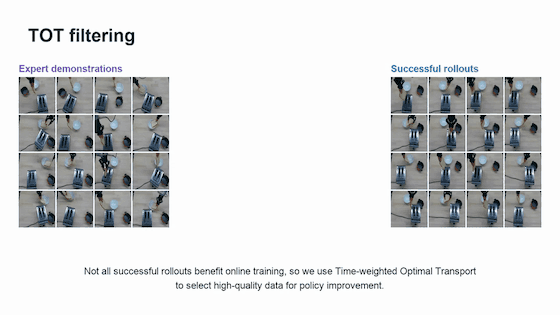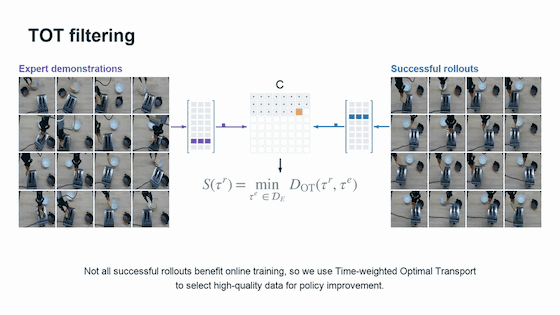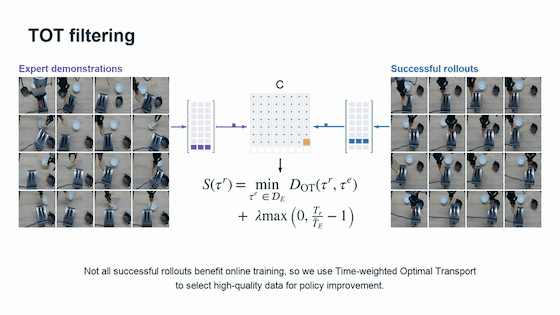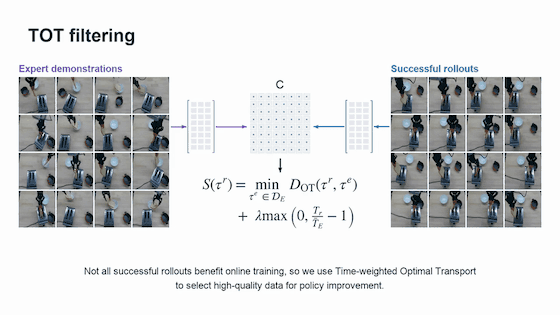
RoboPrompt不仅用于即时纠偏,还把成功的引导轨迹用于后续策略改进。但“成功”并不等于“适合训练”:有些轨迹可能包含抖动、重复夹爪动作或绕远路,直接加入DAgger会让模仿学习得到不一致的监督。
因此,论文引入Time-weighted Optimal Transport(TOT)作为筛选指标。它比较引导轨迹与专家示范在策略嵌入空间中的相似度,同时惩罚过长执行时间。只有既接近专家行为、又没有明显冗余动作的成功轨迹,才会进入下一轮在线训练。
实验结果:更高成功率,更少人工干预
实验平台为FlexivRizon4机械臂和Robotiq2F-85夹爪。研究团队在Diffusion Policy、π0.5和FastWAM三类底层策略上验证RoboPrompt。首先,在Insert Bread多目标场景中,RoboPrompt能把原本偏向某些目标的多模态策略引导到指定目标。三类策略的Prompt Alignment均超过95%,说明机器人动作能够稳定遵循人类提示。
在更关键的在线改进实验中,RoboPrompt通过多轮DAgger持续提升策略。以π0.5为例,在Insert Bread、Hang Cup和Push Ball三个真实任务上,2—3轮迭代后平均成功率提升15.5%,平均人工干预次数从2.86次降至1.60次,减少44.0%。在Insert Bread任务上,跨Diffusion Policy、π0.5和FastWAM三种策略的平均成功率提升21.3%,干预次数从2.60次降至0.47次,减少81.9%。

论文还进行了小规模用户研究。6名此前没有使用经验的志愿者,在5分钟介绍后即可完成面包插入任务,平均任务进度达到86.4%,接近熟练用户的86.7%,并显著高于无引导基线59.3%。差异主要体现在干预次数:新用户平均需要5.17次,熟练用户为2.72次,说明界面直观易上手,但使用经验仍能帮助用户更早预判失败。

项目价值:把部署失败变成持续改进数据
RoboPrompt的价值不只是让机器人“听得懂提示”,更重要的是建立了一个部署闭环:机器人自主执行,用户以极低成本纠偏,系统收集高质量引导轨迹,再通过DAgger提升下一轮策略。这把真实部署中的失败从风险转化为数据来源,有助于缓解机器人长期面临的真实交互数据稀缺问题。
从工程角度看,RoboPrompt的可复用性也很关键。它不绑定单一策略架构,已经在扩散策略、VLA和WAM类策略上验证;输入方式也贴近普通用户习惯,避免了专业遥操作设备的门槛。对于家庭服务、仓储分拣、柔性制造等需要人机协作的场景,这类轻量级可引导接口可以显著降低机器人落地成本。
论文:https://arxiv.org/abs/2610.10534
项目网页:https://yanwen-zou.github.io/Roboprompt-Website/
Github:https://github.com/yanwen-zou/Roboprompt
作者团队:Yanwen Zou、Chenyang Shi、Guoxuan Xu、Wenye Yu、Wendi Chen、Ye Pan、Cewu Lu、Chuan Wen。
这项工作来自上海交通大学卢策吾/汶川团队。第一作者邹砚文是上海交通大学与上海创智学院联合培养的博士二年级学生。
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
【学术投稿】请在工作日发送邮件至:ai@qbitai.com,标题注明【投稿】,并告诉我们:你是谁,从哪来,投稿内容附上项目/主页链接,以及联系方式。
🌟 点亮星标 🌟