玩一款没有教程的新游戏,难点常常是逐步摸清规则:点过哪里,画面发生了什么变化,刚才不起眼的标记,是否后来才显出作用。对于多模态智能体,这也意味着一项能力:需要时,能够重新查看已经见过的画面。
最近,MIT 何恺明团队提出的 VISTA,将这种“回头看”的能力做成了模型与环境之间的交互框架。它保留原始视觉记录,让模型自行选择回看时间、画面区域和细节尺度。在 ARC-AGI-3 的 25 个公开游戏上,搭配 Claude Opus 5.0 和 GPT-5.6 Sol 的系统都完成了全部游戏;相比之下,两者在不使用 VISTA 框架下的官方评测得分分别只有 40 和 13 分!
论文:VISTA: A Visual Harness for Reasoning in an Interactive World
作者:Qiushi Han、Keya Hu、Linlu Qiu、Cathy Wu、Kaiming He
单位:麻省理工学院
论文链接:https://arxiv.org/abs/2610.02200
开源仓库:https://github.com/joshhhhhan/VISTA
项目主页:https://vista-research.github.io/
背景:看过的画面,未必能在需要时找回来
ARC-AGI-3 将抽象推理变成了交互游戏。智能体开始时只有当前画面和可用动作,没有明确的规则或目标说明,需要通过探索推断物体作用、状态变化和获胜条件。同一游戏的后续关卡,还会在既有机制上加入新元素。
此前一些方案将画面转换成数字网格,再通过程序重建游戏规则。多模态模型虽然可以直接看图,但长时间交互仍面临记忆问题:早期视觉信息可能被编码成不够细致的表示,也可能在上下文压缩时被文字摘要替代。
一张截图刚出现时,模型未必知道哪个细节以后会有用。VISTA 因此将完整视觉历史留在模型上下文之外,并提供随时取回的接口。
创新点:把“看哪里、回看哪一刻”交给模型
VISTA 的核心由三部分组成:直接观察图像、无损视觉记忆,以及模型主导的视觉检查。
在默认 ARC-AGI-3 设置中,模型读取的是 512×512 的 PNG,由官方 64×64 游戏画面通过最近邻放大得到。画面中的形状和空间关系直接进入视觉输入,模型用自然语言理解规则和规划行动。
环境返回的每一帧,包括动作触发的中间动画帧,都会按回合和帧号保存。这里的“无损”,指外部档案保留收到的原始视觉信息,模型可以重新调取需要的部分。
工具 inspect 支持取回历史帧、同时比较多个时刻,或裁出局部区域放大观察。read_pixels 则进一步提供选定区域的精确颜色样本,帮助处理肉眼式观察不够可靠的细小色块或边界。查看什么,由模型依据当前问题决定。
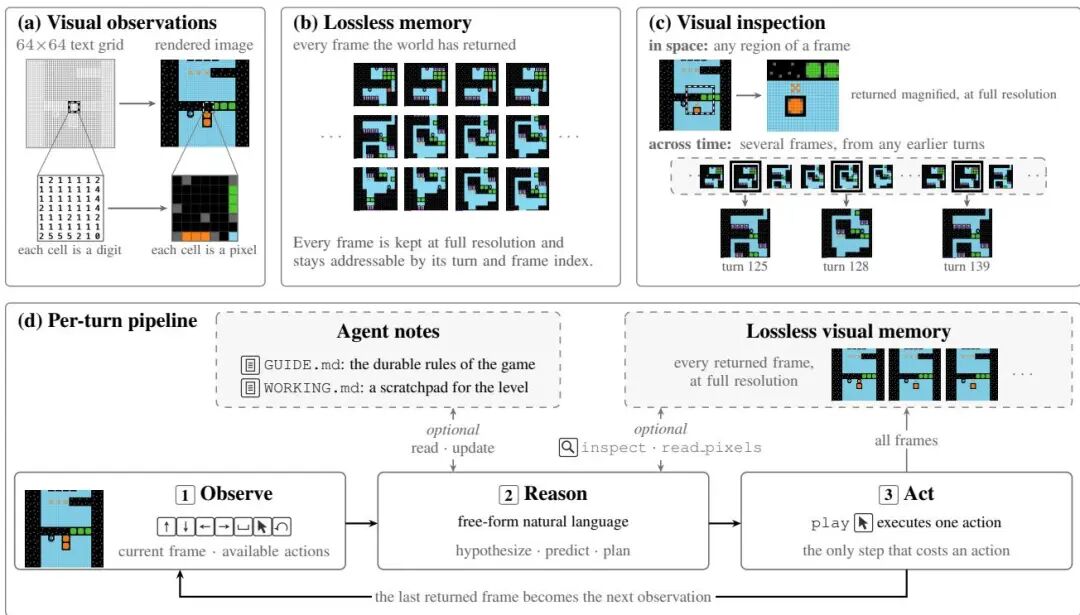
整个过程由同一个智能体持续完成。每回合先观察当前状态,必要时回看历史、更新笔记,再预测动作结果并调用 play。框架负责存档、执行动作和返回工具结果,核心推理由已有多模态模型承担,VISTA 本身没有额外训练一个模型。
方法:既能回到过去,也能看清局部
论文中的两个案例,具体展示了视觉记忆的用法。
一个游戏重置后,智能体在一次 inspect 调用中取回此前 22 个回合内的四帧画面,结合不同位置和状态,重新理解地图。另一个任务中,三个小方块的朝向取决于紫色标记位于哪一侧;智能体将对应区域放大约 13 倍,才辨认出这些局部差异。

这两种检查对应不同需求:跨时间找回已经离开当前视野的信息,以及提高对当前细节的观察精度。历史画面无需全部堆进上下文,而是在推理遇到具体问题时重新进入视野。
代码:存档、检视与上下文续接如何落地
对照公开代码[1],这套机制已经落实为可调用的工具和持久化状态。ARC-AGI-3 控制器会将一个动作返回的每帧分别保存为 PNG,文件名包含回合与帧号;默认只将最后一帧作为下一次观察,其余画面保留在档案中。
核心工具定义[2]规定了两类检视:inspect 按指定回合、帧和矩形区域取图,不做平滑插值;read_pixels 将选定区域划成网格,读取各格中心像素,返回颜色表和紧凑的采样结果。二者均不改变游戏状态,解释这些证据仍由模型完成。
文字记忆分成两个文件:GUIDE.md 记录跨关卡可复用的规则理解,WORKING.md 保留当前状态与计划。上下文接近上限时,系统要求先保存续接信息,再从当前游戏状态继续;原始画面、笔记和动作历史仍然可访问。
仓库提供 Codex 与 Claude Code 两类运行后端,并包含 ARC-AGI-3、GameWorld、AI GameStore 和 BabyVision 的适配及批量脚本。公开运行说明使用 Linux、Python 和 Docker 等环境,这套框架的边界也由具体环境接口和底座模型共同决定。
实验:满分表现背后,哪些组件发挥了作用
论文采用 RHAE 衡量完成情况和相对首次人类玩家的动作效率。只读检视与推理不计入游戏动作。VISTA 搭配 Claude Opus 5.0、xhigh 推理强度时达到 100.00 分;搭配 GPT-5.6 Sol、max 推理强度时达到 99.00 分。两者都完成了 25 个公开游戏。
GPT-5.6 Sol 的逐级配置实验,呈现了性能如何变化:

这组实验固定 GPT-5.6 Sol 与 max 推理强度,逐级配置使用统一的 CLI 接口;官方 13.33 分来自 API 实现,作为外部参照。预算扩展允许每个游戏最多 2,000 次动作、48 小时。最后两级改为自动返回动作末帧,其余画面按需调取。
视觉记忆与检查加入后,得分从 70.05 提高至 94.10;再加入像素读取,提升至 99.00。论文同时比较了完整框架下的输入表示:文字网格与图像的得分分别为 96.75 和 99.00,平均每游戏词元用量则为 7,190 万和 3,070 万。
上下文也存在成本权衡。默认 200K 上下文得到 99.00 分;缩至 100K,仅下降 0.4 分,词元用量约减半;扩至 780K,平均每游戏消耗增至 1.057 亿词元。外部视觉记忆让历史证据保持可用,上下文大小则影响持续推理的资源开销。
重复运行方面,GPT-5.6 Sol 的三次 ARC-AGI-3 结果为 99.00、98.90、99.23,均值为 99.04±0.17。开源权重模型 GLM-5.3 Flash 320B 接入完整 VISTA 后,也达到 66.93 分。
泛化:浏览器游戏、静态迷宫与三维呈现
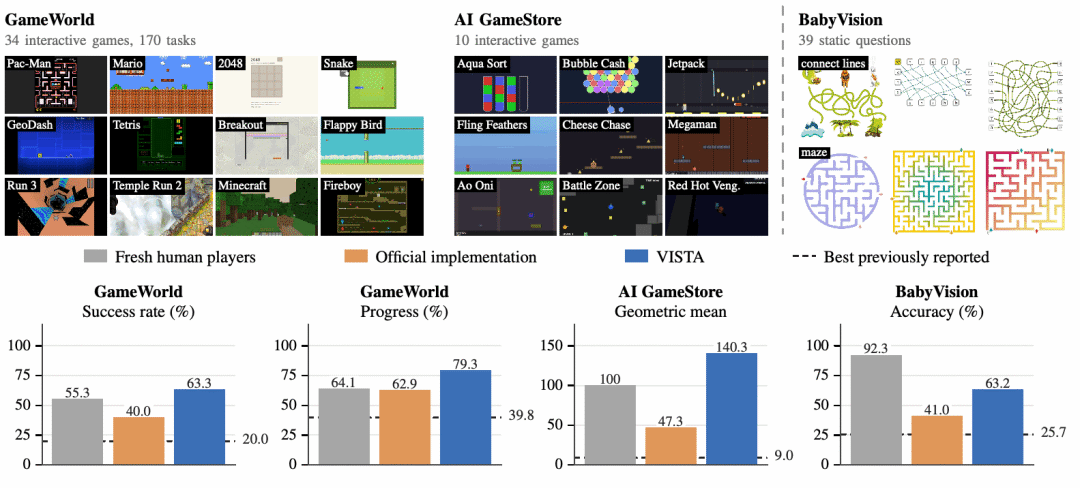
作者将相同视觉框架扩展至其他任务。GameWorld 包含 34 款浏览器游戏、170 项任务,成功率从官方实现的 40.0% 提高至 63.3%。AI GameStore 的 10 款游戏使用人类中位数归一到 100 的综合得分,VISTA 为 140.3,官方实现为 47.3。
BabyVision 实验选择了 20 道迷宫题和 19 道连线题,准确率从 41.0% 提高至 63.2%。这些静态题没有交互历史,局部放大和像素检查仍然带来收益。
将同一批 ARC-AGI-3 游戏改为三维渲染后,VISTA 得到 84.12 分,总动作数增至 20,640。视觉呈现变复杂后,系统需要更多探索,但仍能利用这套接口完成相当一部分推理。
局限与结论:视觉交互框架的收益与适用范围
作者指出,结果依赖底座模型已有的能力;框架设计与模型进步相互补充。由于所用模型的发布时间晚于公开基准,游戏进入训练数据的可能性仍无法排除。ARC-AGI-3 私有集或新游戏将提供更强的泛化检验。
本文的主要进展,是让既有多模态模型在交互过程中持续访问原始视觉证据,自主决定何时回看、比较或放大。公开游戏、浏览器操作与静态题目的实验展示了这种设计的收益;作者将更复杂、更接近物理世界的具身任务列为后续方向。
公开代码: https://github.com/joshhhhhan/VISTA
[2]核心工具定义: https://github.com/joshhhhhan/VISTA/blob/c97c354f0a8948256545a3e8850a1848f8e5b8c1/src/vista/core/tools.py
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群