点击蓝字 关注我们
欢迎各位专家学者在公众号平台报道最新研究工作,荐稿请联系小编Robert(微信ID:BrainX007); 或将稿件发送至lgl010@vip.163.com。
英文标题:Multimodal LLMs Can Learn to Read Brain Signals: A Vision-Language Model for Unified Multi-Task EEG Decoding
成果简介
BraVista 提出了一种将脑电信号接入通用视觉-语言模型(VLM)的新范式,无需任何 EEG 专属预训练即可实现统一多任务解码。 该方法将多通道 EEG 的短时傅里叶变换(STFT)频谱图按通道排列为一张结构化“脑电图像”,并配以描述数据集、任务目标与标签空间自然语言指令,通过对 Qwen3-VL-2B 进行持续后训练(全量微调视觉编码器 + LoRA 微调语言解码器),将 EEG 解码转化为指令条件化的图像理解问题。在睡眠分期(HMC)、情感识别(SEED)、认知负荷分类(EEGMAT)与异常检测(TUAB)四类异构任务上,单一 BraVista 模型均取得稳健性能,显著优于零样本 VLM 基线;控制实验进一步表明,STFT 图像是四种视觉表征中最有效的接口,而模型在渐进噪声下性能平缓退化、始终高于随机水平,证明其依赖的是 EEG 信号结构而非浅层视觉模式。这项工作将研究焦点从“设计专用 EEG 模型”转向“设计神经信号与通用基础模型之间的有效接口”,为可扩展的统一 EEG 解码提供了新思路。
主要贡献
提出 BraVista 框架:以结构化图像为接口,用视觉-语言模型实现统一多任务 EEG 解码。整合将多通道 EEG 的 STFT 频谱图按通道排列为一张结构化图像,配以自然语言任务指令,通过指令条件化的 VLM 实现单一模型跨任务的统一解码,无需为每个任务单独设计架构,也无需大规模 EEG 专属预训练。
验证通用 VLM 经后训练即可有效适配 EEG 解码。基于 Qwen3-VL-2B 进行持续后训练(全量微调视觉编码器 + LoRA 微调语言解码器),在睡眠分期、情感识别、认知负荷分类、异常检测四类异构任务上均取得稳健性能,显著优于零样本 VLM 基线,证明通用视觉-语言先验可迁移至神经信号领域。。
通过表征对比与噪声扰动实验,证明模型依赖 EEG 信号结构而非浅层视觉模式。在模型与训练流程固定的条件下,STFT 频谱图在四项任务上均优于原始时序图与头皮拓扑图;在渐进噪声下性能平缓退化且始终高于随机水平,结合类级混淆模式与嵌入聚类结构,表明模型利用的是 EEG 相关生理信息。
方法
BraVista 的方法部分可概括为以下三点,总体框架如图1所示:

图1.BraVistar框架
1)EEG 时频表征与指令构建。将多通道 EEG 信号 X 按段切分后逐通道计算 STFT,得到每通道的频谱图,再按通道排列为一张结构化“脑电图像”,保留时频联合结构;同时为每个样本构建自然语言指令-响应对,指令包含数据集背景、通道与频段说明及明确的任务规范,响应为对应真值标签,从而将 EEG 解码转化为指令跟随问题。
2)视觉-语言模型的后训练框架。 基于 Qwen3-VL-2B 进行持续后训练,保持原有架构(SigLIP-2 视觉编码器 + 视觉-语言融合器 + 语言解码器);全量微调视觉编码器以捕捉任务相关时频模式,同时以 LoRA 微调语言解码器的注意力层与 MLP 层,在适配 EEG 域的同时保留预训练语言与生成能力,实现参数高效适配。
3)多任务解码的优化目标。将多任务 EEG 解码形式化为多模态输入上的条件生成问题:给定脑电图像 与文本指令 ,模型以自回归方式生成输出序列 ,训练目标为监督微调的负对数似然损失 ;梯度同时回传至视觉编码器与语言模型的 LoRA 参数,实现视觉与语言表征的协同适配。
研究结果

图2.跨四项 EEG 任务的统一解码。 (a) BraVista 与监督模型、EEG 基础模型、NeuroLM 及零样本 VLM 骨干的平衡准确率对比。(b) 混淆矩阵。(c) 所学嵌入的 t-SNE 投影,按类别着色。
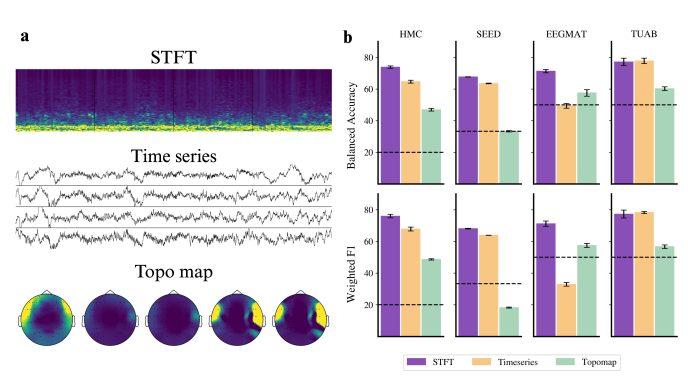
图3.视觉接口至关重要。 (a) STFT、原始时序与头皮拓扑三类输入。(b) 四个数据集上的平衡准确率(上)与加权 F1(下)。
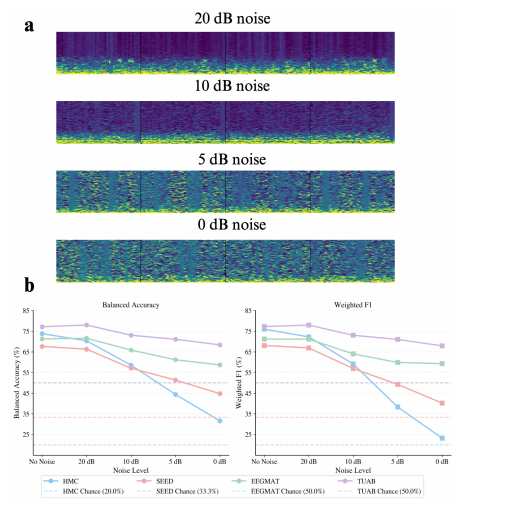
图4.BraVista 对 EEG 噪声的鲁棒性。 (a) 递增噪声水平(20 dB 至 0 dB)下的 STFT 示例。(b) 平衡准确率与加权 F1。虚线表示随机水平性能。
研究结论
BraVista 的研究结论表明,将多通道 EEG 的 STFT 频谱图排列为结构化图像、配以自然语言指令,再通过轻量后训练适配通用视觉-语言模型,即可在单一模型内实现跨睡眠分期、情感识别、认知负荷与异常检测的统一多任务解码,且无需任何 EEG 专属预训练阶段。 四项任务上,BraVista 均取得稳健性能并显著优于零样本 VLM 基线,证明通用视觉-语言先验能够有效迁移至神经信号领域;控制实验进一步显示,STFT 图像在三种视觉表征中始终最优,说明保留时频联合结构的接口才是 VLM 有效“读懂”EEG 的关键;而渐进噪声下性能平缓退化且始终高于随机水平,结合类级混淆模式与嵌入聚类结构,共同印证模型依赖的是 EEG 信号本身的生理结构而非浅层视觉伪影。这项工作将研究重心从“设计专用 EEG 模型”转向“设计神经信号与通用基础模型之间的有效接口”,为可扩展、可复用的统一 EEG 解码提供了一条新路径。
免责声明:原创仅代表原创编译,水平有限,仅供学术交流,如有侵权,请联系删除,文献解读如有疏漏之处,我们深表歉意。


公众号丨智能传感与脑机接口