【内容目录】
一、美股算力链为何蒸发万亿?中国芯片如何反超?
二、 谁刺破了英伟达的算力泡沫?
三、 ASIC强在哪?海外大厂为何纷纷自研?
四、中国AI芯片到底能不能打?
五、英伟达GPU为何依然更强?
摘要
2026年10月中旬,全球AI算力市场迎来分水岭:一边,英伟达、CoreWeave、甲骨文等美股AI算力链数日内蒸发逾1万亿美元市值;另一边,中国本土AI芯片拿下国内66%的市场份额,非GPU架构出货量首次反超通用GPU。本文从三个层面拆解这场变局:金融层面,芯片原厂“担保客户贷款买卡”的融资模式难以为继,引发信贷市场重新定价;产业层面,推理已成为算力需求的大头,海外云巨头纷纷自研ASIC,把三年总成本压低56%,国产芯片也在DeepSeek-R1实测中追平甚至反超英伟达对华特供卡;长期来看,英伟达GPU凭借对算法迭代的适应力和系统级升级带来的跨代保值能力,依然稳居全球算力顶端。
美股算力链为何蒸发万亿?中国芯片如何反超?
2026年10月中旬,美国9月CPI同比反弹至 3.7%,10年期美债收益率冲高至 5.365%。信贷市场随之重新定价,全球科技股数日内蒸发逾 1万亿美元 市值。
曾被视为“算力印钞机”的英伟达及其产业链,成了这轮下跌的重灾区:
• 英伟达(NVIDIA) 股价下挫逾 4%,市值缩水 2,000亿美元;
• 高杠杆算力云龙头 CoreWeave 单日暴跌 15.46%,Nebius 与 IREN 分别下跌 15% 和 14%;
• 押注OpenAI基建的 甲骨文(Oracle) 大跌 9%;
• 上游同样承压:ASM跌9.6%、ASML跌6.6%、闪迪跌6%,费城半导体指数跌4.3%,台积电、AMD、博通、美光均跌逾 4%。

图01:AI产业链核心标的跌幅对比(%)
与此同时,中国AI芯片市场却完成了一次历史性逆转。2026年上半年,中国数据中心AI加速卡出货200.8万颗,本土品牌合计拿下约66%的份额;英伟达在华占比则从2024年的70%、2025年的55%,一路滑落至 34%。
架构层面也迎来首次反超:上半年国内非GPU芯片(NPU、ASIC等)出货101.6万颗,同比增长80%,首次超过通用GPU(99.1万颗,同比下降26%),占比达50.6%。厂商方面,华为昇腾 以 28% 的份额紧逼英伟达,阿里平头哥(7%)、寒武纪(5%)、百度昆仑芯(4%)、海光信息(3%) 紧随其后。

图02:2026年上半年核心芯片厂商出货量与市场份额
谁刺破了英伟达的算力泡沫?
说白了,这轮暴跌的根源是一套“借钱买卡、以卡借钱”的循环游戏玩不下去了。CoreWeave这类算力云公司自身没钱,靠英伟达等芯片原厂出面担保去贷款买卡;原厂把卖卡收入记成高毛利营收,客户再拿买来的GPU做抵押继续借钱——英伟达、AMD、博通三家为此背上的担保敞口合计约 4,900亿美元。2026年10月,这条链条接连出事:CoreWeave 因机房迟迟通不上电,债券收益率飙至 15%;Volta Digital 手握11万张B200却“有卡无电”,高盛和摩根大通拒绝为其37亿美元贷款包销;而让险资敢于放贷的“GPU残值保险”,承保方竟是一家 无评级、无公开财报的初创公司Corgi,且新芯片发布导致的老卡贬值根本不赔。再加上微软、Meta等云大厂把GPU折旧年限从3年拉长到 6年 来美化利润,华尔街终于意识到:这场“算力次贷游戏”已难以为继。
ASIC强在哪?海外大厂为何纷纷自研?
▍ 推理时代算总账:ASIC增速达GPU的2.8倍,三年TCO降56%
随着AI算力的重心从训练转向推理(推理占比已达65%–75%),继续为通用GPU支付高额溢价和电费,越来越不划算。2026年,全球定制AI ASIC出货量同比增长44.6%,是通用GPU增速(16.1%)的2.8倍,台积电CoWoS产能中GPU与ASIC的比例也已达到 6:4。
成本差距更加直观:同等算力下,英伟达H100集群的三年总拥有成本(TCO)高达 1.77亿美元,谷歌TPU v6集群仅需 7,850万美元——三年TCO降低56%,单Token成本下降50%–67%。这笔账推动北美四大云厂在2026年大举换装:谷歌TPU约90万颗、亚马逊AWS约60万颗、微软Maia约25万颗、Meta MTIA约18万颗。
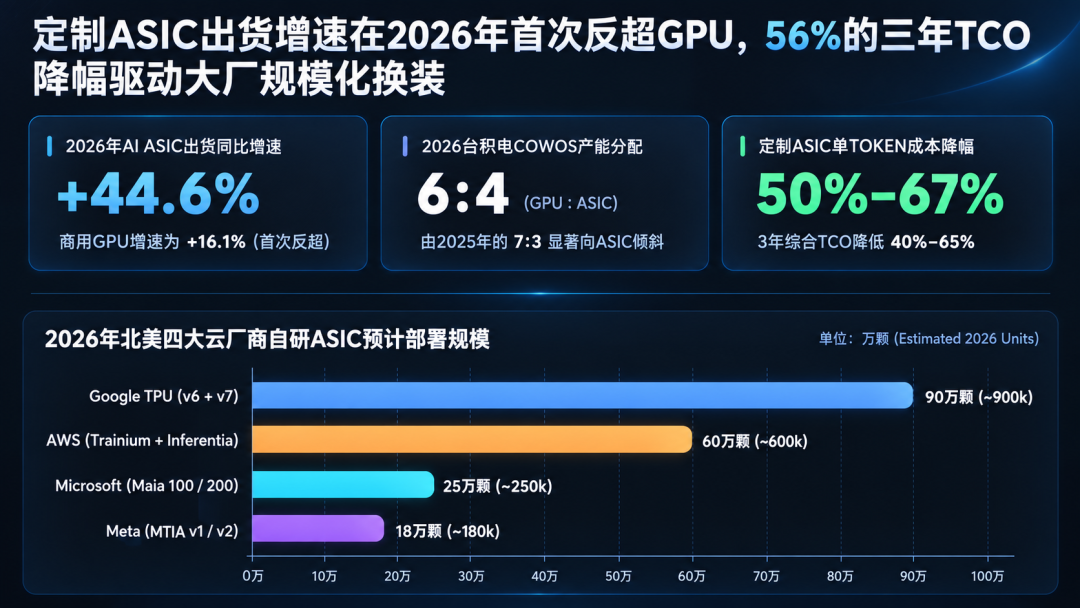
图03:定制ASIC出货增速在2026年首次反超GPU,56%的三年TCO降幅驱动大厂规模化换装
▍ 架构本质差异:脉动阵列 + 大容量SRAM vs 通用SIMT动态调度
• 通用GPU(SIMT架构):为了兼容任意算法,芯片里 30%–40%的晶体管面积 都用在线程调度、分支预测和缓存一致性控制上,数据还要在寄存器、缓存与HBM之间反复搬运,相当于交了一笔高昂的“灵活性税”。
• 专用ASIC(DSA架构):砍掉复杂的硬件动态调度,改由编译器在运行前排好指令;省下的面积全部用来堆 二维脉动阵列(数据在计算单元间直接流转,无需反复读写寄存器) 和 数百MB的片上SRAM,把矩阵乘法的每瓦能效推向极限。

图04:通用GPU与专用AI ASIC微架构对比图
▍ 海外五大巨头自研ASIC方案与实测战绩
借助博通(占定制芯片市场55%–60%份额)和Marvell的设计服务,海外大厂的自研芯片已经能和英伟达正面过招:
1. Google(TPU v7 Ironwood):3nm工艺,单卡FP8算力 4,614 TFLOPS,直逼B200;配备 192GB HBM3e(带宽7.4 TB/s),借助光交换网络单集群可直连 9,216颗,支撑Gemini全系列的训练与推理。
2. OpenAI(3nm Jalapeño):与博通联合打造,功耗仅 700W,是GB200/GB300(1,400W)的一半。Hot Chips 2026实测显示,它在 GPT-OSS 120B、DeepSeek R1(670B)、Kimi K2.5(1T) 上全面胜出:每千瓦峰值吞吐高1.5–1.9倍,单用户解码快2.7–4.1倍,延迟低1.7–3.6倍。
3. 亚马逊AWS(Trainium2/3):Trainium2配备 96GB HBM3(2.9 TB/s),正与Anthropic共建规模超 40万颗 的“Project Rainier”集群,性价比高出30%–40%;3nm的Trainium3算力再翻一倍。
4. 微软(Maia 200)与 Meta(MTIA v2/v3):微软淘汰初代Maia 100后,2026年部署了25万颗支持FP8和HBM3e的3nm Maia 200;Meta则部署18万颗 MTIA v2/v3,接管推荐系统与Llama推理。
中国AI芯片到底能不能打?
国产芯片之所以能在上半年拿下66%的份额、让英伟达H20失宠,关键在于七大主力厂商在核心工程指标和 DeepSeek-R1(671B满血MoE) 实测中已经全面达标:

图05:中美主力算力芯片关键工程指标对标(面板一:板载显存容量)

图06:中美主力算力芯片关键工程指标对标(面板二:显存吞吐带宽)

图07:中美主力算力芯片关键工程指标对标(面板三:热设计功耗与实测工程效能)

单卡制程上,国产7nm与台积电3nm/4nm仍有代差。华为的解法是“以集群补单卡”,推出 “灵衢(UnifiedBus)全光互连超节点”:已商用的 Atlas 384 用全光互连把384颗910C耦合成一台逻辑上的“巨型计算机”(总带宽 192 TB/s,延迟 低于2.1微秒);最新的 Atlas 950 更扩展到 8,192张950DT(FP8算力8 EFLOPS、统一内存1,152 TB),在集群层面抹平了单卡差距。
英伟达GPU为何依然更强?
既然海外大厂纷纷自研ASIC、国产芯片也拿下了66%的份额,英伟达GPU是不是已经不再是最好的芯片?恰恰相反。如果把时间拉长到 3–5年,从算法适应力和资产残值来算总账,英伟达通用GPU的护城河依然很深。
▍ 算法演进与“技术性折旧”:ASIC一旦遇上算法迭代就会沦为废铁
定制ASIC把计算逻辑“焊死”在硅片上,而AI算法每半年到一年就会发生剧变。通用GPU凭借 SIMT动态调度、可编程共享内存,以及AI自动生成CUDA算子,往往在新算法发布当天就能完成适配;ASIC则不得不面对残酷的 “技术性折旧”:
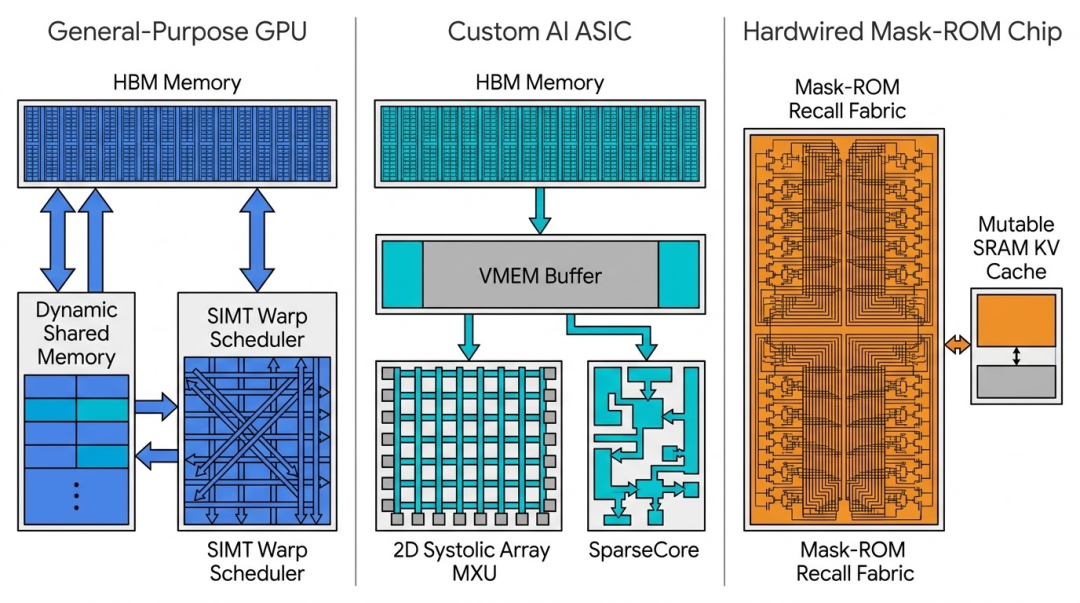
图08:通用GPU、定制ASIC与硬编码Mask-ROM三大微架构与技术折旧对比
• 硬件尺寸锁死利用率:谷歌 TPU v7 把矩阵计算单元(MXU)从 128×128 扩大到 256×256,但主流大模型(包括GQA与DeepSeek MLA)普遍采用 d_k = 128 的注意力头维度,放到 256×256 的阵列上,一半计算单元空转,利用率被锁死在50%以下;微软初代 Maia 100 更因押错了MXFP6/9精度格式,服役不到两年就在FP8时代被淘汰。
• 三大专用芯片“血本无归”的案例:
1. 特斯拉 Dojo D1(2025年8月团队解散):放弃HBM,只靠440MB片上SRAM,撞上大模型的“内存墙”后被迫关停,特斯拉转头花百亿采购英伟达Blackwell;
2. Taalas HC1(2026年8月被AMD收购):把Llama 3.1 8B的模型权重直接光刻在芯片里,模型一更新,芯片即报废,残值为零;
3. Cerebras CS-3(股价下跌67%):44GB片上SRAM装不下万亿参数的MoE模型;OpenAI发现英伟达GPU配合投机采样同样能做到低延迟后,便把部分核心负载切回了GPU。
▍ 系统级协同进化:英伟达如何让GPU在服役多年后“越跑越快”?
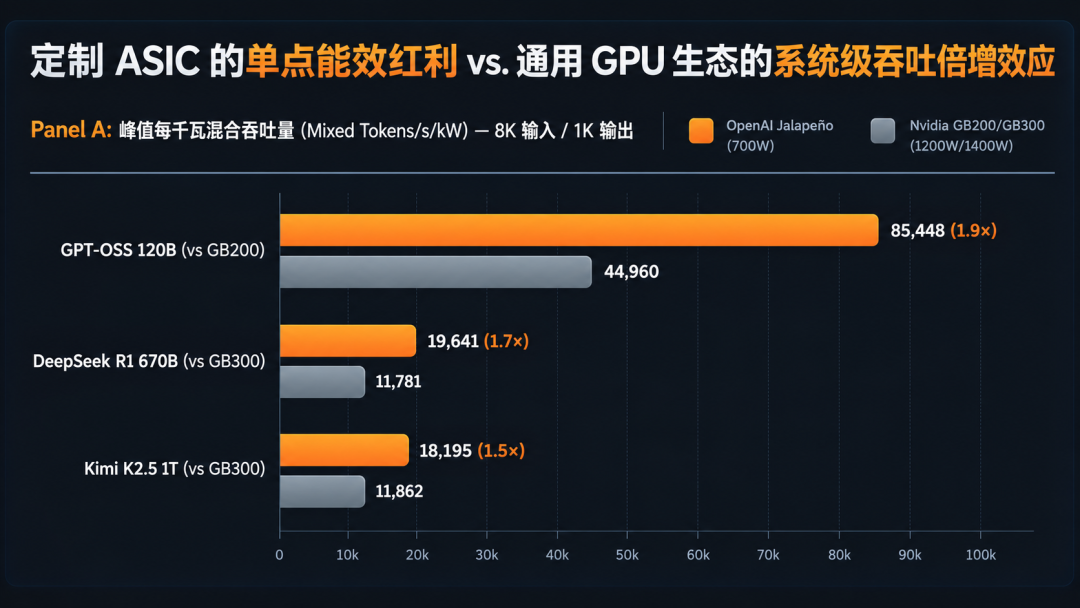
图09:定制ASIC的单点能效红利 vs. 通用GPU生态的系统级吞吐倍增效应(Panel A:峰值每千瓦混合吞吐量)
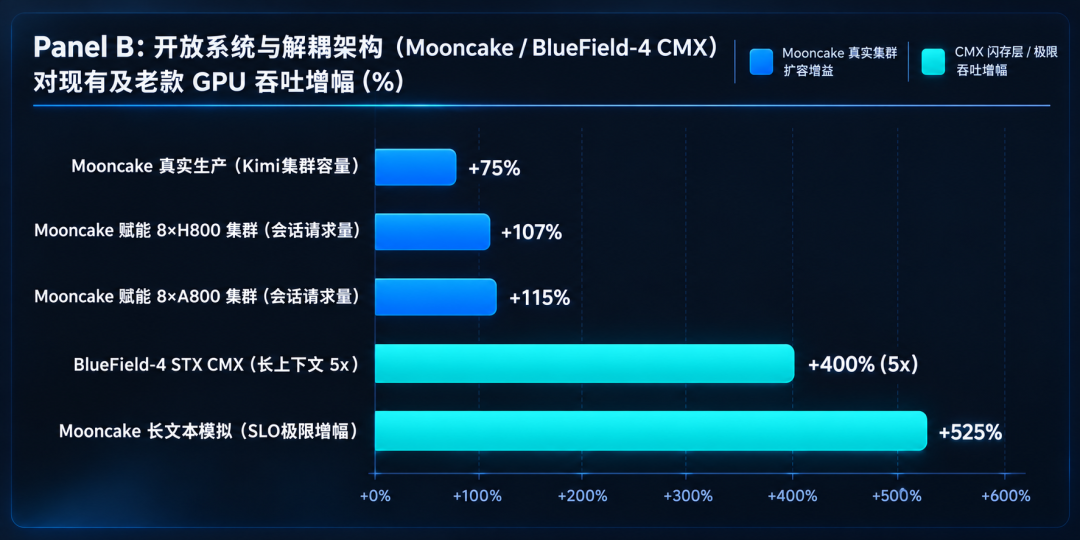
图10:开放系统与解耦架构(Mooncake / BlueField-4 CMX)对现有及老款GPU吞吐增幅(Panel B)
更重要的是,英伟达GPU拥有一套完整的跨代保值路径:第1–2年用于一线预训练 → 第3–4年转做微调与推理 → 第5–6年进入二级市场变现。在此基础上,英伟达还通过三项系统级升级,让老卡“越跑越快”:
1. 200亿美元收购Groq:推出集成256颗LPX芯片的 Groq 3 LPX机柜(SRAM带宽2,048 TB/s),与GPU组成“GPU负责预填充、LPX负责极速解码”的异构系统,单用户推理速度达 3,400 tokens/s,每兆瓦吞吐提升 35倍;
2. BlueField-4 STX与CMX共享闪存层:把闪存池化为一层“G3.5上下文内存”,长文本智能体推理的吞吐和能效比均提升 5倍;
3. Mooncake PD分离架构:把预填充(Prefill)与解码(Decode)拆开,并借助RDMA扩展KV Cache,不换芯片就能让 三年老卡8×H800吞吐提升107%、四年老卡8×A800提升115%,长文本场景下更是暴增525%。
一颗专用ASIC从出厂那天起,性能就被焊死,此后每天都在贬值;而一颗英伟达GPU在出厂三年后,仍能靠软件和系统的进化跑出翻倍的吞吐量。这正是英伟达在经历万亿市值震荡后,依然稳居金字塔尖的底牌。





