论文题目:DexHoldem: An Agentic Robotics Benchmark for Dexterous Manipulation in Texas Hold’em
作者:Feng Chen、Tianzhe Chu、Li Sun、Pei Zhou、Zhuxiu Xu、Shenghua Gao、Yuexiang Zhai、Yanchao Yang、Yi Ma
参与团队:香港大学、忆生科技
论文链接:arxiv.org/abs/2605.18727
项目主页:dexholdem.github.io/Dexholdem/
在德州扑克中打出一枚筹码,需要机器人看准目标、控制手指,还要避免碰乱旁边的牌和筹码。但要连续完成一场对局,每个动作留下的桌面状态,又会成为下一步感知与决策的起点。
过去的具身智能评测往往各考一段:有的只在仿真里跑,有的用夹爪做粗操作,机器人看懂局面—动手—别搞乱桌面的完整能力,一直没人放在同一张桌子上考。香港大学与忆生科技参与的 DexHoldem 研究,将这些环节放进同一张真实德州扑克牌桌:既评测灵巧手的执行能力,也检验智能体的状态理解与闭环运行。该工作已获 NeurIPS 2026 Workshop 接收。

一张牌桌上的三层评测
DexHoldem 提供 1,470 条成功的遥操作演示,覆盖 14 项底层操作原语;另设 36 道真实场景感知问题,并用 33 局有效运行检验完整系统。动作、感知和系统表现因此有了各自的评价依据,也能在同一物理环境中相互对照。
实验平台由 UR10e 机械臂和 Shadow 灵巧手组成。策略模型通过输入桌面俯视、第三人称、腕部三视角图像及本体状态,输出 30 维关节位置目标;智能体另用一台专用桌面相机观察局面。
14 项原语包括左右拾牌、左右扣放、左右亮牌,以及四种面额筹码的推入和拉回。每项收集 105 条演示,其中 100 条用于训练、5 条用于验证。一张扑克牌只有约 0.3 毫米厚和密集摆放的筹码:捏起它、看清牌面、放回原位,还不能碰乱旁边密集摆放的筹码,为指令理解与多指接触控制提供了具体考题。

动作完成还需检验是否会破坏场景
一次推筹码,目标筹码到位了,旁边一摞筹码却被带倒——这算成功吗?DexHoldem 的判断是:分别算“任务完成”和“场景保持” 的四种结局:形成完成且保持、完成但扰动、失败但保持、失败且扰动四种组合。
任务完成率 TCR 统计所有完成动作;场景保持成功率 SPSR 则要求完成目标的同时,终止场景满足非目标物体位置、重叠和区域等规则。目标物体按要求移动是允许的,评价关注的是动作带来的额外扰动。
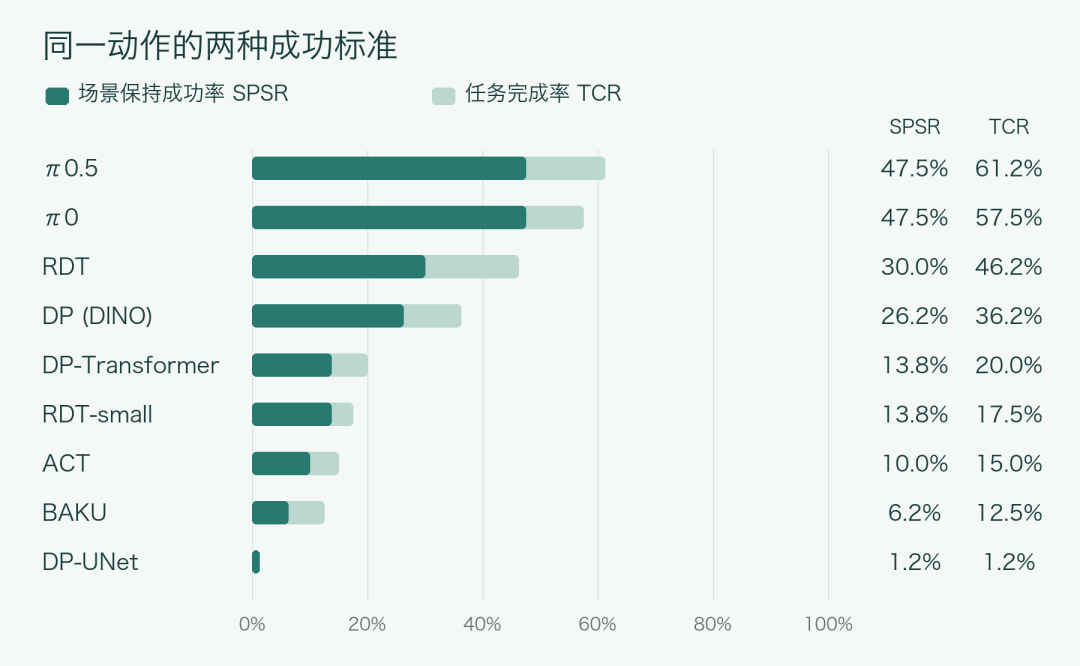
π₀.₅ 的 TCR 为 61.2%,SPSR 为 47.5%;π₀ 的 SPSR 同为 47.5%。排名第一的 π₀.₅有 11 项评测虽完成目标,却未满足场景保持要求——大约每 5 次“成功”动作里,就有 1 次是以弄乱桌面为代价。这让一个容易被单一成功率隐藏的问题变得可见。
这些策略共享同一套演示预算、真机评测流程和评分标准,同时保留各自的输入编码器与适配方式。
比完模型,还有一个更根本的问题:数据够不够用,预训练又能帮多少? 论文还以 RDT 比较预训练与随机初始化的策略:每项原语使用 10、20、50、100 条训练演示时,预训练使验证集动作预测损失分别降低 1.2%、9.0%、10.7%、11.3%。
这一离线诊断为数据与初始化的作用提供了线索,真机收益仍需用执行评测检验,换句话说,夹爪上预训练出来的经验,没能帮灵巧手“省数据”——想把灵巧操作练好,数据量本身才是硬约束。当然这只是离线指标,真机收益仍需执行评测检验。
目前的基模还不足以理解整个局面
灵巧手准备行动之前,系统得先像牌手一样读懂牌桌:当前处于哪个阶段、轮到谁、公共牌是什么,双方各下了多少筹码、双方筹码还有多少和最后结果是谁赢了。DexHoldem 将这些信息组织为八项感知子能力,在 36 道真实部署场景题上测试 8 种模型与运行框架组合。
衡量标准有两个:Overall 要求一道题的所有适用评分字段同时正确;Avg 则是八项子能力准确率的无权平均。前者更严格:能够显示局部识别能力组合到一起时,还剩下多少可靠性。

Opus 5.5 的 Overall 为 49.1%,Avg 为 80.6%;GPT 6 Astra 分别为 48.1% 和 80.2%。有意思的是,两个领先配置分属 Claude 和 GPT 两条技术路线,成绩却几乎打平。更鲜明的现象是:单项平均分已达到约八成,严格整题正确率仍不到一半。
不同信息的难度也不一致。GPT 6 Astra 在当前下注筹码和对手筹码库存上分别达到 93.8% 与 100.0%;但它与 Opus 5.5 的公共牌准确率都只有 20.5%。公共牌项的最高结果为 GPT 5.5 的 61.5%。因此,定位具体字段的弱点,比只看一个总分更能指导改进。
这一基准衡量的是“给定历史上下文之后的当前状态解析”:部分题目提供已标注的历史状态作为上下文,另有 12 道题不提供历史。它与系统自主连续跟踪的表现,需要分别观察。
从一步执行走向持续交互
在 DexHoldem 里,机器人看一张手牌就要分三步:先拾牌,识别并记下牌面,再把牌扣放回桌面。整场对局就是由这样一个个高层动作串起来的——系统循环运行“观察、解析状态、路由、执行、再次观察”,每个高层动作还会进一步展开成若干底层原语。
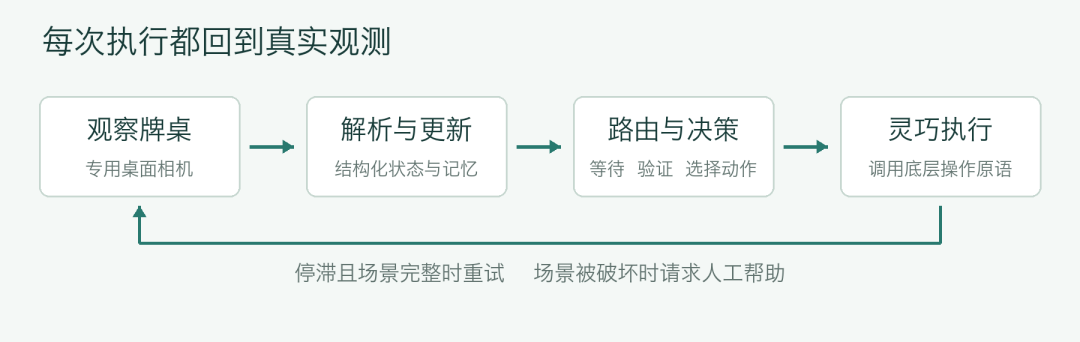
这些杂事大多不需要“动脑子”:规则化路由处理等待、动作验证、多步操作续行与恢复;只有出现多个合法高层动作之间选择时,才调用主智能体做决策。原语长时间停滞且场景完整时,系统可以重试;场景被破坏时,则升级请求人工帮助。
系统实验固定使用 GPT 5.5 作为感知器与主智能体、π₀ 作为底层策略。33 局有效测试中,4 局推进到牌局结果,完成率为 12.1%;其中 3 局没有人工求助,只有 1 局既没有重试,也没有人工求助。
实际派发的 34 次重试中,12 次确认完成了被重试的原语,比例为 35.3%。四局完整测试中的三局,曾借助重试摆脱执行停滞。这个结果呈现了恢复机制在真实轨迹中的作用,也显示连续交互仍有明显的可靠性瓶颈。
这个“一次重试”的细节值得多看一眼:恢复机制确实在真实轨迹中起了作用,但它也揭示了闭环的可靠性瓶颈——论文的结论是,连续对局的运行时间主要被反复等待、验证和续行占据,而不是被高难度的决策占据。哪怕每个组件在孤立评测中都有中等偏上的成功率,组合进闭环之后,感知与执行的错误仍会在几十次状态迭代中层层累积。
DexHoldem 的贡献,是把灵巧动作、结构化感知与闭环运行放到可逐层检查的共同场景中。它评测的不止是具身操作能力,也包含具身智能体的感知,判断和决策能力。一张牌桌上的三层考试,目前没有任何一层拿到高分——你觉得瓶颈会先在哪一层被突破?欢迎留言讨论。
-END-
点击下方卡片,关注【Xbotics具身智能实验室】
你想要的这里都有~~
Ask Me Anything|提问箱
对文章有疑惑,或想聊更深?欢迎把你的问题丢给我们:技术方案、实操踩坑、课程与资料、项目合作、职业发展,都可以问。
怎么问:在评论区留言,或私信公众号
我们会做什么:每周集中整理高质量问题并公开回复,重点问题邀请作者或嘉宾深度解答;典型问题会加入知识库并持续更新。
提问小提示:尽量说明「你的目标—当前做法—期望产出」,附上必要信息(硬件/软件版本、数据规模等),能更快获得有用答案。
一起把问题变成知识,推动社区进步 🚀