如果只能用一行代码概括这条新闻,那就是 device_map="tpu"。
在圣何塞举行的 PyTorch Conference 2026 上,谷歌宣布开源 TorchTPU,这是一套让 PyTorch 原生运行在 TPU 上的完整软件栈。从此,在 Hugging Face Transformers v5 里把模型部署到 TPU,只需要传入这一个参数。


一个参数的变化,背后是谷歌在软件路线上的一次转向,也是英伟达 CUDA 生态近十年来遭遇的最正面的一次挑战。
AI 芯片的竞争,从来不只是芯片本身的竞争。PyTorch 是全球使用最广泛的 AI 框架,而它自 2016 年诞生起就与 CUDA 深度绑定:英伟达工程师长期投入,确保 PyTorch 在 N 卡上跑得最好,华尔街甚至有分析师把 CUDA 视为英伟达抵御对手最坚固的盾牌。反观谷歌,TPU 十年来主要服务自家的 TensorFlow 和 JAX。PyTorch 用户想用 TPU,得经过 PyTorch/XLA 这样一层「转接」,付出大量额外的工程成本。
TorchTPU 改变的正是这个前提。用谷歌官方的说法,TPU 从此与 GPU、CPU 并列,成为 PyTorch 的原生选项。
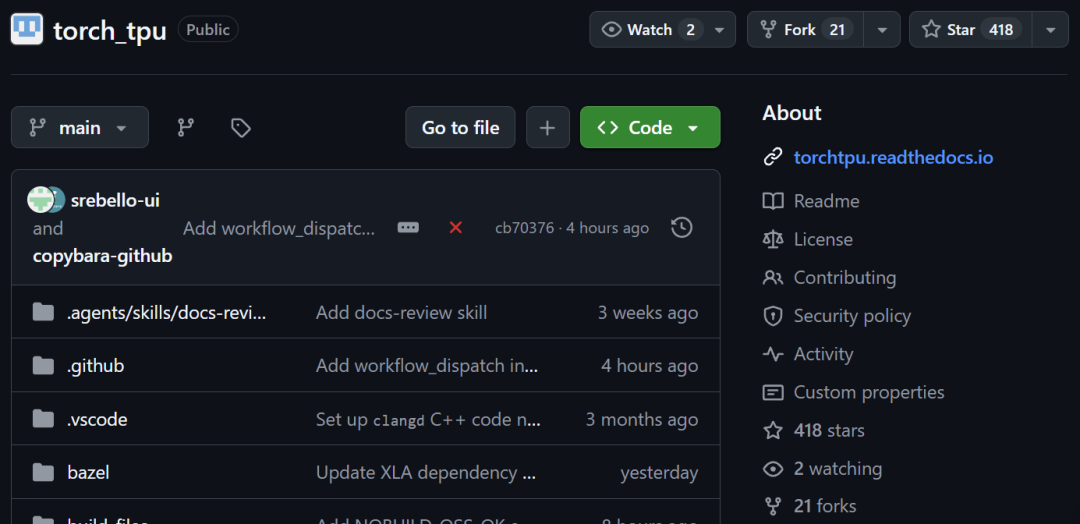
项目地址:https://github.com/google-pytorch/torch_tpu
项目由谷歌与 PyTorch 的「娘家」Meta 联合开发,vLLM、SGLang、Hugging Face、Ray、TorchTitan 等主流开源项目同步完成接入,一份 23 页的技术报告也同时发布在 arXiv 上。

报告标题:TorchTPU – A Hybrid Eager/Compiled Architecture for Native PyTorch Execution on TPU
报告地址:https://arxiv.org/pdf/2610.24161
时间点也值得关注。过去一年,Anthropic 签下最多 100 万颗 TPU 的使用协议,Meta 也被曝与谷歌达成数十亿美元的 TPU 租用合约。硬件已经卖得出去,软件成了最后一块短板。现在,谷歌要亲手把它补上。
不是又一个「转接头」
PyTorch 跑 TPU 并不新鲜。技术报告回顾,谷歌早在 2020 年就推出了基于惰性张量的 PyTorch/XLA,并罕见地直言了它的问题:需要侵入式修改源码来划定可编译区域,编译延迟严重,不支持 PyTorch 原生的即时执行模式,对分布式新原语的跟进也很滞后。后来的 TorchAX 则把 PyTorch 算子逐个翻译成 JAX 执行。在报告看来,这些方案本质上都是让 PyTorch 去迁就 JAX 的运行方式。
TorchTPU 在 2025 年年中立项时就定下几条原则:运行时不依赖 JAX,即时执行必须扎实,把代码从 GPU 迁到 TPU 应当像把 .to("cuda") 改成 .to("tpu") 一样简单。
实现上,它基于 PyTorch 预留给第三方硬件的 PrivateUse1 接口,在 PyTorch 分发器中注册为一个新的 C++ 后端,开发者拿到的就是普通的 PyTorch 张量,没有子类,也没有包装器。

从 GPU 迁移到 TPU 前后的设备初始化代码对比
即时执行被做成三档:
默认的 Strict 模式逐个分发算子、与 CPU 异步执行,对应 GPU 上的常规体验;
Debug 模式同步执行,用于排查形状错误和 NaN;
第三档 DeferAndFuse 是 TorchTPU 新引入的即时与编译混合模式,先把一串算子攒起来,到需要取值时再自动融合成大块计算交给 TPU,速度比 Strict 模式快 50% 以上,还能降低峰值显存占用。
三种模式共享一套分层编译缓存,同样的算子序列编译一次即可反复复用。
追求极致性能时,开发者可以切换到 torch.compile。这里谷歌做了一个刻意的取舍:用 TorchDynamo 捕获计算图后,不走 PyTorch 默认的 Inductor 编译器,而是把算子映射到 StableHLO,交给 XLA 生成 TPU 程序。
报告给出了理由:一是能复用为即时模式搭好的基础设施,二是 XLA 经过多年检验足够稳定,三是 Inductor 的成功很大程度上建立在 Triton 之上,而 Triton 很难移植到 TPU 架构。这句话从侧面说明,PyTorch 与 GPU 的绑定,深入到了编译器这一层。
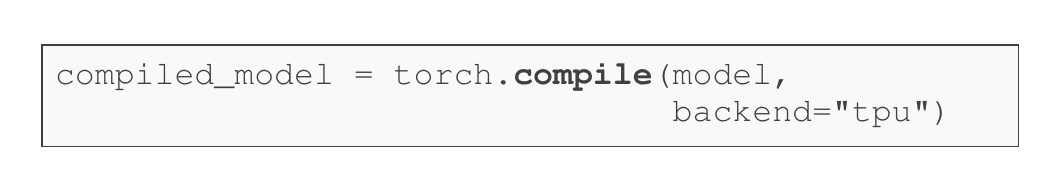
在 TPU 上调用 torch.compile 只需指定 backend=“tpu”

PyTorch 经由 StableHLO 接入 OpenXLA 编译栈,与 JAX、Pallas 内核共用同一条下降路径
分布式方面,TorchTPU 在 Process Group 层实现了 TPU 集合通信,DDP、FSDP2 和 DTensor 开箱即用,还支持 rank 0 进程多做日志等额外工作的「不对称」写法,这是只支持 SPMD 的 PyTorch/XLA 做不到的。按照 PyTorch/XLA 官方文档的说法,TorchTPU 公开后将取代 PyTorch/XLA。

用 Stream 把集合通信卸载到 SparseCore,同时在 TensorCore 上做矩阵乘
技术报告里的成绩单
覆盖面是第一张答卷。谷歌持续在 TPU 上测试 Hugging Face 下载量最高的约 5000 个模型,截至报告撰写时共 4917 个、横跨 500 多个架构族。其中 98% 能够跑通不崩溃,在 657 个代表性架构里,97% 的输出与 GPU 结果数值一致。

Hugging Face 模型覆盖情况汇总
第二张答卷是不做专门优化时的性能。谷歌只用 PyTorch 标准模块写了一个 30B 参数的 MuseGlimmer 模型,不调用任何模型专属的定制内核:单颗 TPU v7 上,5120 序列长度的预填充达到每秒 2.57 万 token,MFU 为 59%;在 4 颗 TPU v7 上训练,MFU 为 38%。把 TorchTitan 中原本为 GPU 编写的同款实现稍加修改搬过来,训练 MFU 也有 36%。
第三张答卷是规模。在 Qwen3 235B MoE 模型上,64 颗 TPU v7 时 PyTorch 方案的吞吐达到谷歌自家 JAX 方案 MaxText 的约 94%。从 1024 颗芯片扩展到 8192 颗、也就是一整个 TPU v7 Pod,每个 TensorCore 的吞吐只下降约 6%,MFU 稳定在 27% 到 29% 之间,损失曲线在各个规模下几乎重合。官方博客另称,Qwen 3 8B 的训练 MFU 最高可达 52%。

Qwen3 235B MoE 在 1024 到 8192 颗 TPU v7 上的扩展数据

总吞吐随芯片数量近乎线性增长

不同规模下前 12 步的损失曲线几乎重合
换句话说,PyTorch 在 TPU 上和「亲儿子」JAX 之间,差距已经被压到个位数百分比。
推理侧的数据同样亮眼。据报告援引的 SemiAnalysis InferenceX 结果,TPU v7 搭配 vLLM-TorchTPU 在 8K 输入、1K 输出的场景下,每百万 token 成本降到 2.01 美分,比 9 月首次亮相时的 3.6 美分低了约四成。
报告还给出了几组案例:FLUX 训练从开箱即时模式到完整编译优化,单步时间从 11.49 秒降至 2.78 秒;Meta 的 DLRM v2 推荐模型在 32 颗 TPU v7x 上与谷歌高度优化的 JAX 基线完全持平。按报告的说法,TorchTPU 已经在部分谷歌云大客户的生产环境中承担推理和训练任务。
一次「全家桶」式的开源
比技术本身更有分量的,是生态的完整度。
推理侧,与 Inferact 合作的 vLLM 后端、与 RadixArk 合作的 SGLang 后端都保留了上游原有的调度器和 API 服务器,现有推理栈无需改动;谷歌还联合 Red Hat、IBM 发布 llm-d 1.0,在 GKE 上让 GPU 与 TPU 共用同一个推理入口。
训练侧,TorchTitan 提供稠密模型、MoE 和扩散模型的预训练配方,强化学习框架 VeRL 合入了 TPU 后端,Ray 支持把同一工作流的不同阶段分别调度到 CPU、GPU 或 TPU。
端侧,前身为 TensorFlow Lite 的 LiteRT 正式加入 PyTorch 生态。TorchTPU、vLLM-TorchTPU、SGLang-TorchTPU 和 TorchTitan 四个核心仓库同步开源。

站台方的表态同样值得玩味。Meta PyTorch 工程总监 Jana van Greunen 直言,Meta 不能被单一硬件架构束缚,TorchTPU 已经支撑起其 LLM、广告和推荐系统的关键生产场景。要知道,Meta 可是英伟达的超级大客户。
从内部代号到 GitHub
回看 TorchTPU 的路径,节奏相当紧凑。2025 年年中,项目在谷歌内部启动 ;同年 12 月,路透社首次披露这一代号,称谷歌正与 Meta 密切合作,并在考虑开源部分代码。2026 年 4 月,谷歌开发者博客公开技术架构,项目负责人在巴黎 PyTorch Conference Europe 上登台。9 月,TorchTPU 进入私有 Beta,并在 SemiAnalysis 的推理基准中首次亮相。到今天,整套栈正式开源。

从「考虑开源部分代码」到四个核心仓库全部公开、各大项目上游合入,谷歌给出的答案比外界预期的更彻底。
CUDA 护城河会被填平吗
一个更进一步的问题是:框架层的壁垒被拆除后,英伟达还剩下什么?
首先要看到,TorchTPU 抹平的是框架层,而不是硬件差异本身。报告自己也承认,只改一行 .to("tpu") 拿不到峰值性能,因为模型的形状、分片和算子选择可能本就偏向 GPU;TPU 的 TensorCore 本质上是单线程处理器,形状要足够宽才能喂饱矩阵单元,这与 GPU 靠并行跑大量小内核的思路截然不同。
一些细节差异同样需要迁移者留意:TorchTPU 默认采用 BF16 乘法加 FP32 累加,而 PyTorch 在 CUDA 上默认是完整 FP32;默认的集合通信编译方式会带来 30% 到 40% 的端到端损失,需要额外标注来优化;每颗 TPU 只能被一个进程访问,强化学习中训练与推理共置的做法暂时无法开箱支持。「能跑」和「跑得好」之间,仍然隔着调优的工作量。

PyTorch 在 CUDA 与 TPU 上的数值精度对比
其次,这并非谷歌一家的动作。PyTorch Conference 2026 上,AWS 也在讲 Trainium 走向原生 PyTorch 的历程,其 Neuron SDK 已于今年停止支持用 PyTorch/XLA 做训练,转向原生的 TorchNeuron。

TorchNeuron 的高层架构图
PyTorch 正在变成一层事实上的硬件抽象层,PrivateUse1 则成了各家芯片接入的标准插槽。当所有硬件都能以原生方式跑同一份 PyTorch 代码,竞争焦点就会从「生态能不能用」转向「每美元能换来多少吞吐」,这恰恰是谷歌在发布稿里反复强调的指标。
当然,变量依然存在。报告中的大部分性能数据由谷歌自己测得,还需要社区在更多模型和场景中独立验证;TPU 能否以足够的产能和价格触达普通开发者,同样决定着这次开源的最终影响。谷歌也表示,未来 6 到 12 个月的重点是生产环境加固、动态形状支持以及面向下一代 TPU 的 FP8、FP4 量化。
但方向已经清晰。过去十年,选择 PyTorch 几乎就等于选择了 CUDA。从今天起,这道等式不再成立。
参考链接
https://cloud.google.com/blog/topics/ai-infrastructure/torchtpu-is-now-open-source-run-native-pytorch-on-tpus
https://developers.googleblog.com/torchtpu-running-pytorch-natively-on-tpus-at-google-scale/
https://www.denvergazette.com/2025/12/17/google-works-to-erode-nvidias-software-advantage-with-metas-help/
https://pytorchconferenceeu2026.sched.com/event/2Ikir

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com