

面对这些任务,基础模型需要将有限、零散且不断变化的观测,整合为连贯、可更新的空间理解,并据此推理、预测与决策。这正是空间智能的核心命题,也是连接多模态理解、内容生成与物理交互的能力基础。
而让模型获得这些能力,究竟需要什么样的数据?
香港城市大学计算机科学系副教授、Data Intelligence Lab 负责人马辰,长期研究数据挖掘、数据驱动 AI 与数据价值。今年,他多了一项新职责:负责映界科技数据方向的预研工作。
在马辰看来,基模空间智能的瓶颈不只在架构,更在数据层:什么数据对任务真正有用、如何评测模型是否理解空间、评测结果又该如何反哺训练。这正是映界正在探索的方向——从多模态采集、空间结构化,到模型空间智能评测与后训练环境。
围绕这条路线,映界科技过去几个月已连续完成两轮种子轮融资,总计数千万元。
一顿火锅,和一句「 count me in 」
回忆起和映界合作的起点,马辰说自己几乎没有犹豫。一顿火锅之后,他答应了创始人金依力的邀请。「他问我要不要一起做,我说没问题,count me in。」
当时,映界科技成立仅数月,方向是空间智能的数据与训练层。团队此前积累了空间感知、动态三维表征和多模态采集的经验,现在想把这套能力延伸到动态空间数据、模型评测和训练基础设施。
一个在大学里研究「数据智能」的教授,为什么选择一家刚成立几个月的创业公司?
吸引他的,是一个具体的问题:当基础模型开始进入真实世界,什么样的数据才能提升模型的空间智能?
这个问题听起来抽象,落在映界的业务里却很具体。公司要做的,除了采集更多数据,更重要的是判断哪些数据对模型有用、怎么评测、评测完又怎么反哺训练。马辰的研究,正好卡在这条链路里最容易被忽略、却决定数据能否产生价值的一环。
答应得这么干脆,也因为两人的关系比这次创业更早。在 2021 年,经一位同样出自 Steve Liu 门下的教授介绍,金依力便在线上向马辰请教过图神经网络相关问题。后来,他赴麦吉尔大学与 Mila 攻读联培博士,师从马辰的博士导师 IEEE Fellow、加拿大工程院院士 Steve Liu 教授,两人也由此成为同门师兄弟。直到 2024 年金依力赴香港访问,两人第一次在线下见面。
马辰当时对他的印象是「一个很乖的学生」。如今再谈起,他的评价变成了「非常全面的创业者 」。

从左至右:马辰、Steve Liu、金依力
面对一支 00 后团队,身为 90 后的马辰戏称为「小天才搭配老伙计」。
年轻团队有活力和执行力,他更多参与研究方向的把控和建议。技术问题不因为资历预设谁说了算——「谁对听谁的」。他说,讨论之后自然会形成判断。
更吸引他的,是工业界贴近实际的问题。
映界创办之初,就拿到了带着真实场景的客户。学术研究里的问题常常经过精心裁剪,公司里则要面对数据噪声、效率和工程约束,更「dirty」、更 hands-on。
「你一定要去做,做了之后你才有 feedback,再去调整再去做。」马辰说。
团队的分工,也恰好对应映界路线上的不同环节:空间感知和采集团队把真实环境转化为数据,马辰的数据智能研究则帮助团队判断,这些数据对模型到底有没有用。
数据不是越多越好,问题是「对谁有用」
马辰长期研究数据与模型的关系。
在机器学习的各类任务里,数据并非越多越好。不同样本对模型的作用不同,关键在于它们是否帮助模型完成目标任务。
他把这个思路带到了空间数据上。
真实场景采集会产生连续视频、深度信息和其他传感器数据。其中有重复和噪声,也有关键但稀少的状态变化。对一个任务有价值的数据,对另一个任务未必有用。
「数据的价值,可能是对任务的增益来决定的。」马辰说。
这意味着,空间数据治理不能停在去重、清洗和标注。更关键的是建立任务关联:数据覆盖了哪些场景和状态?能不能支持模型提升特定能力?加入这些样本后,模型有没有可测量的改善?
但这并不意味着已经有了一个通用的「好数据」指标。
团队曾讨论,能不能用信息熵或信息论建立更普适的判断方式。问题是,数据价值与任务、模型和评测条件高度相关,通用度量仍然困难。现阶段常见的办法,是把数据放进模型或代理模型,观察它对目标任务的影响。
所以,数据选择更像一项闭环工作:先定义任务,再选择数据和评价指标,最后根据模型表现修正数据策略。
对映界来说,要回答的不只是「采多少」,还有「哪些数据能支持空间智能、哪些数据能暴露模型的能力边界」。
模型「看见」了,为什么还是不懂空间?
基础模型看过大量图像和视频,并不意味着它自动拥有稳定全面的空间智能。
二维画面是三维环境的投影。视频帧记录外观随时间变化,却未必直接提供对象身份、几何位置、遮挡关系或状态变化。
马辰举了一个例子。一个包裹从货架上被拿走,途中被遮挡,之后在别处再次出现。模型需要关联前后观测,判断是不是同一个对象,记录位置和状态变化。如果证据不足,它还应该保留不确定性,而不是给出没有依据的确定答案。
这类问题,要求系统超越单帧检测。
单帧检测回答「这一刻看到了什么」;动态状态表示还要回答「它之前在哪里、发生了什么、现在能否确认」。
跨视角、跨时间的身份关联和状态维护,是模型从视觉识别走向持续空间理解的关键。
沿着这个思路,映界把空间信息拆成几何、对象、关系、记忆和不确定性,并规划了从多模态采集、时空对齐、空间结构化,到动态追踪和预测验证的处理链路。
在采集端,他们的装置结合深度与红外等信息,为场景理解提供视觉之外的线索。
技术上的关键,还包括统一时间戳和坐标系、跨帧保持对象身份、记录轨迹与状态变化,并保留原始证据和数据来源。
经过这些处理,数据才可能从一段段视频变成可以按对象、时间、位置和任务检索、选择与核验的样本。
实时动态语义空间信息
评测一个空间模型,不能只给一个总分
数据整理好了,还要有办法检验模型到底懂不懂空间。马辰团队最近在做空间智能基准研究,希望形成一套评测不同模型空间智能能力的 Benchmark 。
空间评测的输入可能是单张图像、多视角照片、完整视频、实时视频流、三维传感器数据,也可能是可交互环境。
任务则可能是测量位置、跨视角关联对象、预测未来状态、主动获取证据,甚至完成行动。
只看输入模态或一个总分,很容易把不同能力混为一谈。
给模型一段完整视频后提问,和让视频逐步到达、要求它边观察边更新记忆,评估的并不是同一件事。前者可以依赖事后回看,后者还要考验状态维护、响应时机和信息预算。
如果允许模型移动相机获取新视角,评测就从被动推理扩展到了主动观察和交互决策。
所以,模型答对一道空间问答题,不能单独证明它理解了真实空间。
更有解释力的评测,需要明确几件事:模型看到了哪些信息?能不能回看历史?是否允许交互?标准答案来自真实传感器还是仿真状态?最终分数对应的是几何精度、身份连续性、预测能力,还是任务成功?
真实场景也不天然等于可靠真值。
传感器标定误差、三维重建偏差和人工标注都会影响参考答案。仿真环境便于控制和复现,但仿真里的收益未必迁移到现实。
因此,评测需要说明证据来源,并通过未见场景、未来观测或受控交互来检验模型,而不能只依赖单一准确率或模型自评。
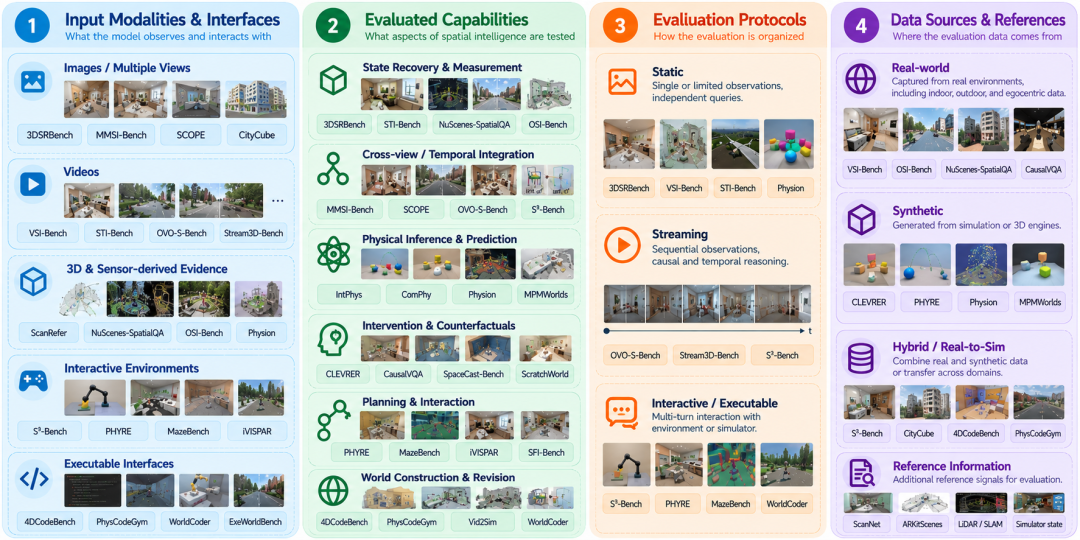
空间智能基准评测体系
评测不是为了排名,而是告诉训练「下一步补什么」
在马辰看来,评测不只是给模型排名,更是为了指出下一轮训练应该补什么数据。如果模型频繁在遮挡后丢失对象身份,下一轮就需要针对遮挡、跨视角关联和状态恢复,构建数据和任务。
映界正在探索:用真实场景数据评估基模,再把模型的失败模式反馈到数据采集和训练中。公司把空间数据、评测基准和后训练环境列为重点方向。
后训练环境,为将失败模式转化为训练任务与学习信号提供了载体。它围绕模型暴露的能力缺口,将可重复执行的任务、模型可用的观测与交互接口,以及基于空间证据的验证机制组织在一起。模型通过观察、作答或工具调用完成任务,环境依据证据与任务规则核验结果、返回反馈或奖励,再由训练器利用交互轨迹与反馈更新模型。
相比只交付静态数据集,这种形式有机会真正接入模型的后训练流程。
但要让反馈可信,有个前提:系统需要确保用于核验的参考状态没有泄露给模型,并且让奖励对应真实的时空证据,而不是只判断答案听起来是否合理。
怎么证明这套方法有效?马辰提出,在同一基模、相同预算条件下比较不同监督方式,并进一步关注未见场景表现、任务成功率、失败恢复和接入成本。
这套评测最终要回答的,是空间监督是否让模型更可靠地完成任务。
在「 robotics的 GPT moment 」之前
映界科技正沿着一条清晰的 pipeline 推进:数据生产工程、后训练环境与验证研究,以及客户模型接入。
这条路线的价值,最终要由实际结果说明:空间数据能不能进入现有训练管线?评测能不能定位模型短板?训练反馈能不能带来跨场景、可复现的能力提升?
马辰期待,未来会出现「robotics 的 GPT moment」。
但在那之前,空间智能还要经历更细致的任务定义和真实环境验证:从识别对象到持续追踪,从被动回答到主动观察,从模型分数到可核验的任务结果。
访谈最后,马辰提到自己喜欢的一句话:
Ever tried. Ever failed. No matter. Try again. Fail again. Fail better. ——Samuel Beckett
尝试过,失败过,都没关系;再试一次,再失败一次,但要败得更好。
这是模型在训练中提升智能的过程,也是科研与创业向前的路径:走进真实的 environment,从 observation 中理解问题,用 action 探索可能,依据 reward 修正认知,让每一次失败都留下可学习的信号,让每一次训练都有机会突破原有的边界。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com



