
> 作者:李剑锋
1. 前言
1.1 课程回顾
前面讲服务化部署时,我们使用 vLLM 将 Qwen3-0.6B 部署为一个持续运行的模型服务,并通过 curl 和 OpenAI SDK 向服务发送请求。
模型运行在云服务器上,客户端只需要按照接口要求提交问题,就能够接收模型返回的回答。至此,我们已经完成了从模型加载到 API 调用的基本流程。
有了这个接口之后,我们就可以尝试将模型接入具体应用。例如,制作一个课程问答页面,让学生在网页中输入问题,再由页面把请求交给云端模型处理。对于使用页面的学生来说,他们不需要知道模型文件保存在什么位置,也不需要自己编写模型加载代码,只需要等待页面返回回答。
不过,当一个人提问时服务能够正常回答,并不意味着多人同时使用时也会有相同的体验。假设一整个班级的学生在上课时陆续打开页面,并有几位学生几乎同时提交问题,服务器就需要在相近的时间内处理多条请求。这时,有的学生可能很快看到回答,有的学生则可能需要等待更长时间。
随着同时进行的请求增多,服务能否正常处理这些请求?每位用户需要等多久才能看到回答?服务器每秒能够生成多少内容?如果请求失败,又应该怎样发现?这些问题无法仅凭一次接口调用的结果回答,因此我们还需要进一步对已经部署好的服务进行测评。
1.2 服务化测评简介
大模型服务化测评,就是让测评工具按照设定的方式向模型服务发送一组请求,记录服务返回的情况,再根据这些记录分析服务在不同负载下的运行表现。例如,我们可以先让客户端一次只发送一条请求,再逐步增加同时进行的请求数,观察等待时间、输出速度和成功率是否发生变化。
这里的“同时进行”通常称为并发。如果本轮需要完成 16 次请求,我们既可以一次只处理 1 条,也可以让多条请求同时处于进行中。请求总数描述的是这一轮要完成多少次调用,并发数描述的是同一时间最多有多少条调用还没有结束,两者需要分开理解。
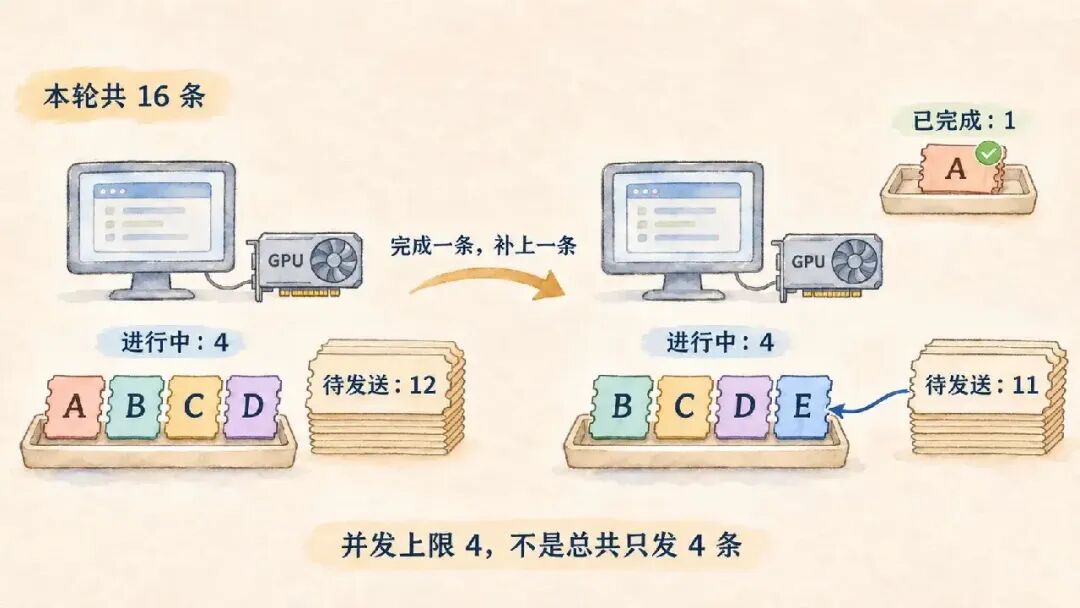
以 16 条正式请求、并发上限 4 为例:一条完成后,再补入下一条。
测评时,我们既关心单个用户的体验,也关心整个服务的处理能力。前者包括用户等待回答开始和等待完整回答结束所花的时间;后者可以通过一段时间内成功完成的请求数量、生成的 token 数量等信息来观察。同时,还要检查请求是否成功,避免只看速度而忽略报错。
本节将继续使用前面准备的云服务器和 Qwen3-0.6B 模型,先了解 vLLM 服务的启动参数,再使用 EvalScope 发送不同并发的请求。完成 vLLM 测试后,我们还会使用 Transformers Serve 运行同一份模型,通过两组报告学习怎样比较和解释服务的表现。
需要注意,本节采用随机生成的输入来构造性能测试负载,重点观察的是服务处理请求的过程,不能根据这些结果判断模型回答是否准确。如果希望评估模型的知识、推理或实际任务能力,还需要另行准备相应的问题、参考答案和评价方法。
2. 部署参数简介
2.1 启动模型服务
首先,我们继续使用前面配置好的 vLLM 环境。在远程终端中激活环境,并启动 Qwen3-0.6B 服务:
source /root/venvs/vllm/bin/activate

vllm serve /root/models/Qwen3-0.6B \
  --served-model-name Qwen3-0.6B \
  --host 127.0.0.1 \
  --port 8000 \
  --dtype half \
  --max-model-len 4096 \
  --max-num-seqs 8 \
  --gpu-memory-utilization 0.5 \
  --enforce-eager
本次测评程序和模型服务都运行在云服务器上,因此继续使用服务器本机地址 127.0.0.1:8000。地址、端口和接口调用的内容,前面讲服务化部署时已经介绍过。服务启动完成后保持当前终端运行,再打开另一个终端执行测评命令。
2.2 理解启动参数
前面讲服务化部署时,我们已经使用过 vllm serve 命令。结合本次测评,再来看看这条启动命令中的主要参数。
/root/models/Qwen3-0.6B | |
--served-model-name | Qwen3-0.6B,后续请求中的模型名需要与它一致。 |
--host--port | 127.0.0.1:8000 供云服务器本机访问。 |
--dtype half | |
--max-model-len 4096 | |
--max-num-seqs 8 | |
--gpu-memory-utilization 0.5 | |
--enforce-eager |
其中,--gpu-memory-utilization 0.5 是按照 GPU 总显存的 50% 为当前 vLLM 实例规划模型执行所需的空间,**并不是把 GPU 的计算能力限制到 50%**。
模型权重和前面讲推理时提到的 KV 缓存都需要显存,因此这个比例会影响模型能否顺利加载,以及可用于处理请求的缓存空间。
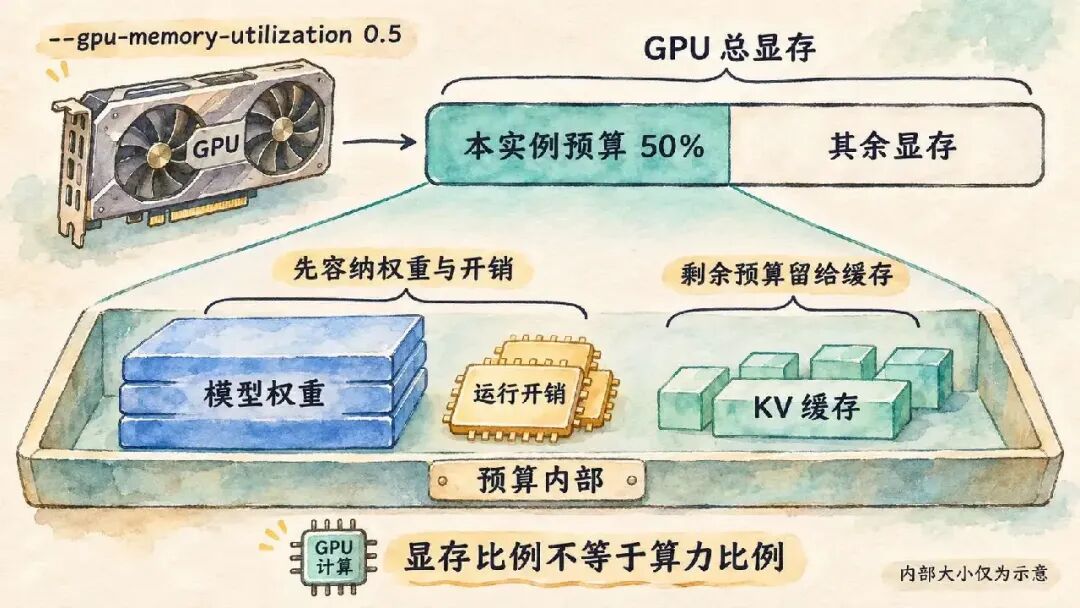
在本实例的显存预算内,先容纳模型权重和运行开销,剩余预算用于 KV 缓存;内部大小仅为示意,显存比例不等于算力比例。
--enforce-eager 则控制模型的执行方式。CUDA Graph 可以记录并重放部分 GPU 操作,减少重复执行时的开销;启用 --enforce-eager 后,vLLM 不走这条优化路径,但仍然使用 GPU。本次先沿用这一设置,实际性能影响可以通过测试观察。
另外,--max-num-seqs 与稍后测评命令中的并发数并不相同:前者限制引擎一轮处理的序列数,后者控制客户端同时进行的请求数。例如,并发为 4 时,服务不需要等到凑满 8 条请求才开始处理。
2.3 其他常用部署参数
除了本次启动命令中使用的参数,vLLM 还提供了一些常见设置,可以根据模型、硬件和使用场景进行调整¹。
--max-num-batched-tokens | |
--tensor-parallel-size | |
--enable-prefix-caching--disable-prefix-caching | |
--kv-cache-dtype | |
--quantization | |
--api-key |
--max-num-batched-tokens 和 --max-num-seqs 都与调度有关,但限制的内容不同:前者限制一轮处理的 token 数,后者限制一轮处理的序列数;它们也都不同于单条请求的最大上下文长度。
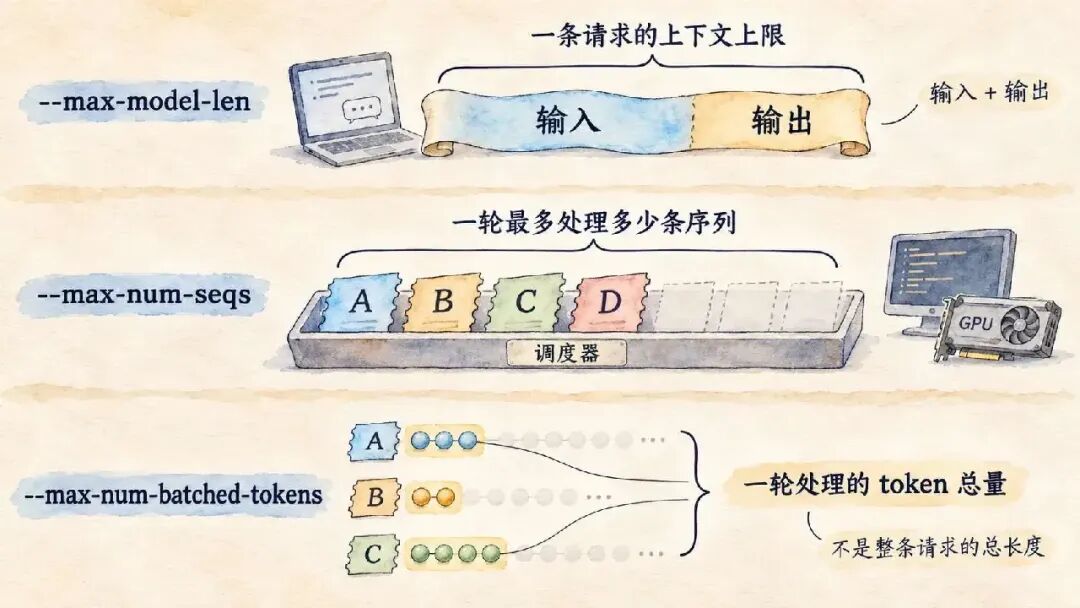
三个参数约束不同对象:单条请求的上下文、单轮调度的序列数、单轮处理的 token 总量。彩色 token 仅示意本轮工作量。
前缀缓存适用于多条请求包含相同开头内容的情况,例如多次围绕同一份长文档提问。服务可以复用相同前缀已经计算过的 KV 缓存,减少重复处理;这并不是直接复用之前的完整回答。比较性能时,也应记录前缀缓存是否启用⁶。
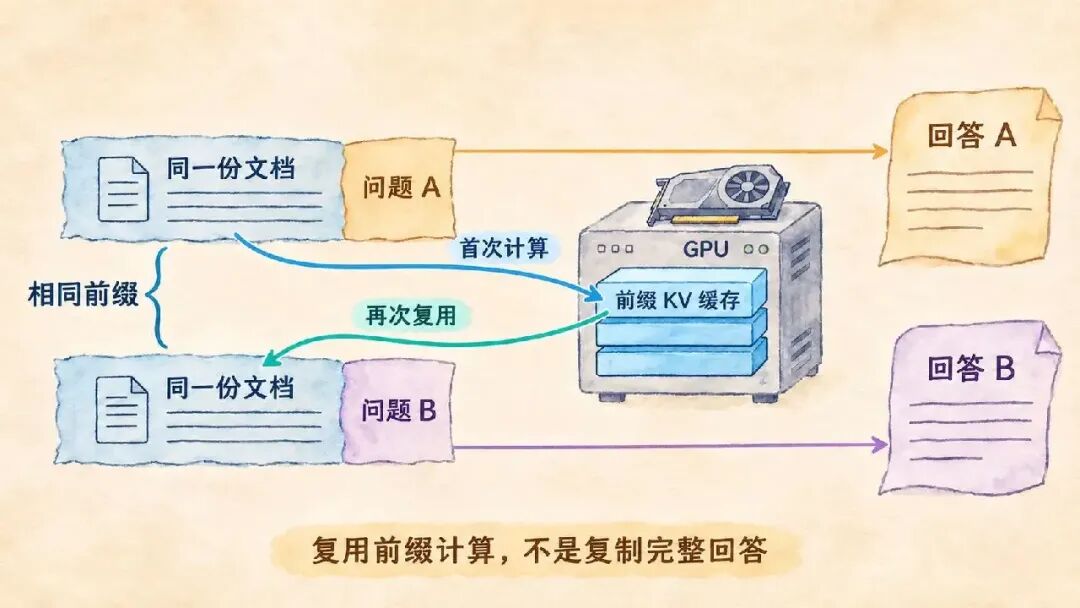
相同文档前缀的 KV 计算结果可以复用,不同问题仍需要分别生成回答。
这些参数不需要全部写进启动命令。未指定时,vLLM 会使用相应版本的默认设置;实际使用时可以通过 vllm serve --help 查看当前环境支持的选项。
3. 评测原理
3.1 一条请求需要经历什么
前面讲大模型推理过程时,我们已经了解过模型会先处理输入,再逐步生成回答。将模型部署成服务后,一条请求还需要经过客户端发送、服务端调度和结果返回等环节,因此用户的等待时间可能同时受到排队、模型计算和数据传输的影响⁵。
如果使用流式响应,客户端可以在生成过程中陆续收到内容;如果使用非流式响应,通常需要等完整回答生成后再一次性接收。接下来,我们就从这些过程入手,看看如何衡量服务的运行表现。
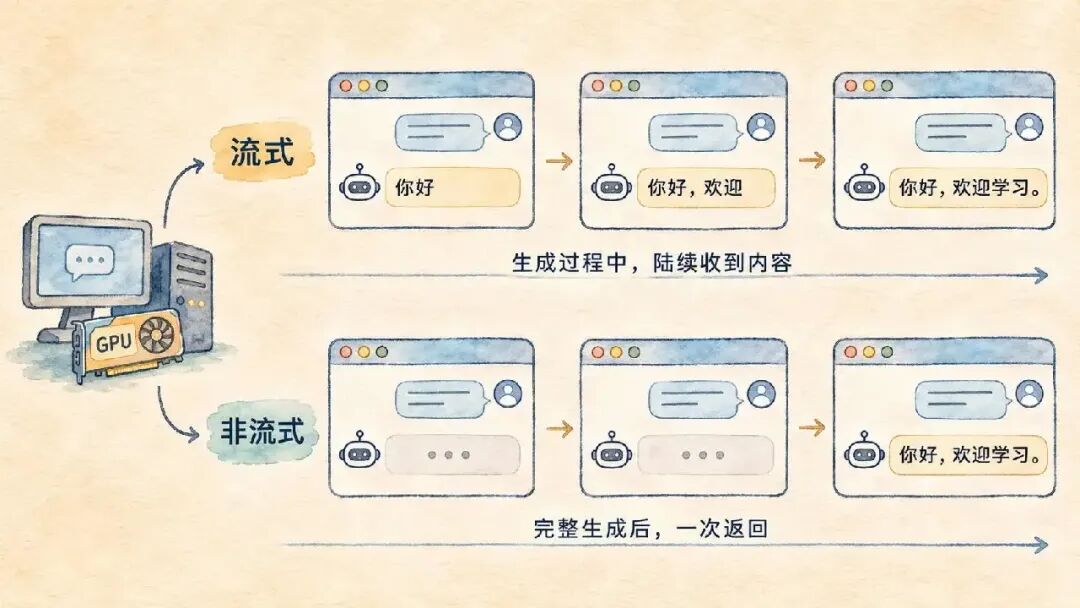
流式与非流式的接收方式对照;画面仅为示意,不表示两种模式的实际耗时一定相同。
3.2 常用性能指标
从刚才的过程可以看出,用户既关心什么时候开始收到回答,也关心完整回答需要多久;当多个请求同时到来时,还需要关注服务整体的处理能力。因此,性能测试通常会同时统计延迟、吞吐量和成功率等指标。
以流式回答为例,TTFT 对应开始收到输出前的等待,TPOT 则反映后续输出的平均速度。请求吞吐量和输出 token 吞吐量关注的是整套服务的产出,两者的统计单位不同。
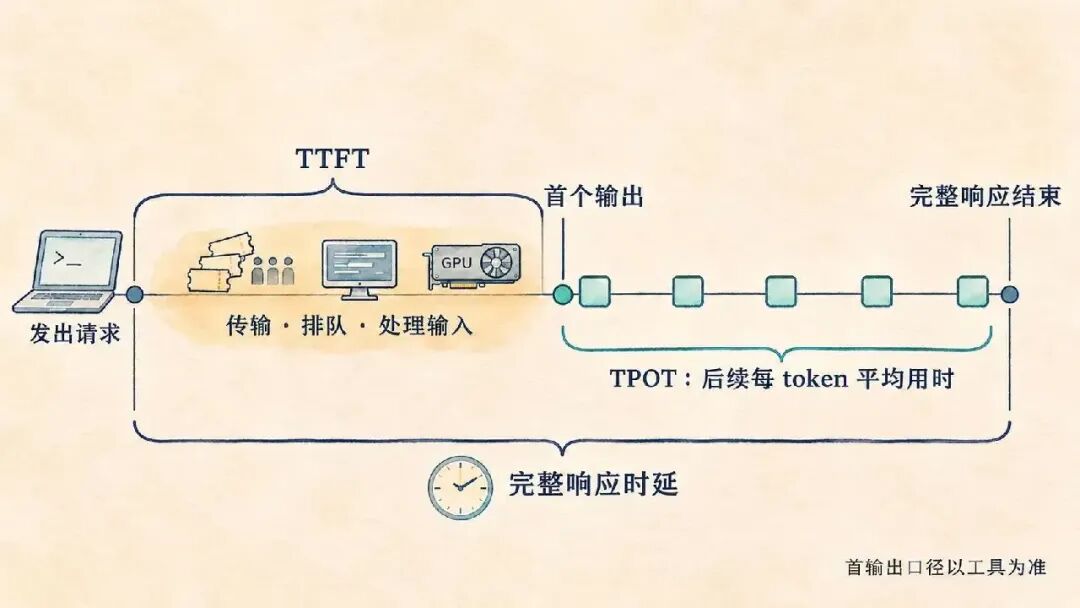
从客户端观察一条请求:首输出等待、后续输出用时和完整响应时延。
例如,某轮测试在 10 秒内成功完成 20 条请求,并产生 1000 个输出 token,那么请求吞吐量约为 2 req/s,输出吞吐量约为 100 token/s。并发提高后,整体吞吐量可能增加,但单条请求的等待时间也可能变化,因此需要结合多个指标判断。
报告还可能提供 P95、P99 等百分位指标,用于观察等待较久的请求。例如,P95 响应时延表示约 95% 的请求时延不超过该数值。本节每档只有 16 条正式请求,高百分位容易受到个别请求影响,应谨慎解读²。
需要注意,不同服务返回的流式数据块可能不同,有的数据块只包含角色信息而没有正文。因此,比较 TTFT 前还需要确认测评工具记录的“首个输出”采用什么口径,不能直接把它等同于第一个正文 token 出现的时间。
4. 评测框架安装与 vLLM 实测
4.1 安装 EvalScope
为了测试模型服务的运行表现,我们这里使用 EvalScope 的性能测试功能。它可以向服务发送多条请求,模拟不同并发,并统计响应时间、吞吐量和成功率等数据。前面讲模型能力评估时,我们也使用过 EvalScope;本次关注的是服务处理请求的性能。
接下来保持模型服务所在终端运行,在云服务器上新建一个终端,为 EvalScope 创建独立的虚拟环境并安装性能测试依赖:
python3 -m venv /root/venvs/evalscope
source /root/venvs/evalscope/bin/activate

pip install -U "evalscope[perf]"
安装完成后,终端会显示已安装的依赖。下面是本次准备环境时保留的安装截图:
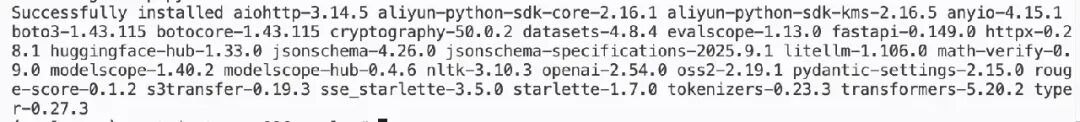
截图展示了本次安装时的依赖版本。由于安装命令会获取可用的新版本,实际运行时可以通过 evalscope perf --help 查看支持的参数,并记录软件版本,方便后续比较。
4.2 发送不同并发的测评请求
安装完成后,就可以通过 EvalScope 向 vLLM 服务发送请求,开始测试。确认运行模型的终端保持开启,然后在 EvalScope 终端执行:
evalscope perf \
  --model Qwen3-0.6B \
  --url http://127.0.0.1:8000/v1/chat/completions \
  --api openai \
  --dataset random \
  --tokenizer-path /root/models/Qwen3-0.6B \
  --min-prompt-length 128 \
  --max-prompt-length 128 \
  --max-tokens 128 \
  --parallel 1 2 4 8 \
  --number 16 16 16 16 \
  --warmup-num 8 \
  --stream \
  --extra-args '{"chat_template_kwargs":{"enable_thinking":false}}'
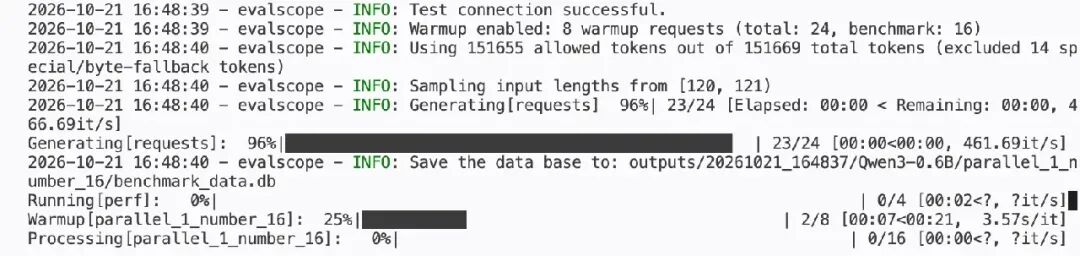
测试开始后,终端会显示连接检查、预热请求和正式请求的处理进度。下图是当时的运行过程:
4.3 理解测评命令
这条命令依次测试 1、2、4、8 四档并发,每档安排 16 条正式请求。命令中的主要参数如下:
--model | --served-model-name 对应。 |
--url | |
--api openai | |
--dataset random | |
--tokenizer-path | |
--min-prompt-length--max-prompt-length | |
--max-tokens 128 | |
--parallel 1 2 4 8 | |
--number 16 16 16 16 | |
--warmup-num 8 | |
--stream | |
--extra-args |
重点区分 --parallel 与 --number。以并发为 4 的一档为例,客户端最多同时保持 4 条尚未完成的请求,这一档一共需要完成 16 条正式请求。每档另外安排 8 条预热请求,预热数据不计入正式性能指标,具体衔接方式可能随版本变化³。
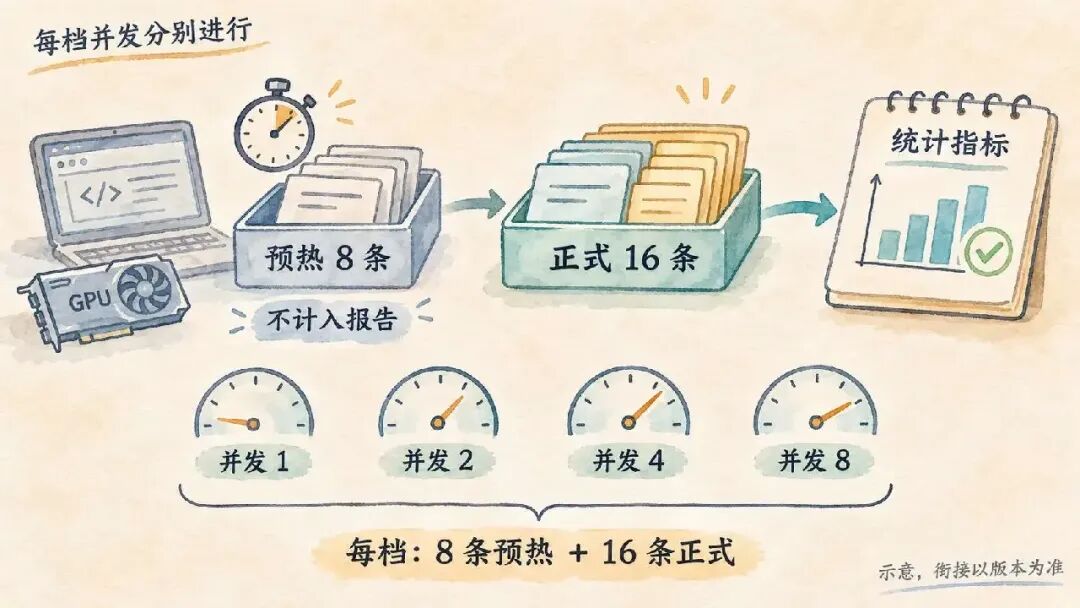
四档并发分别测试,每档的 8 条预热请求不计入 16 条正式请求的指标。
输入长度设置为 128 token 是测试目标,经过分词和聊天模板等处理后,本次报告中的平均实际输入为 132 token。--max-tokens 128 则是输出上限,模型也可能提前结束,因此比较时应同时查看报告中的实际输入和输出长度。
另外,--api openai 表示使用兼容的接口格式,不代表请求被发送到 OpenAI。实际访问地址由 --url 指定,本次测试访问的仍然是云服务器上运行的 vLLM 服务。
4.4 查看 vLLM 的测评结果
测试完成后,EvalScope 会生成汇总报告。下图截取自本次 vLLM 测评报告,展示了四档并发的主要指标:
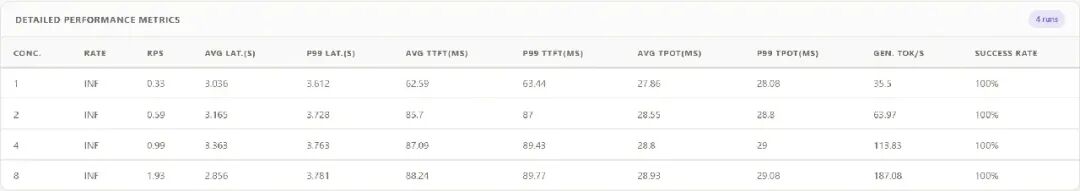
vLLM 原始报告的性能指标概览
报告中的四行对应四档并发。为了便于阅读,我们将主要数据整理如下:
吞吐量
响应时延与首输出等待
后续输出与成功率
先看成功率:四档并发各有 16 条正式请求,报告共记录 64 条,全部成功返回。接下来,我们可以选择其中一行,看看每个数值分别说明了什么。
以并发为 4 的这一行为例,客户端最多同时保持 4 条请求进行中。这一档的 16 条请求全部成功,服务平均每秒完成约 0.99 条请求,并输出 113.83 个 token;每条请求从发出到完整结束的平均时间为 3.363 秒。
这里的 0.99 req/s 和 3.363 秒并不矛盾:前者统计整套服务平均每秒完成多少条请求,后者统计单条请求平均等待多久。由于多条请求可以同时进行,服务完成请求的间隔可以短于某一条请求自身经历的时间。
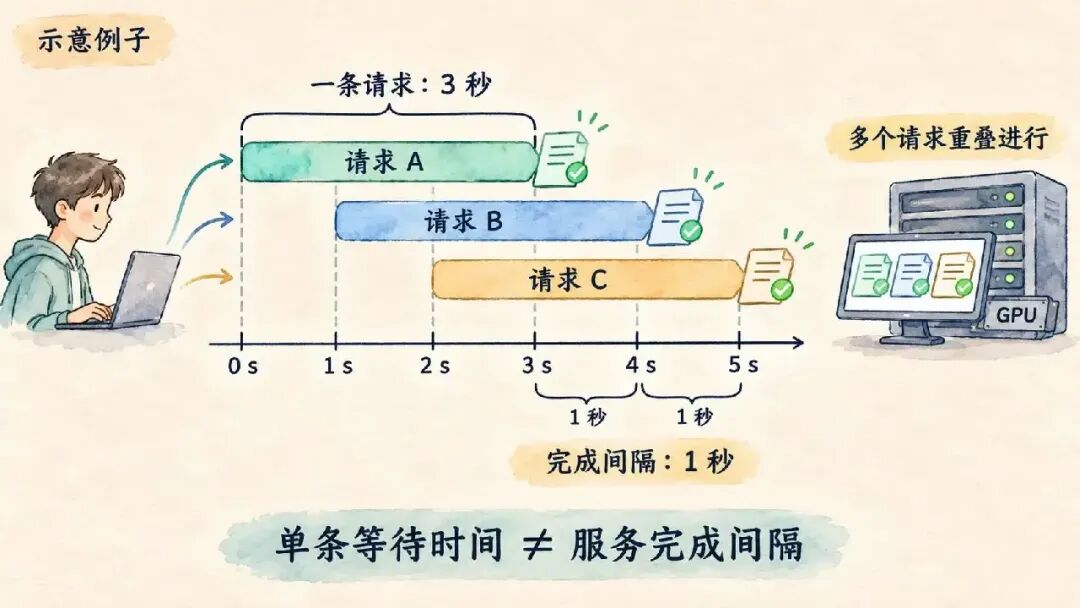
示意例子,并非本次实测数据:每条请求持续 3 秒,重叠进行时可以每隔 1 秒完成一条。
同一行的平均 TTFT 为 87.09 毫秒,平均 TPOT 为 28.80 毫秒,分别用于观察首个输出前的等待和后续输出的平均用时。它们反映的是一次响应的不同阶段,不能直接与整套服务的输出吞吐量等同。
将四档输出吞吐量画成折线后,可以更直观地观察并发数变化与服务整体输出量之间的关系:
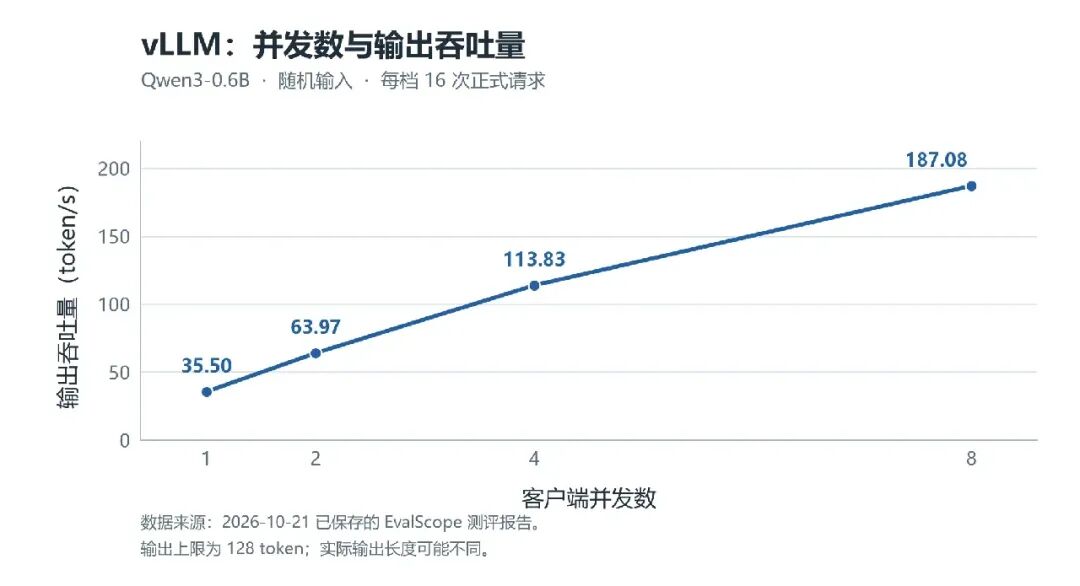
vLLM 在不同并发下的输出吞吐量
图中的横轴是客户端并发数,纵轴是服务每秒生成的输出 token 数。比较并发为 1 和 8 的结果,输出吞吐量从 35.50 提高到 187.08 token/s,约为原来的 5.27 倍,说明这次测试中服务在较高并发下能够在单位时间内完成更多输出。
需要注意,187.08 token/s 是这一档所有请求合在一起的平均输出量,并不表示每位用户都能以这个速度收到回答。整体吞吐量增加,也不等于单条请求的等待一定缩短。
折线只是将 1、2、4、8 四个实测点连接起来,方便观察已测档位之间的变化;图上没有标出的并发设置仍然需要单独测试,不能把连线上的位置当成新的实测结果。
再结合表中的时延看,并发从 1 增加到 8 时,报告记录的平均 TTFT 从 62.59 毫秒变为 88.24 毫秒,平均 TPOT 从 27.86 毫秒变为 28.93 毫秒。
这说明在这组记录中,整体输出吞吐量提高的同时,工具记录的首输出等待并没有同步缩短;TTFT 的首输出口径还需要结合后面的说明理解。
并发为 8 时的平均完整响应时延为 2.856 秒,低于并发为 1 时的 3.036 秒,但不能仅凭这一项就认为并发越高、每条请求越快。报告显示,两档平均输出长度分别约为 96.7 和 107.8 token;较短的回答可能更早结束,分析时延时还要同时考虑实际输出长度等条件。
5. 对比评测
5.1 切换到 Transformers Serve
除了 vLLM,我们还可以使用之前接触过的 Transformers 为同一份 Qwen3-0.6B 提供接口,再通过 EvalScope 观察它的表现。Transformers Serve 同样提供 OpenAI 兼容接口,也支持连续批处理⁴。
为了便于比较,接下来沿用相同的模型目录、输入输出长度目标、并发档位和请求数。切换之前,先保存 vLLM 的报告,回到运行服务的终端按 Ctrl+C,并通过 nvidia-smi 确认模型进程已经退出。两个服务虽然使用不同端口,但同时运行时仍会占用同一张 GPU 的显存和算力。
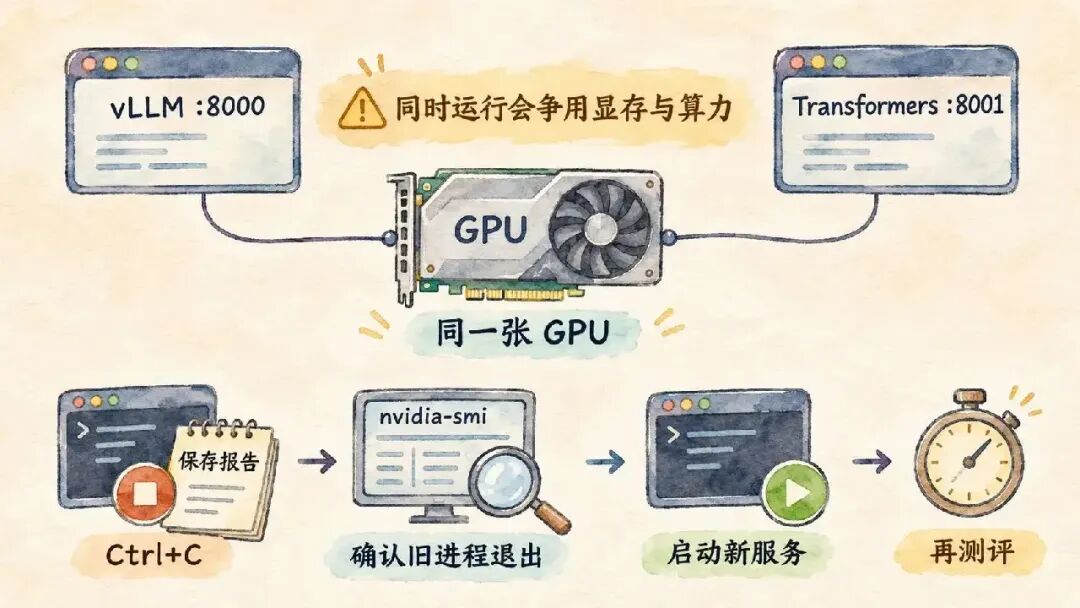
不同端口仍可能共用同一张 GPU:保存报告、停止旧服务并确认退出,再启动新服务测评。
下文命令展示的是对照测试流程;两份已有报告没有完整保存原始版本和启动日志,因此不能断定当时的所有设置都与当前命令完全一致。
5.2 安装并启动服务
新建一个终端,为 Transformers Serve 准备独立环境:
python3 -m venv /root/venvs/transformers-serve
source /root/venvs/transformers-serve/bin/activate

python -m pip install -U pip uv

uv pip install torch "transformers[serving]" requests \
  --default-index http://mirrors.baidubce.com/pypi/simple/ \
  --allow-insecure-host mirrors.baidubce.com
这里沿用课程环境中使用的软件包来源。PyTorch 需要与服务器的 GPU、驱动和 CUDA 环境相适配;不同版本的 Transformers 支持的服务参数也可能变化。安装后可先执行 transformers serve --help,确认当前版本是否支持下面的参数,并记录实际版本。
接下来启动服务:
transformers serve /root/models/Qwen3-0.6B \
  --host 127.0.0.1 \
  --port 8001 \
  --dtype float16 \
  --attn-implementation sdpa \
  --reasoning off \
  --continuous-batching \
  --no-cb-use-cuda-graph
这条命令加载同一份模型,并将服务放在 8001 端口。--reasoning off 用于关闭支持该选项的模型的思考模式,--continuous-batching 开启连续批处理,--no-cb-use-cuda-graph 关闭这一执行路径的 CUDA Graph。命令中的反斜杠用于续行,复制时需要保留。
前面讲 vLLM 推理时提到过连续批处理:服务可以根据请求的进入和完成情况动态调整处理组合。这里的 --continuous-batching 让 Transformers Serve 也使用这一能力,具体性能仍需通过测试判断⁵。
--attn-implementation sdpa 指定模型加载时的注意力实现。启用连续批处理后,实际采用的后端还可能受到版本和环境依赖影响,应以服务启动日志为准。
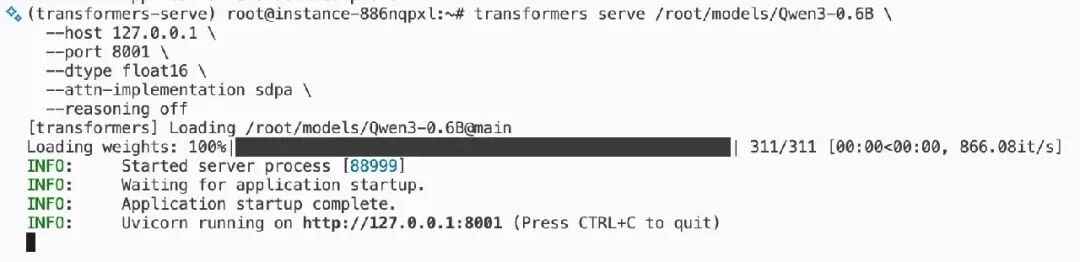
下图是已有的一次 Transformers 服务启动截图。截图中的命令没有显示上面后两项参数,因此它只能说明当时的服务已启动;要确认当前命令的实际配置,应查看本次启动命令和服务日志。
5.3 验证接口并开始测评
服务启动后,保持当前终端运行,在另一个终端中发送一条普通的聊天请求:
curl http://127.0.0.1:8001/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "/root/models/Qwen3-0.6B",
    "messages": [
      {
        "role": "user",
        "content": "请介绍一下大模型服务化部署"
      }
    ],
    "max_tokens": 128,
    "stream": false
  }'
这里的 model 使用启动服务时指定的模型路径。此前 vLLM 设置了 Qwen3-0.6B 作为服务名称,所以两次请求中的模型标识不同,但所指向的模型目录相同。
下面是当时返回结果的截图:
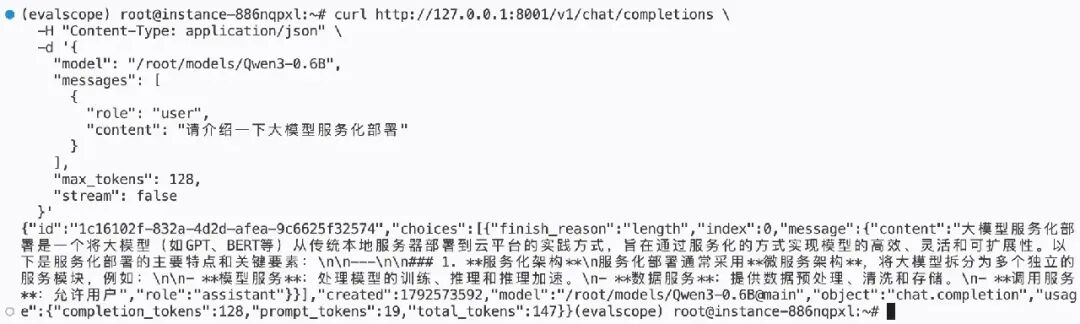
截图中可以看到接口返回了 choices 和 usage 等字段,说明服务已经接收请求并返回内容。
其中 finish_reason 为 length,completion_tokens 为 128,表示该回答达到本次设置的输出上限,内容可能被截断。这一步主要用于确认接口能够工作,并不能证明回答内容一定正确。
确认接口正常后,切换到 EvalScope 环境,沿用前面的负载设置进行测试:
source /root/venvs/evalscope/bin/activate

evalscope perf \
  --model "/root/models/Qwen3-0.6B" \
  --url http://127.0.0.1:8001/v1/chat/completions \
  --api openai \
  --dataset random \
  --tokenizer-path /root/models/Qwen3-0.6B \
  --min-prompt-length 128 \
  --max-prompt-length 128 \
  --max-tokens 128 \
  --parallel 1 2 4 8 \
  --number 16 16 16 16 \
  --warmup-num 8 \
  --stream \
  --extra-args '{"chat_template_kwargs":{"enable_thinking":false}}'
与 vLLM 测试相比,这里主要更换了接口地址和模型标识;目标输入长度、输出上限、并发档位、正式请求数及预热数保持一致。两套服务能否按相同方式处理聊天模板、生成参数和思考模式,还需要结合实际版本与运行日志检查。
5.4 对照两份报告
下图是本次 Transformers 测评报告中的指标概览:
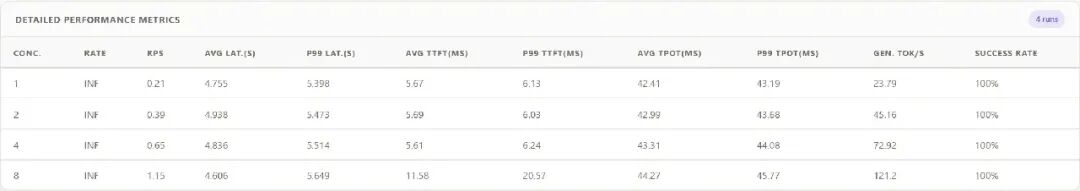
Transformers 原始报告的性能指标概览
报告中四档并发各有 16 条正式请求,64 条请求全部成功。将两份报告中的输出吞吐量放在一起,可以得到下面的对照:
吞吐量比值
把两套服务的输出吞吐量放在同一张折线图中,可以更清楚地比较各档并发下的表现:
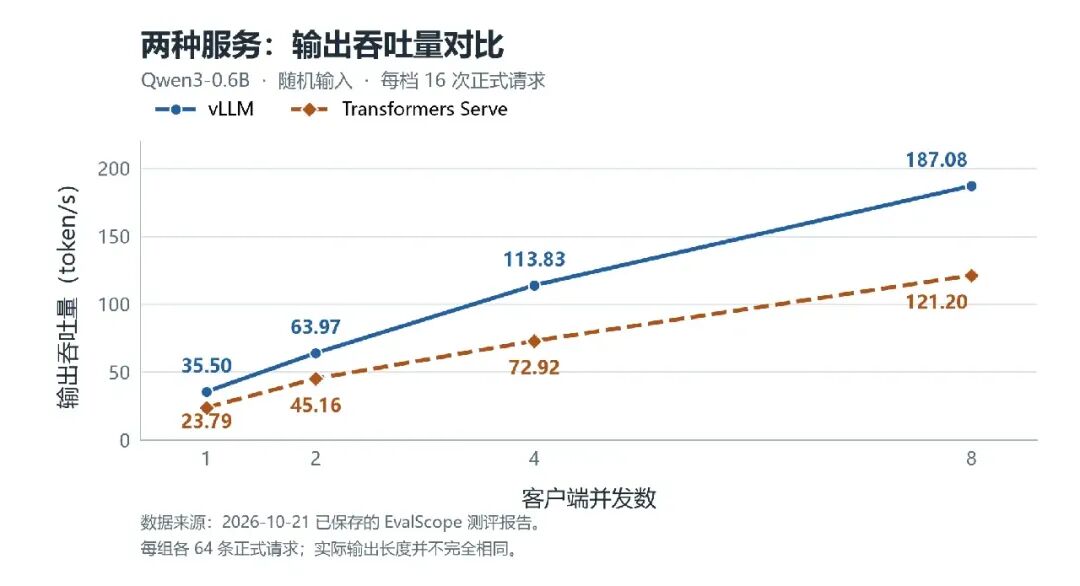
vLLM 与 Transformers Serve 输出吞吐量对比
从这四档记录可以看到,随着并发增加,两套服务的整体输出吞吐量都在提高。例如,并发为 8 时,vLLM 为 187.08 token/s,Transformers Serve 为 121.20 token/s,前者每秒约多输出 65.88 个 token,约为后者的 1.54 倍。
这里比较的是这一档测试中服务的整体输出吞吐量,并不是说每位用户看到回答的速度都提高了 1.54 倍。四档结果中,vLLM 的输出吞吐量约为 Transformers Serve 的 1.42~1.56 倍,但这只是两份已有报告在当前测试条件下记录的结果。
为了进一步理解这一档的结果,我们可以把并发为 8 时的请求数量、吞吐量、响应时间和实际输入输出长度放在一起比较:
这一档中,两套服务都成功完成了 16 条请求。报告记录完成这 16 条正式请求的整轮测试时间,vLLM 约为 8.27 秒,Transformers Serve 约为 13.88 秒;同时,表中的平均响应时延描述的是单条请求从发出到完整结束的平均等待。
由于多条请求可以重叠进行,整轮测试时间和单条请求的平均等待不是同一个指标。
此外,两份报告这一档的平均输入长度都是 132 token,但平均输出长度分别为 96.7 和 105.1 token。它们是 16 条请求各自的平均值,并不代表每条回答长度相同;相同的平均输入长度也不能证明两次使用了完全相同的输入。比较响应时延时,需要把这些差别一起考虑。
除了观察整个服务每秒生成多少内容,我们也可以看看单条请求从发出到完整结束,平均需要多少时间。下图中的数据同样来自两份已有报告:
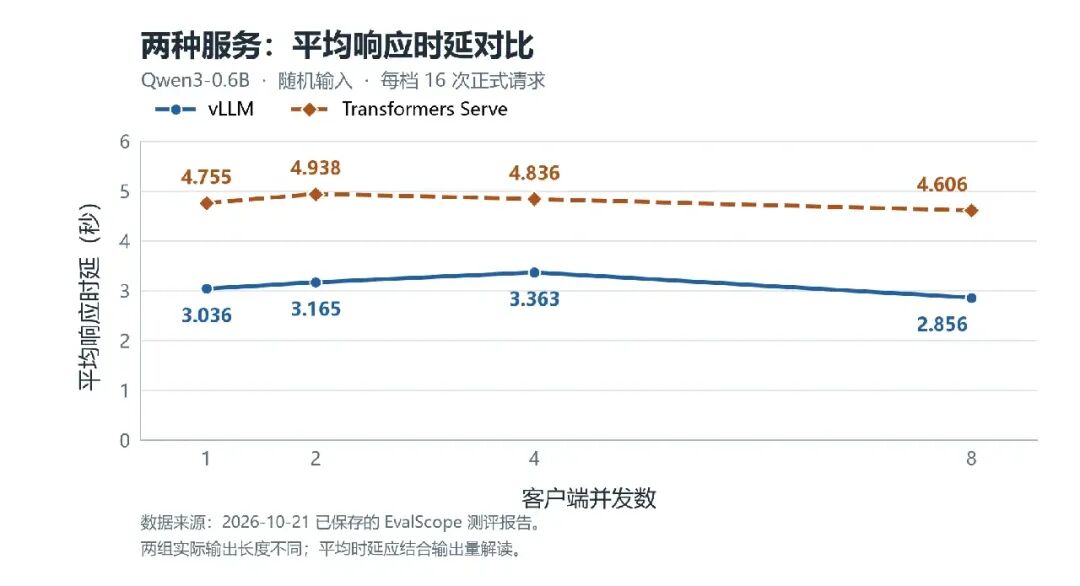
vLLM 与 Transformers Serve 平均响应时延对比
从图中可以看到,在这四档已有记录中,vLLM 的平均完整响应时延均低于 Transformers Serve。例如,并发为 8 时,两者分别为 2.856 秒和 4.606 秒,相差约 1.75 秒。
不过,这些数值都是该档请求的平均结果,不代表每个人都恰好等待这么久,也不能说明每一条 vLLM 请求都比另一套服务更快。
结合上表,两个服务的平均输出长度并不相同,较短的回答可能更早结束,因此不能仅凭平均时延认定固定输出量下的速度差异。每档只有 16 条正式请求,也不足以说明长期运行时的稳定性。
两套服务的平均 TPOT 同样值得观察。并发为 8 时,报告中 vLLM 为 28.93 毫秒,Transformers Serve 为 44.27 毫秒。按照这一指标的含义,数值较小通常表示首个输出之后,每个输出 token 所需的平均时间较短。
但 TPOT 的计算与总响应时间、输出数量和首输出计时有关;在两套服务的首输出计时口径没有核实之前,不宜把这两个数字直接解释为纯粹的 GPU 解码时间。
再看 TTFT,vLLM 在四档中的平均值约为 62.59~88.24 毫秒,Transformers Serve 约为 5.61~11.58 毫秒。从报告数字看,后者更小,但这还不足以证明它更早生成了第一个正文 token。
一种需要排查的情况是:服务可能先发送只包含 role 的数据块,相当于先告诉客户端“接下来由助手回答”,但这时正文还没有出现。如果测评工具将这样的数据块当作首个输出,记录的 TTFT 就可能早于正文实际出现的时间⁴。
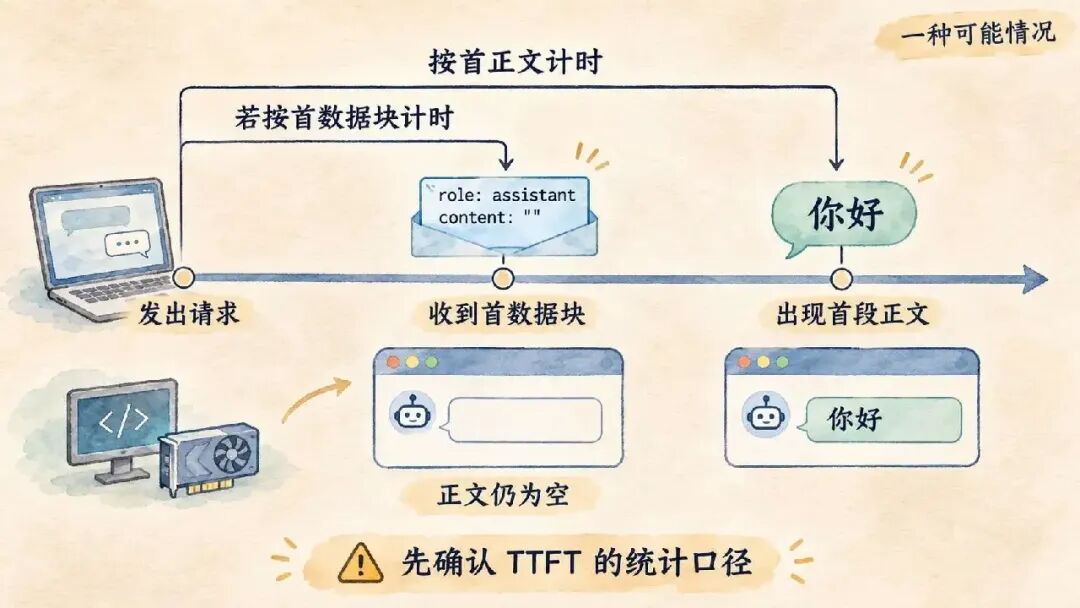
一种可能影响 TTFT 的情况:收到数据块,不一定已经出现正文;这不是对历史测试原因的确认。
这只是可能影响计时的一种情况。两份历史报告没有保存完整的原始流式数据和所有工具版本,我们无法确认当时是否由此造成了差异,因此不根据这组 TTFT 数值判断两套服务谁更早输出正文。
将吞吐量和响应时延放在一起看,可以说在这次记录的四档并发下,vLLM 的整体输出吞吐量更高,平均完整响应时延也更低;但首个正文何时出现,仍不能仅凭现有 TTFT 结果判断。
另外,两份报告的累计输出分别为 6851 和 7149 token。虽然两边都设置了最多输出 128 token,实际输出量并不完全相同;历史测试的 GPU 信息、依赖版本、缓存状态及完整启动日志也没有全部留存。
因此,这组数据适合用于学习怎样阅读报告,不能当作所有环境下的固定性能排名。随机输入测试反映的是服务性能,也不能用来判断模型回答是否准确。
如果需要进一步比较,可以保存设备与驱动信息、软件版本、启动命令和日志,检查聊天模板、思考模式、采样设置以及实际输入输出长度,再使用相同负载重复多轮测试。这样才能更可靠地判断观察到的差异与哪些条件有关。
5.5 遇到问题时先检查哪里
如果运行结果与预期不同,可以先根据现象找到需要检查的环节,避免同时修改多个参数。
--help。 | |
6. 总结
本节在前面服务化部署的基础上,进一步关注模型服务面对多条请求时的运行表现。我们先回顾了 vLLM 的启动参数,了解显存比例、执行方式和调度设置,并认识了其他常用部署参数。
接着,我们使用 EvalScope 对 Qwen3-0.6B 服务进行性能测试,通过 TTFT、TPOT、响应时延、吞吐量和成功率,从单次请求与整体服务两个角度观察结果。测试分别设置了 1、2、4、8 四档并发,每档完成 16 条正式请求。
随后,我们使用 Transformers Serve 提供同一模型的接口,并结合两份已有报告进行对比。
在这组记录中,两套服务各有 64 条正式请求成功返回;并发为 8 时,vLLM 和 Transformers Serve 的输出吞吐量分别为 187.08 与 121.20 token/s。
需要注意,这些数字对应特定的测试条件。两组实际输出长度不同,历史版本与完整启动状态未全部留存,TTFT 的计时口径也需要进一步核实,因此不能将这次结果直接当作所有场景下的固定结论。
后续比较不同部署方式时,应尽量保持测试条件一致并记录实际运行环境;如果要判断回答是否正确,还需要使用前面讲模型能力评估时介绍的方法另行测试。
参考资料
[1] vLLM 服务启动参数文档:https://docs.vllm.ai/en/stable/cli/serve/
[2] EvalScope 性能测试与指标说明:https://evalscope.readthedocs.io/zh-cn/latest/user_guides/stress_test/quick_start.html
[3] EvalScope 性能测试参数说明:https://evalscope.readthedocs.io/zh-cn/latest/user_guides/stress_test/parameters.html
[4] Transformers Serve 官方文档:https://huggingface.co/docs/transformers/serve-cli/serving
[5] Hugging Face 连续批处理与请求处理过程:https://huggingface.co/docs/transformers/continuous_batching_architecture
[6] vLLM 前缀缓存说明:https://docs.vllm.ai/en/stable/features/automatic_prefix_caching/
-- 完 --
关注机智流并加入 AI 技术交流群,不仅能和来自大厂名校的 AI 开发者、爱好者一起进行技术交流,同时还有与、、、、等。
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群



