EgoExplorer团队 投稿
量子位 | 公众号QbitAI
家庭、实验室与工厂里的许多真实任务,都需要一边行走一边操作。
走向工作台、俯身取物、转身放置,手中的抓握始终不能松。
人形机器人要从人类演示中学会这种全身移动操作,所需的数据就必须在同一时间基准下,同时记录视觉、全身运动、手指动作与接触。
上海人工智能实验室Intern Robotics团队据此发布了EgoExplorer。这是一套可穿戴、无需改造环境的视觉-运动-触觉数据采集管线,包括采集系统与全身运动重建方法。
系统由5个追踪器、数据手套与头戴相机组成,同步记录第一视角视频、度量尺度的全身运动、双手关节姿态与手掌触觉,并配有专家引导的步骤级标注。
△第一视角视频、全身重建与手部触觉同步播放

移动操作,为什么卡在数据上?
移动操作的核心难点,在于运动与操作的耦合。机器人要去够取、抓握或搬运什么,决定了它要走到哪里、以什么姿态就位;而在行走、转身、俯身的过程中,手部又必须一直保持稳定抓握与精细控制。两者在同一时刻相互牵制,没法拆成“先走、再做”两个独立阶段。
机器人遥操作依赖专用硬件与持续的人力投入,难以规模化;人类演示则提供了更丰富的数据来源。要把它用到移动操作上,数据需要同时满足两方面要求。
一是模态完整。视觉提供任务语义与环境上下文;全身运动刻画行走、站姿与支撑;手指关节姿态描述抓握方式;接触则反映视觉难以判断的受力状态。四种模态需要在连续任务中对齐到同一时间基准,才能还原身体移动与手部接触是怎样同步演化的。
二是采集可规模化。移动操作发生在家庭、实验室、工厂等多样的真实环境中。依赖固定相机阵列的动作捕捉需要预先布置和标定每个录制空间,数据因此局限于少数场地。采集系统需要足够轻量、便于部署,能直接进入正在使用的场所,并能由多名采集人员在不同地点并行使用。
现有工作在各自方向上都有重要积累,但大多只记录了这种协同的一部分。以代表性工作为例:Ego4D拥有3670小时视频,但没有传感器测得的身体与手部状态;Nymeria拥有300小时可穿戴全身数据,但没有手指关节与触觉;EgoTouch、OpenTouch提供了触觉,时长分别为20小时和5小时,且不包含全身运动。这种片段式的记录,恰好丢掉了移动操作最核心的部分,也就是身体运动与手部接触之间的耦合。

△与代表性工作的采集模态对比
在上表对比中,EgoExplorer的采集管线在全部维度上都给出了完整支持:度量尺度的全身运动、非视觉位姿锚点、足部观测、手指关节、触觉、移动采集、移动操作与专家核验的步骤级标注。
五个锚点、两只手套、一台相机
采集系统的设计,需要在两种方案之间权衡。动作捕捉棚测量稠密但无法移动,纯视频方案部署方便却只能推断被遮挡的运动与接触。EgoExplorer选择的折中方案是:在关键关节处用稀疏追踪确定全身位姿,再用数据手套直接测量手指,并可选配触觉。全部设备都是可穿戴的商用现成硬件:
全身追踪:5个VIVE Ultimate Tracker分别佩戴于头部、双手背与双踝外侧,借助自身搭载的相机实现6自由度inside-out追踪,无需外部基站。头部与手部追踪器给出度量尺度的相机与末端轨迹;踝部追踪器记录落脚位置,并在头戴相机视野之外约束站姿与支撑;
第一视角相机:GoPro HERO13通过定制的3D打印支架与头部追踪器刚性固连,相机位姿由追踪器直接测量,不需要事后用视觉方法估计;
手部采集:两种可互换的手套共享同一套追踪器布局。MANUS Metagloves测量手指关节姿态;Wuji手套在此基础上额外记录触觉信号,覆盖手部17个区域。
这套装备紧凑、可复用,数分钟内即可完成佩戴,能支撑全天的连续采集,也不需要在环境中架设基站、粘贴标记点或做其他改造。只要设备保持佩戴,采集者的体型标定与安装标定结果就可以在不同任务间复用,后续采集无需重复标定。整套设备便于携带和复制,可以多点同时部署,数据规模能随采集人员数量扩展。

△采集装置示意与多场景采集示例
五个追踪点,如何还原全身运动?
仅凭5个追踪点恢复完整的人体运动,是一个欠约束问题,难点有两层。第一,每个追踪器的位姿同时取决于两件事:设备相对于解剖关节的安装偏差,以及身体运动链本身的姿态。不同的“安装偏差+关节姿态”组合可以解释同一组观测,直接拟合时,安装误差会被吸收进估计出的关节运动。第二,即使锚点经过了准确标定,肘、膝等中间关节仍然无法确定。此外,重建结果还需要满足物理合理性,例如足部不能穿透地面,身体各部位之间不能相互穿插。
为此,团队提出了C³(Calibrate--Complete--Constrain)管线。它的核心思路是先把固定不变的“身体-传感器几何”与随时间变化的运动分开处理,再依次补全与约束:
标定(Calibrate):采集者完成一套规定动作(站立、A/T姿势、屈肘、浅蹲、抬腿等),系统按动作阶段将其与参考动作库自动对齐,结合实测身高,拟合出体型、尺度,以及每个传感器到对应关节的变换。这份参数档案每套佩戴配置只需估计一次;
补全(Complete):利用标定结果,把追踪器位姿换算为头、腕、踝的解剖锚点。团队把AvatarPoser从“头+双手”输入扩展到全部5个锚点,并在AMASS上训练,作为时序运动先验,补全追踪器未观测到的17个关节,生成初始的全身轨迹,即“运动提案”;
约束(Constrain):对提案做三层联合精修:骨骼层保证与测量一致、时序连续;表面层基于受试者的个体体型,抑制身体各部位之间的相互穿插;地面层约束身体与地面的一致性,避免足部穿地。
最后,手套测得的手指姿态与触觉作为直接的交互证据,被融合进重建结果。
在评估子集上以追踪器拟合结果为参考,实验结果如下:
全身身体点误差为18.0 mm,最强基线(在5个锚点上重新训练的AvatarPoser)为64.1 mm,误差降低71.9%;
在追踪器未覆盖的17个关节上,误差为20.3 mm,与整体误差相当。优势延伸到了肘、膝等远离锚点的部位,说明方法恢复的是完整的全身关节运动,并不只是贴合锚点;
消融实验显示,逐层加入约束时,各层分别起效:加入骨骼层后,身体点误差由运动提案的79.0 mm降至16.1 mm;再加入表面层,每帧穿插对数由72.8降至38.7;再加入地面层,地面违规比例由61.4%降至6.0%。三层叠加后的完整方法综合指标最优。此外,若用平均体型替代标定得到的体型与尺度,误差从18.0 mm升至59.5 mm;若训练时不做安装标定,误差升至95.0 mm,仅在测试时不做,则升至98.1 mm。这些结果说明,在恢复运动之前先固定身体-传感器几何,是这套方法的关键。
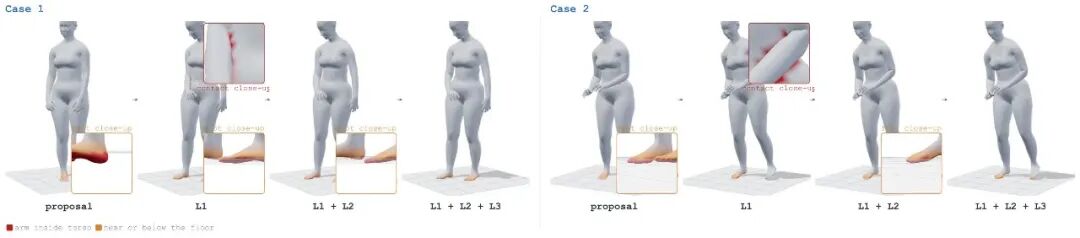
△分层优化各阶段效果对比
从实验室到客厅:管线采集了什么
团队用这套管线在5类真实环境中进行了采集验证:化学实验室、工业车间、书房、客厅与备餐区,覆盖实验室、工厂与家庭三类场所。
任务以专业活动为主,共10类任务模板。专业任务包括称量、液液萃取、反应搭建、旋转蒸发、烘箱干燥与柱层析等化学实验操作,日常任务包括折叠纸箱、整理书架、叠衣服与制作三明治。每条记录都是连续的完整任务,保留了接近目标、调整姿态、操作物体与转移位置之间的过渡。除了常规流程,采集中还保留了“恢复片段”,记录采集者在被打断或尝试失败后如何调整与继续。
管线输出的四路数据统一在30 Hz的时间网格上,包括第一视角视频、SMPL-X全身运动、手套测得的手指关节,以及每只手24×31的触觉阵列。
步骤级标注采用专家引导的流程。团队以第一视角视频、任务说明和专家提供的技能文档为条件,驱动视觉语言模型把记录切分为子任务,每个片段包含起止时间、技能标签、物体与工具角色和观察到的结果。标注流程还包含人工复核:复核人员逐段检查视频、重建动作、触觉与文本的时间对齐和语义一致性,确保文字描述与同步观测一一对应。
△十类任务第一视角示例
记录于人,执行于机器人:这些数据能训练什么?
一套采集管线的价值,最终要看采到的数据能否用于学习。在验证重建精度之外,团队还从两个方向初步探索了所采数据的训练价值:多模态世界模型,以及从人到人形机器人的动作迁移。
多模态世界模型。团队改造了Cosmos3-Edge,使其能够同时生成第一视角视频、由SMPL-X导出的动作以及触觉。实验中,各模型使用相同的视频、动作与触觉历史作为输入,比较“各模态分别建模”与“联合生成”两种设置。结果显示,联合生成在各项指标上都优于分别建模:视频PSNR由15.94 dB提升至16.62 dB,接触F1由0.610提升至0.694,动作MSE由0.059降至0.044。
团队进一步考察了不同模态作为条件时的作用。不加额外条件时,动作生成的MSE为0.0478;以预测区间内记录的视频为条件,MSE降至0.0277;再加入触觉,进一步降至0.0264。这说明视频、动作与触觉之间存在互补信息,也从侧面说明了在同一时钟下同步采集多种模态的意义。
从人到人形机器人。团队将两段记录的人体动作重定向到Unitree G1人形机器人上,再用ZeroWBC风格的全身控制器在仿真中跟踪这些参考动作。人类在实验室中边走边做的称量与反应搭建操作,由此转化为人形机器人的全身运动。这为“从人类演示到人形机器人”的动作迁移提供了一个初步示范。
需要说明的是,以上研究仍属初步探索:多模态生成基于有限的训练步数,人形机器人的动作跟踪也仅在仿真中完成,这些数据在真实人形机器人学习上的收益还有待进一步验证。
△G1人形机器人在仿真中复现称量操作
△G1人形机器人在仿真中复现反应搭建操作
怎么用上它:开源计划
重建代码已于GitHub开源;全量100小时数据已发布于Hugging Face平台(需填写谷歌表单),采用LeRobot v3.0格式,可直接接入现有的机器人学习框架。
EgoExplorer为人形机器人的全身移动操作、手-物交互与触觉感知研究,提供了一条在真实环境中规模化采集人类演示的管线,所采数据可用于动作重定向、模仿学习与世界模型训练等方向。
项目主页:https://internrobotics.github.io/egoexplorer.github.io/
论文地址:https://huggingface.co/papers/2610.18872
采集样例:https://huggingface.co/datasets/InternRobotics/EgoExplorer
代码:https://github.com/InternRobotics/EgoExplorer
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
【学术投稿】请在工作日发送邮件至:ai@qbitai.com,标题注明【投稿】,并告诉我们:你是谁,从哪来,投稿内容附上项目/主页链接,以及联系方式。

🌟 点亮星标 🌟