蚂蚁集团研发工程师刘陶峰带来报告《基于 LLVM 的 JVM JIT 编译器最新探索》,介绍新一代 JVM JIT 编译器 Jeandle。Jeandle 基于 LLVM 打造,在 C2 编译器架构复杂、社区迭代慢的背景下,用 LLVM 成熟的基础优化能力叠加 Java 相关优化,兼顾可维护性与性能。报告重点介绍两项关键优化:一是 control flow sensitive 的类型系统,可穿透复杂控制流做类型锐化,显著提升去虚拟化、类型检查消除等优化效果;二是 Partial Escape Analysis,按分支粒度分析对象逃逸,在不逃逸的分支消除内存分配与同步操作。
Jeandle 于 2025 年 8 月正式开源,当前性能约为 C2 的 80%。开源一年多已吸引 30+ 贡献者,来自华为、阿里巴巴、中科院软件所、字节跳动等机构,并完成 RISC-V 初步支持,成为中科院软件所 RuyiSDK 官方合作伙伴。未来方向包括 C++/Java 混合优化、异构 JVM、JIT Cache 与 JIT Server 等。

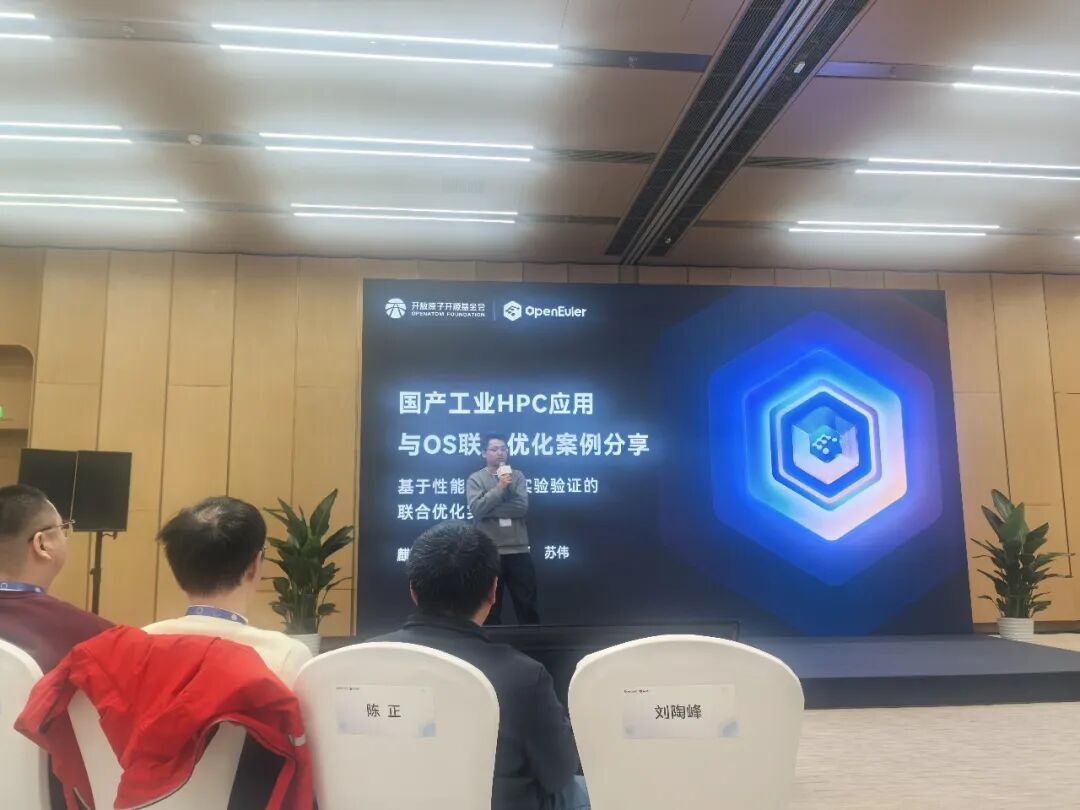
麒麟信安高级操作系统工程师苏伟带来报告《工业 HPC 应用与 OS 联合优化案例分享》,基于鲲鹏 920 与麒麟信安服务器操作系统,介绍工业 HPC 仿真应用的联合调优实践。团队通过四项经过实验验证的手段完成优化:调整 NUMA 拓扑资源配置、优化内存访存开销、增加 OpenMP 单线程快速路径消除无效唤醒、联合应用厂商做计算分区负载均衡。
整套方案在 3 个真实工程模型上平均提速 15%+,20万+步的最大模型,计算耗时从 4 小时 47 分缩短至 3 小时 51 分,优化前后仿真计算结果一致。
OpenAtom openEuler(简称“开源欧拉”或“openEuler”) Compiler SIG Committer 余宇峰带来报告《ANNC:面向搜推广告场景的AI模型推理加速实践与展望》。搜推广告模型在 CPU 上推理时,瓶颈集中在 Embedding 稀疏查找与访存,而这正是 CPU 相对 AI 加速器具备成本与低时延优势的场景。ANNC 面向 CPU 推理提供图优化、高性能算子库、指令优化与自动调优四类能力,只需注册框架接口(EP/Pass),即可在 TensorFlow 与 ONNXRuntime 上无侵入使能,优化沉淀在统一 IR 上、可跨框架复用。
落地重点有二:针对占比三至四成的 Embedding 计算,通过多算子融合与访存优化消除大量小算子带来的调度与内存开销;针对 GEMM,通过编译期数据布局转化、常量折叠与 Gemm-epilogue 链式融合,减少运行时重排与中间结果物化。整体上,ANNC 在 W&D、DeepFM、DLRM、DFFM、DSSM 等开源模型上推理性能平均提升超过 20%,客户推荐模型使能后提升 25%+。报告还展望了超节点场景下的分布式异构图切分与 Embedding 表切分,把优化对象从单设备扩展到算力、数据与互联资源的整体组织。

openEuler Compiler SIG Maintainer 谢志恒带来报告《LLVM for openEuler 版本规划及重点特性介绍》。LLVM for openEuler 是依托 openEuler 社区发布的毕昇社区版本,定位为能力开放、开发者可参与的 LLVM 下游发行版,按「LTS+副版本搭配、协同升级、版本选型」三步策略与 openEuler 版本协同演进。
回顾 2026 年版本,重点特性主要包括:结合鲲鹏 SPE+BRBE 识别访存热点、在关键路径插入预取的反馈优化数据预取;基于 CallGraph 对大编译单元拆分并行、把编译时长平均压降 50%+ 的多流并行编译;补齐鲲鹏亲和的 Rust for openEuler 工具链;面向 LLVM 缺陷自动修复的 llvm-harness;以及基于 Compiler Agent 自迭代挖掘优化机会的毕昇超级优化器——后者已在 SPEC 基准部分子项上取得约 5% 性能提升,已产出约 300 个可直接用于 LLVM 的补丁。

华为软件开发工程师郭锦鸿带来报告《流计算的原生化之路:Gluten-Flink 的架构与实践》。Flink 是业界主流的流计算引擎,其原生执行运行在 JVM 上,难以充分发挥 NEON/SVE 等向量化指令;所谓“原生化”,正是把计算密集的数据面移出 JVM、交给 C++ 向量化引擎执行。Gluten-Flink 是 Apache Gluten 面向 Flink 流侧的原生执行扩展,设计上控制面保留在 Flink,计算密集的数据面交由 C++ 向量化引擎 Velox 执行,按子图粒度翻译下推,不可下推部分回退 Flink 原生执行。在状态与容错上,checkpoint 由 Flink 编排,原生侧输出按分片组织的自描述快照,并提供 Heap 与 RocksDB 两种状态后端。
在鲲鹏 950 + openEuler 环境、Nexmark 基准 5000 万事件实测中,7 条无状态查询 CPU 消耗下降 42%–74%,合计加速约 2.6 倍;连接器改造场景吞吐提升 48.6%–91%。这一方向依托 Apache Gluten 开源社区、以 Flink 1.19 为基线持续演进,窗口算子与更多有状态算子的能力仍在补齐中。

openEuler Compiler SIG Maintainer 陈正带来报告《Triton-CPU 在鲲鹏生态下的算子编译与调优实践》。Triton 以统一编程模型与多级并行抽象,让同一套算子代码可编译到 NVIDIA、AMD GPU 乃至 AArch64 CPU 等多个后端,Triton‑CPU 正是把这套能力延伸到 CPU 平台的编译后端。openEuler Triton-CPU 基于微软主导的 Triton-Shared 中间层,将 Triton IR 降级为保留高层语义的 Linalg/memref 结构化表示——Triton 的 block 映射为 Linalg tile、显式指针与掩码还原为结构化地址和循环,再经 MLIR 落到 LLVM。相比上游直降 x86 的路径,这条结构化路线为后续在鲲鹏上做高层优化保留了空间。
具体调优围绕多个方向展开:full-tile 内存操作消除,把无条件的暂存与动态拷贝替换为整块版本化,降低访存开销;基于 SME 的矩阵乘 tiling,利用 ZA 寄存器与 FMOPA 指令按 ZA 形状精确切分 m/n/k tile,既充分利用 ZA 寄存器空间,又避免循环体内产生栈溢出;OpenMP 线程优化,让线程数不超过实际工作量,并预留 master 线程以提升 Python 与 kernel 交替执行时的缓存命中;Launcher 相关优化则通过核函数多层级缓存减少重复编译开销。依托这些优化,openEuler Triton-CPU 在鲲鹏上充分挖掘 SVE/SME 指令潜力,并给出相比 X86 平台上游 Triton-CPU 的性能对比收益。

-END-
来源|毕昇编译公众号

openEuler发布面向Agentic Infra的操作系统,全球协同共建AI生态
关注我们,了解更多
▼