在 Vibe Coding 彻底降低开发门槛的今天,大家都在经历一个奇特现象: 让一个 Coding Agent 去现有的项目里改个代码 Bug、或者补个 API 接口,前 3 轮的交互体验往往极其惊艳。它能读仓库、找文件、迅速写出第一版 Diff,甚至顺手把测试也跑了。
但只要任务的上下文稍微拉长、复杂度提升,大部分开发者就会陷入一种极其痛苦的 “调试黑洞”: Agent 在某一轮跑测试挂了,它开始失去方向,在聊天窗口里疯狂修改代码、高频道歉、连续输出 5 轮新 Diff。到了第 10 轮,你深吸一口气,发现它不仅彻底忘记了最开始的目标,甚至开始原地打转,把第 2 轮已经修好的 Bug 又改了回去。
最后,整个会话里塞满了报错和垃圾日志,环境噪声极高。面对这个开始胡言乱语、原地打转的 Agent,为了不继续浪费 Token,你不得不手动切断并新建一个会话。但这时候你面临一个更崩溃的现实 —— 你必须把过去一小时发生的事情、改了哪些文件、卡在哪个测试点,重新用自然语言给新 Agent 完整地拼凑一遍。
这也是目前 AI 编程工具在大规模真实工程中落地的最大瓶颈:现在的 Agent 将所有的工程线索和垃圾噪音都一股脑扔进 Chat Context 里,缺乏一层独立、结构化的 Engineering State 来做隔离与控制。
为了打破这个瓶颈,Valkor 联合浙江大学智能计算与软件研究中心、伦敦大学学院(UCL)软件工程团队正式推出并开源了 loom。

代码仓库:https://github.com/valkor-ai/loom
Loom 关注的是 AI 已经能够生成代码之后,如何让复杂的软件任务在真实工程流程中持续推进、可验证、可恢复地走完。
Claude Code、Codex 之后,
AI 编程还缺什么?
过去一年 Code 模型的能力演进极快。像 Claude Code 这样的 Agent 已经能深入真实仓库,执行复杂的多文件修改。
但在真实的软件工程里,“会写第一版代码” 和 “完成一次可靠的交付”,中间隔着一条巨大的鸿沟。这也是为什么 Vibe Coding 只能停留在搓 Demo 阶段,而无法染指真实的业务重构。
一个真实的需求,不仅包含代码片段,还牵扯到复杂的动态状态:前端交互行为、API 边界、数据库变更、单测覆盖率、运行时日志、CI 状态。 对工程师来说,这些状态分散在 Git、PR、CI 日志和脑海中;但对 Agent 来说,如果这些状态只存在于聊天上下文里,长任务就会不可避免地失控。
首先,上下文极易被报错噪音淹没。所有的编译报错、重试日志、临时推论全塞进 Context 窗口,导致模型在后续决策中抓错重点;更糟糕的是,会话一旦中断、或者由于 Token 触发截断压缩,Agent 就会陷入 “局部失忆” 并开始重复试错,只能对 “正在做什么” 和 “做到哪里了” 重新盲猜。
Loom 想补上的,正是软件工程给 Agent 提供的这层工程状态层。
从 “一次性 Prompt”,
到 “可随时 Resume 的状态链”
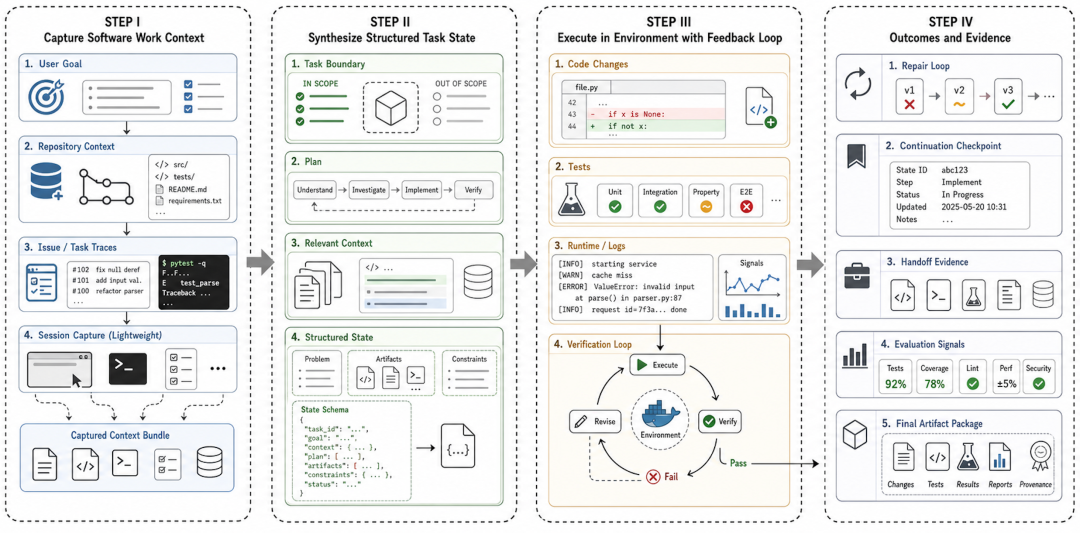
Loom 的切入点极其直白:它更像是一个给单机游戏引入 “自动存档点” 的交付马甲(Delivery Harness)。它把一次复杂的软件交付过程,拆解成了结构化、可随时恢复的状态链。

当 Agent 运行测试失败时,Loom 不会把失败当成一段简单的终端文本丢进 Chat,而是将其捕捉并结构化为一个独立于聊天记录存在的待办状态。这意味着:
Bug 不会被淹没: 失败变成了下一步行动的 “强约束”,Agent 不可能在后续对话中打个哈哈就把这个 Bug 漏掉。
多 Agent 零成本接管: 未来的开发一定是多工具、多模型协作的。开发者可能前 5 轮用 Claude 4.6 Sonnet 改逻辑,第 6 轮想换成 GPT-5.5 跑测试。新 Agent 接入 Loom 后,只要读取结构化的 “交付状态链”,就能瞬间知道自己是谁、在哪、刚才改了什么、下一步该修哪个 Bug—— 它不需要重新阅读冗长的聊天历史,直接原地 “接管比赛”。
为什么靠卷 Context Window,
治不好长任务的绝症?
很多人倾向于将长任务的失败归咎于模型的 Context Window 不够长。但这在真实的工程逻辑上是个伪命题。
在软件开发中,信息量大不等于可靠性高。把几万行的编译日志、多轮 Diff、测试输出一股脑塞进上下文,只会让会话环境充满了杂音。模型非常容易在繁杂的信息中迷失,或者把一个局部看起来能跑的代码误判为完成。
工程的本质是结构化与确定性。
Loom 的思路不是让模型看更多、记更多,而是帮模型过滤噪音,只提炼出最核心的工程线索:计划进行到哪一步了?哪些单测真的 Pass 了?哪几个文件的 Diff 已经定型,不能再乱动了? 当这些关键点成为可被编程读取的结构化数据时,衡量 AI Coding 效能的标准,也就从卷 “模型能生成多少行代码”,真正变成了卷 “长任务持续推进的完备率”。
软件工程:
大模型真正落地的确定性沙盒
软件工程可能是 Agent 最好的反馈场,这里规则绝对刚性:代码能编译就是能编译,单测挂了就是挂了。AI 编程如果想走向严肃的生产环境,就必须重回软件工程的经典常识。
现在依靠 Vibe Coding 确实让所有人都能快速搓出一个 Demo。但 Demo 和能在生产环境跑的真实软件之间,还差了一整套可信度验证。如果 Coding Agent 只管写代码,把所有的验证、对齐、纠错成本全部甩给人类工程师,效率的杠杆很快就会见顶。从这个角度来看,Loom 想探索的不仅仅是一个好用的开源工具,而是大模型真正走向严肃生产环境所缺失的状态基础设施。
大模型在静态语料库里学到了 “完美的最终代码长什么样”,却很难学到 “一个复杂的 Bug 到底是如何被一步步定位、失败、妥协并最终修复的”—— 而这些过程轨迹,才是软件工程中最核心的工程判断力。
通过这层状态层,不仅能让 Agent 的长任务推进更稳定,也在同时捕获 Agent 在真实执行环境下的动态反馈轨迹。这也为未来 Agent 的动态评测(Benchmark)和微调数据收集,提供了更真实的工程语料。
从模型生成代码,到 Agent 自主、持续、可验证地完成一个复杂的软件工程生命周期,中间这层缺失的状态基础设施,正为当下 AI Coding 技术的推进提供一个值得被重新审视的重要视角。
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com