嵌入式AI为什么这么难?从工程师的真实困惑谈RA8P1的Helium与NPU
从“模型能不能跑”到“产品能不能落地”的第一步
过去几年,AI模型越来越小,MCU性能越来越强,嵌入式AI也从概念验证逐渐走向真实产品。表面上看,把一个训练好的模型放到MCU上运行,好像只是“模型转换+工程集成”的问题。但真正做过项目的工程师都知道,嵌入式AI最难的地方,往往不在模型本身,而在模型、算力、内存、工具链和实时系统之间的协同。
很多时候,问题并不是“有没有模型”,而是模型能不能放得下、算子支不支持、推理速度能不能达到产品要求、内存布局会不会影响性能、工具链生成的代码能不能顺利集成到现有工程中。对于嵌入式工程师来说,AI部署不再只是调用一个推理接口,而是一项系统工程。
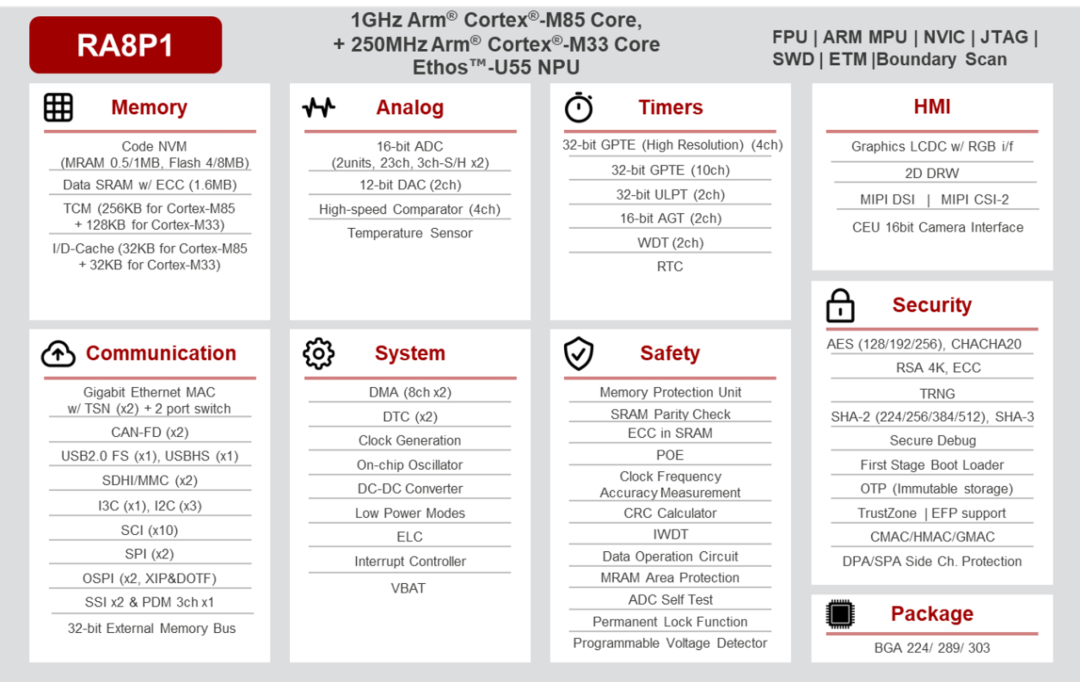
这也是本文RA8P1作为讨论平台的原因。RA8P1并不是只在MCU中加入一个NPU,而是把最高1GHz的Cortex-M85、Helium MVE向量扩展、Ethos-U55 NPU、最高250MHz的Cortex-M33辅助核、片内SRAM/MRAM以及SPI、DSI、CSI、高速USB等接口组合在一起,为视觉AI、显示交互、数据采集和实时控制提供了一个更完整的工程平台。
点击可查看大图
工程困惑 01
模型能不能跑起来?
背后的真实问题:模型格式、量化方式、算子支持和代码生成是否匹配。
工程困惑 02
算力够不够?
背后的真实问题:不仅取决于CPU主频,还取决于Helium、NPU和模型映射效率。
工程困惑 03
内存放不放得下?
背后的真实问题:权重、激活张量、输入输出缓冲区和系统任务需要共同竞争存储资源。
工程困惑 04
为什么跑起来后仍然慢?
背后的真实问题:可能是CPU Fallback、片外存储访问、Cache配置或数据搬运造成瓶颈。
传统MCU做AI的现实挑战
传统MCU擅长控制、通信和实时任务,但面对神经网络推理时,会遇到新的压力。首先是计算量。卷积、矩阵乘法、激活函数和后处理都需要大量乘加运算,如果完全依赖普通CPU执行,往往很难同时满足实时性和功耗要求。
其次是内存。模型权重需要存储空间,激活张量需要运行时缓冲区,图像输入还可能需要大块帧缓存。对于视觉类AI应用来说,内存容量、带宽和访问路径很容易成为限制性能的关键因素。很多项目不是“算不出来”,而是“数据搬不动、放不下、访问太慢”。
第三是工具链复杂度。嵌入式AI工程师不仅要关心模型精度,还要理解量化、算子支持、编译器优化、运行时接口、NPU驱动和工程集成。任何一个环节不匹配,都可能导致模型转换失败、性能不达标,或者最终工程难以维护。
RA8P1的价值:
不是单点算力,而是一套AI工程平台
理解了这些工程挑战之后,再来看RA8P1的价值,就不能只看单一指标。它的关键并不是某一个模块有多强,而是能否把CPU通用计算、Helium向量加速、NPU神经网络推理、片内外存储和高速外设接口组织成一个可落地的系统。下面先通过RA8P1的整体框图建立平台视角,再进一步说明各能力模块在嵌入式AI中的作用。
从框图可以看到,RA8P1的优势并不只是“主频更高”或“多了一个NPU”。更重要的是,它把高性能CPU、向量计算能力、专用AI加速器、多层级存储和软件工具链组合在一起,使模型部署、性能分析和后续优化可以在同一平台上逐步展开。
能力模块 01
Cortex-M85
在嵌入式AI中的作用:负责主控逻辑、通用计算、前后处理和CPU Fallback算子执行。
能力模块 02
Helium MVE
在嵌入式AI中的作用:提升向量运算、DSP、图像预处理、后处理和CMSIS-NN类计算效率。
能力模块 03
Ethos-U55 NPU
在嵌入式AI中的作用:面向神经网络主干推理,适合卷积、全连接等可映射到NPU的计算密集型算子。
能力模块 04
SRAM/MRAM/OSPI Flash/SDRAM
在嵌入式AI中的作用:支撑模型权重、激活缓冲区和输入输出数据的分层放置。
能力模块 05
RUHMI/Vela/FSP
在嵌入式AI中的作用:覆盖模型转换、NPU编译、工程集成和运行时支持。
典型RA8P1 AI应用场景:从摄像头到显示的完整链路
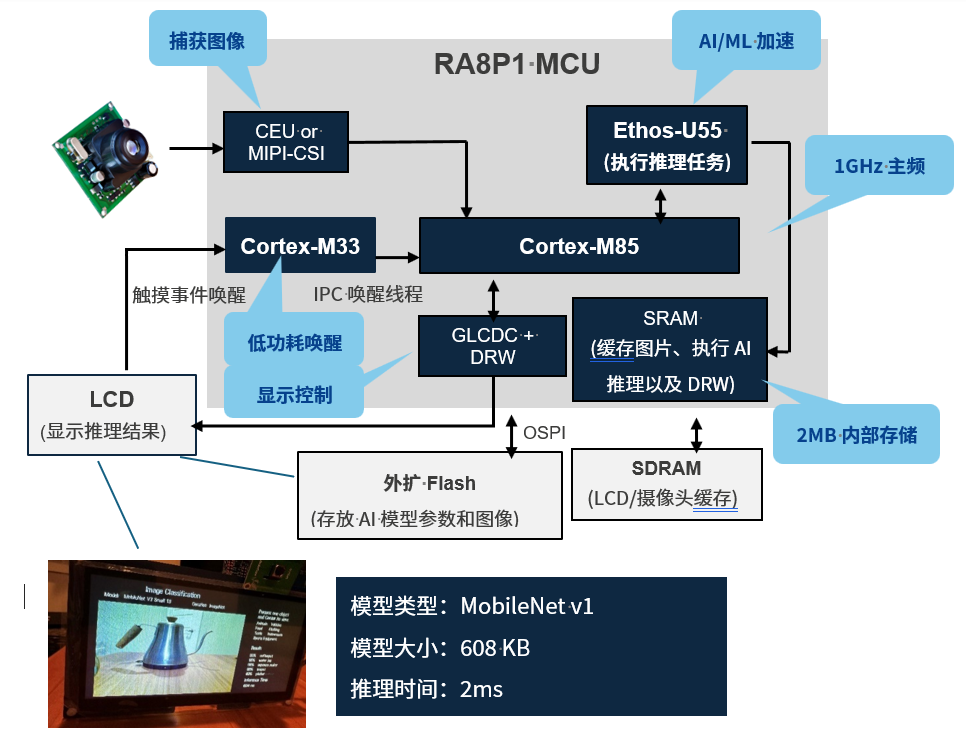
如果只看规格参数,RA8P1可能会被简单理解为“高主频MCU+NPU”。但在真实产品中,嵌入式AI通常不是单独完成一次模型推理,而是需要和传感器输入、图像预处理、模型执行、后处理、显示输出和通信接口组成一条完整链路。下面以典型视觉AI场景为例,说明RA8P1各模块如何协同工作。
点击可查看大图
图像输入:摄像头通过CSI接口输入图像数据,系统需要根据分辨率和帧率规划输入缓冲区。
前处理:Cortex-M85可配合Helium MVE完成图像缩放、裁剪、颜色空间转换、归一化等操作。
模型推理:Ethos-U55 NPU负责执行卷积、全连接等神经网络主干计算,尽量减少CPU侧负载。
后处理:Cortex-M85继续处理分类结果、检测框、阈值判断、NMS或业务逻辑。
结果输出:DSI可用于本地显示,USB或SPI可用于数据上传、外设通信或调试输出。
这种链路说明,RA8P1的价值不只是让模型推理更快,还在于把图像输入、AI计算、显示交互和外部通信放在同一个平台上统一设计。对于实际产品来说,这种系统级集成能力往往比单一算力指标更重要。
Helium与NPU不是替代关系,
而是互补关系
很多工程师第一次看到Helium和NPU时,容易把它们理解成两种互相替代的加速方式。实际上,在真实工程中,它们更像是分工不同的两类能力:NPU负责神经网络中最重的主干计算,Helium则负责CPU侧仍然需要高效执行的向量化任务。
例如,在视觉AI应用中,图像缩放、颜色空间转换、滤波、后处理、阈值判断、NMS,以及某些无法映射到NPU的算子,仍然可能在Cortex-M85上执行。这些任务如果能利用Helium MVE进行向量化优化,就可以显著降低CPU侧开销,让NPU加速的整体收益更稳定地体现出来。
能力 | 更适合处理的任务 |
Helium MVE | 图像前处理、后处理、DSP、CMSIS-NN、向量化数学运算、CPU Fallback算子。 |
Ethos-U55 NPU | 卷积、全连接等可映射到NPU的神经网络主干计算。 |
理解了RA8P1的硬件能力之后,还不能算真正完成嵌入式AI落地。因为工程师接下来仍然要回答三个更具体的问题:
如何把模型转换成工程里能用的代码?
如何确认模型真的跑在NPU上?
如何让模型在真实产品存储条件下稳定达到目标性能?
这也是本系列三篇文章要逐步展开的内容。
篇章 | 解决的问题 |
第一篇 | :解决“如何把模型跑起来”,完成模型转换、代码生成和上板验证。 |
第二篇 | Vela:解决“如何让模型更多跑在NPU上”,分析算子映射、CPU Fallback和性能报告。 |
第三篇 | 存储优化:解决“如何让性能稳定落地”,结合RUHMI Benchmark评估不同存储配置对推理延迟的影响。 |
小结:嵌入式AI不是单点优化,
而是系统协同
所以,嵌入式AI真正的挑战并不是“有没有一个模型”,也不是“有没有一个加速器”,而是如何把模型、CPU、Helium、NPU、存储资源和软件工具链组织成一个稳定、可复现、可维护的工程系统。RA8P1的价值,正是在于提供了这样一个从硬件到软件相对完整的AI落地平台。阅读本文,您将理解嵌入式AI是模型、算力、存储与工具链协同优化;掌握RUHMI模型转换及RA8P1运行,理解Vela在Ethos-U55 NPU部署作用,分析CPU Fallback;建立存储选型思路和 RUHMI Benchmark验证。
------------ END ------------



