点击下方卡片,关注“具身智能之心”公众号
机器人在执行抓取、搬运或敲击之前,能否先“想一遍”未来?然后再执行。
这就是世界模型这半年爆火的原因。
先预演,这样就有机会减少试错,并更快找到正确的行动路径。
不过,效果都说的很好,不少人还是存在质疑:模型生成的视频看起来很真,是否意味着它真的理解了任务?
我们举个例子,机器人面前放着一个杯子,我们让机械臂先抓住杯子,再向左移动。一个视频生成模型可能生成得非常清晰,机械臂和杯子也都很逼真,但如果视频里的机械臂移动方向错了,或者没有按照给定动作执行,那它实际上并没有正确理解机器人的 Action。
假设机械臂已经夹住了杯子并向上抬起,那么正常情况下,杯子应该随着夹爪一起运动。如果生成的视频里机械臂抬起来了,但杯子仍然留在桌面上;或者杯子出现了不符合重力、碰撞、接触关系的运动,即使画面再真实,也说明模型没有真正预测对动作发生之后的物理变化。
也是基于这个问题,近日,来自斯坦福大学、牛津大学、中山大学、X-Era AI的团队联合发起了ActPhysCause Challenge。
ActPhysCause Challenge主要评测具身世界模型能否根据机器人操作场景首帧和自然语言指令,生成任务执行后的未来视频。
它关注的不只是画面是否逼真,更关注模型是否预测了正确的动作、合理的物理过程,以及真正达成任务目标的结果。
本次挑战由张巨声(Stanford University)、王广润(中山大学 / X-Era AI)、王可泽(中山大学 / X-Era AI)、陈添水(X-Era AI)等具身科研与产业领域专家发起;Philip H. S. Torr 教授(牛津大学)与林倞教授(中山大学)担任指导专家,并与 LoViF 2026 @ ECCV Workshop 联合组织。
比赛官网|https://actphyscause-challenge.x-era.com/
实时榜单|https://actphyscause-challenge.x-era.com/leaderboard.html
数据集|https://huggingface.co/datasets/X-EraAI/ActPhysCause_Challenge_Track0/tree/main
代码|https://github.com/X-EraAI/ActPhysCause-Challenge
当前已经开放赛道为 Track 0 · Future Video Generation。
参赛者需为 500 个测试样本生成机器人未来操作视频,并通过 RCS-100 评分;该评分同时考察生成质量与任务忠实度,重点奖励“做得对”,而不只是“画得像”。

图 1|ActPhysCause Challenge 官网首页关键信息
01.
Track 0:一张首帧、一句指令,
预测机器人接下来会发生什么
参赛模型接收机器人操作场景的初始观测和自然语言任务指令,在生成过程中不再继续访问模拟器,目标是直接预测机器人执行任务后会出现的未来视频。

图 2|Track 0:评测指标
当前计分的 Track 0 中,模型输入一张 640×480 的机器人操作场景首帧和一条自然语言指令,输出机器人完成任务的未来操作视频。生成期间,模型不能继续访问模拟器,只能依靠图像和文本预测后续变化。
比赛不限定模型范式:通用视频生成模型、机器人世界模型,以及结合 VLM、VLA 或 Physical AI 先验的系统均可参与。模型可以在内部规划动作,但最终提交和评测的仍是未来视频。
当前 ECCV 版本奖金池暂定为 USD 2,000(具体奖金、赛程、提交规则及后续赛道开放时间,以挑战赛官网最新公告为准)。
注意:本届 ECCV Workshop 仅评测 Track 0。评测重点是未来视频质量,以及生成 rollout 与任务指令和真值轨迹的一致性。
02.
ActPhysCause 到底在评什么?
从视觉生成到具身任务理解
ActPhysCause 并不是把 Future Video Generation 当作普通的视频生成题,而是把生成视频视为机器人对动作后果的一次虚拟 rollout。评测关注的不是单一“观感”,而是模型是否同时理解指令、动作、物体、物理过程与任务结果。
动作与指令:是否选对物体、机械臂和动作顺序。
物理与时序:接触、碰撞、支撑和运动是否连续合理,是否出现漂移、瞬移或穿透。
过程与结果:关键中间状态是否可信,最终状态是否真正满足指令。

图 3|Track 0 任务与 RCS-100 评测流程:首帧 + 指令 → 世界模型生成未来视频 → 生成质量与任务忠实度两条线评分。
这几层能力实际上对应了具身世界模型从“感知未来”到“支持决策”的完整链条:先理解任务,再预测动作引起的状态变化,保持物理与时序一致,最后判断预测结果是否真正实现目标。因此,视频只是可观察的载体,真正被评测的是模型对“动作—状态变化—任务结果”关系的理解。
03.
一个很反直觉的结果:什么都不做,
像素指标反而更高。
根据主办方提供的《ActPhysCause Challenge 技术报告》,基线实验回答了两个递进的问题:现有视频指标能否判断任务是否完成,以及什么能力真正影响机器人任务理解。
1) 画面更像,不代表任务更对
Static Anchor 只是把首帧重复 121 次,机器人没有执行任何动作,却取得最高的 PSNR(15.2 dB)和 LPIPS(0.277);其 Instruction Grounding 与 Outcome Match 均为 0。相比之下,使用同任务真实操作视频的 Same-task Retrieval Anchor,PSNR 只有 11.9 dB,但 Instruction Grounding 达到 2.46/4。
反直觉之处|固定机位下,静止背景占据大部分像素。机器人真正运动起来,像素差异反而更大。因此,像素接近不能替代任务判断。

图 4|50 个任务中的 8 个首帧示例。固定头部相机视角、双臂桌面操作,不同任务主要变化在物体、容器和指定机械臂。
2) 排除指标错觉后:零样本差距指向预训练数据
再看 RCS-100 的任务得分:在统一未使用 RoboTwin 数据微调的设置下,基于 Cosmos Nano 的 PC-Phys 在 Instruction Grounding 上达到 2.60/4,高于多数普通零样本视频生成模型。统一零样本设置排除了赛题数据微调的影响,因此,差距更指向模型在预训练阶段是否见过物体交互、动作后果和具身场景。
结论由此清晰:通用视频数据让模型生成连贯画面;贴近 Physical AI 与 embodied interaction 的数据,才能帮助模型学习“动作如何改变世界”。BG-Lock 利用固定相机先验减少背景漂移和闪烁,也说明面向机器人场景的结构先验同样重要。
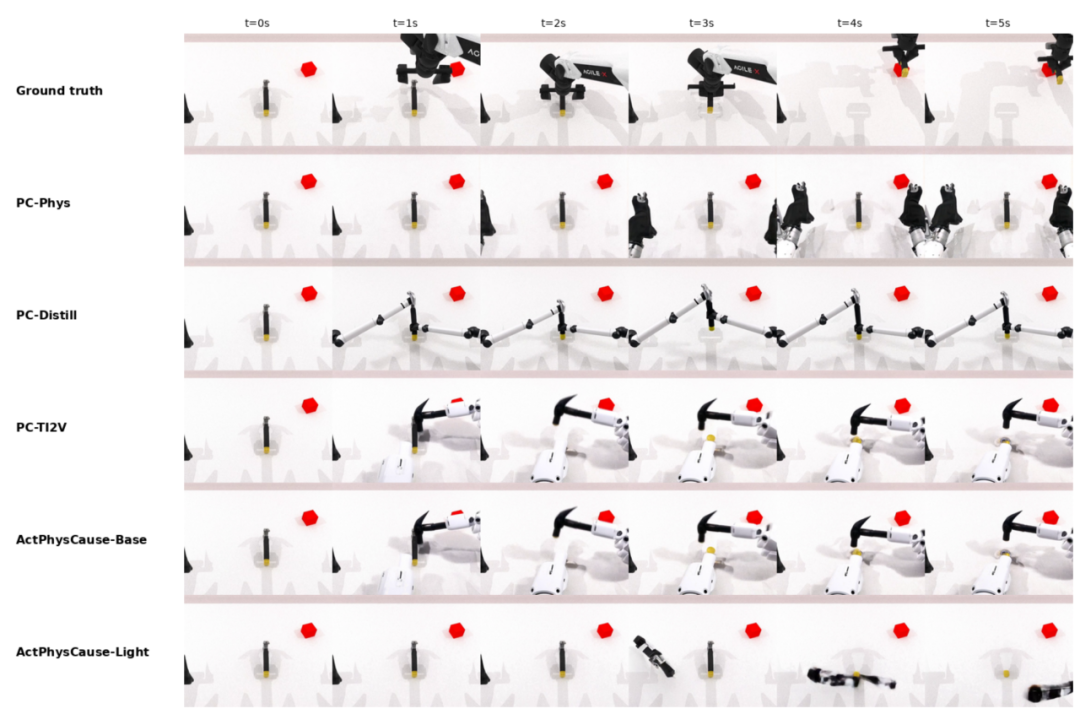
图 5|技术报告中的代表性生成结果:多种强基线能够产生动作,但仍难完整复现正确抓取与敲击过程。
数据来源:主办方提供的《ActPhysCause Challenge 技术报告》基线实验部分。
04.
从预测未来,走向因果选择
如果模型能够正确预测动作将带来什么结果,下一步就不只是生成一段更像的视频,而是用这些预测支持决策:策略提出候选动作,世界模型预演不同后果,系统比较成功概率与风险,再决定执行、拒绝或修正。
一个更接近真实机器人控制的闭环,可以这样理解:
策略或规划器提出一个或多个候选动作。
世界模型对候选动作生成未来 rollout,预测机械臂、物体与环境会如何变化。
系统根据物理合理性、动作有效性、目标一致性和失败风险比较不同未来。
选择最可能成功的动作,或在执行前拒绝、修正高风险动作。
真实机器人执行后获得新观测,再把新状态送回模型,进入下一轮预测—决策—执行。
从 Track 0 到 Track 3:从预测走向因果选择
Track 1 · Video-Action Joint Generation:联合生成未来动作与未来视频。
Track 2 · Action Correction:给定失败动作历史,修正动作并预测更合理的未来。
Track 3 · Causal Action Selection:从多个候选动作中选出最可能导致目标结果的动作。
当前 ECCV 2026 榜单只对 Track 0 计分,Track 1–3 属于后续 roadmap。它们把“生成完之后怎么办”明确落到机器人本身:从未来预测,进一步走向动作生成、失败修正和因果选择,使世界模型逐步进入机器人闭环控制。

图 6|ActPhysCause 长期路线与代表性任务示意:从 Video Quality,进一步扩展到 Action Validity、Goal Consistency 与 Causal Accuracy。当前 ECCV 版本仅 Track 0 计分;Track 1–3 为后续公开路线。
05.
如何参与ActPhysCause Challenge?
ActPhysCause Challenge的数据集、代码和实时榜单已经上线。参赛队伍需为 500 个评测样本生成未来操作视频,每支队伍每天最多提交一次。本届 Track 0 奖金池暂定为 USD 2,000:第一名 USD 1,000、第二名 USD 700、第三名 USD 300。具体赛程、奖金与提交规则以挑战赛官网最新公告为准。
此外,LoViF 2026 @ ECCV Workshop 将于 2026 年 9 月 8–9 日在瑞典马尔默举行。欢迎大家持续关注~