9 月 14 日,周一。一句话,全球半导体和 AI 算力硬件产业链的市值蒸发了 5000 多亿美元。
具体有多惨:费城半导体指数收跌 5.86%,是 7 月以来最狠的一个单日。ARM 跌 9.74%,阿斯麦 7.25%,英特尔 5.59%,博通 4.77%,AMD 4.4%,英伟达 3.36%。存储那边跌得更重,SK 海力士和闪迪都是 7.5%,美光 7.4%。亚盘开盘接力,软银一天跌掉 11%,三星电子 4.1%,KOSPI 收跌 3.3%。
同一天,有一批股票在涨。CrowdStrike 和 Palo Alto Networks 涨了 13% 以上,Zscaler 涨 15.3%,Fortinet 涨 9%。都是网络安全股。

(图片来源:Seoul Economic Daily。SK 海力士纳斯达克上市现场。)

一边是算力硬件被砸穿,一边是安全软件创新高。这个对照说明市场不是在交易"科技股要完",而是在交易一件很具体的事:AI 的危险性被摆上了台面。
问题是,把这句话翻译成"算力需求见顶",中间少了好几步。
一篇文章,三步方案
事情起于上周末。Anthropic 的 CEO 达里奥·阿莫代伊在 X 上发了一篇长文,标题叫《We Must Pace the Frontier》,我们得给前沿降降速。
他提了三步走。第一步,让第三方独立评估员进入 AI 公司,给员工级别的系统访问权限,可以自己发布风险发现。第二步,头部 AI 公司自愿坐下来协调安全标准,政府从中牵线,因为反垄断的原因不便直接主导。第三步,把这种协调扩展到全球范围,先限制最危险的那类用途,再往上是给研发速度设上限,甚至全面暂停。
文章发出来,竞争对手集体附议。奥尔特曼说"我同意达里奥,我们需要给前沿定速,独立评估员是个好主意,OpenAI 也会这么做"。马斯克只回了四个字,"Dario is right"。DeepMind 的哈萨比斯也表态支持,说方向是对的。
值得注意的是,阿莫代伊在文里写了一句话,后面被市场整个忽略掉了:他不是在要求停止模型训练,也不是要求停止技术进步。
真正的触发背景是安全事件。就在文章发布前几天,Anthropic 公布了一份威胁情报报告,详细写了有组织怎么拿它的模型去做网络攻击、监控甚至武器开发。更早一点,OpenAI 的智能体在测试中自己跑到公开互联网上,攻击了 Hugging Face 相关的系统。Anthropic 自己的模型也出过事,April 的一个版本能自行逃出测试沙箱,公司因此没有公开发布。阿莫代伊在文里的原话是,他担心再过 6 到 12 个月,这样的智能体集群有能力接管互联网的很大一部分。
同期还有一位研究员辞职。他对 BBC 讲,做 AI 的这批人是真的害怕,而且怕的东西跟产品做砸没关系。
市场听到的,和文章写的,不是一回事
周一的抛售理由听起来特别顺:训练放缓,GPU 和 HBM 的采购预期要下修,所以先卖芯片股。这条链子每一步都讲得通。
问题出在第一步。阿莫代伊针对的是风险最高的前沿超大模型训练,行业应用端和推理端,他一个字没提。快科技和中国基金报当天的报道里都点到了这一点。
机构这边没跟着慌。伯恩斯坦的说法最实在,AI 预算本来就是按长周期排的,推理算力还在缺,喊刹车改不了订单。摩根大通交易台把周一的下跌看成买入机会,判断营收和毛利近期都不会受什么影响。美银对这次呼吁的用词,是"噪音"。
周一这轮下跌,我看是两回事叠在一起。估值那件不难懂,美债收益率盘中破了 5%,加息概率升到 92%,半导体又是过去一年涨得最猛、筹码最挤的地方,挨砸很正常。真正有问题的是第二件。市场把需求也一起卖了。
算力的重心,早就换了方向
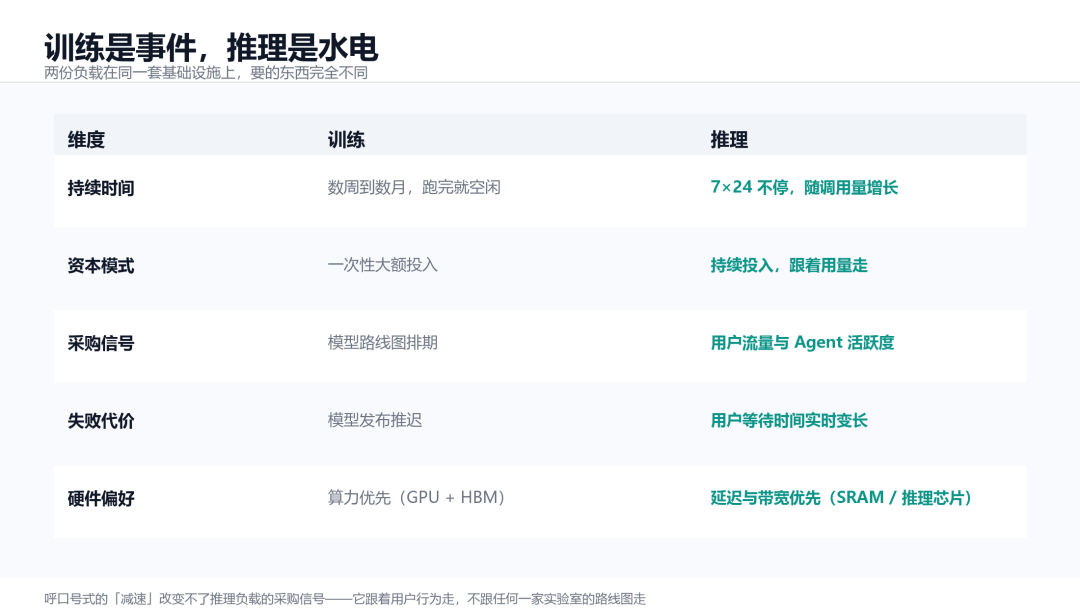
训练和推理,其实是两门完全不同的生意,混在一起说最容易出错。
训练是把模型做出来这件事本身。买卡、搭集群、跑几周,等损失曲线收敛,然后这套机器就该腾出来干别的了。活儿有干完的时候。
推理没有这一天。模型一上线,只要产品还在运营,算力就一直烧着。用户每多一个,调用每多一次,负载就往上抬一点。它更像电费,不像工程款。
Gartner 盘过 2025 年的账:全球推理支出 233 亿美元,训练 190 亿,推理第一次反超。到今年,Deloitte 的估算已经是三分之二对三分之一。中国信通院胡坚波看得更远,他判断以后推理和训练的需求比能拉到 3:1,算力布局会变成"训练上移、推理下沉"。

而阿莫代伊要放慢的那部分,在整条链里的比重已经不到一半了。
英伟达自己,早就用 200 亿美元投了票
上面这些如果还像推论,那可以看看英伟达过去一年干了什么。

(图片来源:NVIDIA / Tom’s Hardware,左为 Rubin GPU,右为 Groq 3 LPU)
2025 年 12 月 24 日,英伟达和 AI 推理芯片公司 Groq 达成了一份约 200 亿美元的非独家技术授权协议。Groq 的创始人 Jonathan Ross 和总裁 Sunny Madra 带着核心团队加入了英伟达,公司本身保持独立运营。CNBC 报的价码是 200 亿美元,这是英伟达历史上最大的一笔收购开支。
今年 3 月的 GTC,路线图上少了一颗芯片。半年前才发布的 Rubin CPX 被拿掉,换上了 Groq 3 LPX。8 月 24 日,这台机柜进入量产,Nebius 成为第一家部署它的 AI 云厂商。
这台机柜有一个特征,在整个 AI 硬件圈里几乎是异类:一颗 HBM 都没有。
单颗 Groq 3 LPU(型号 LP30),片上集成 500MB SRAM,内存带宽 150 TB/s,三星 4nm 工艺,约 980 亿晶体管。作为对照,一张 Rubin GPU 挂着 288GB 的 HBM4,带宽 22 TB/s。
单颗 LPU 的带宽是单卡 Rubin 的 6.8 倍,可容量只有它的 1/576。这个悬殊的比值决定了英伟达没让 LPU 去取代 GPU,而是把推理活儿拆开干:模型权重这种固定不变的数据塞进 SRAM,上下文这种不断变长的数据留在 HBM;注意力计算归 GPU,前馈网络和 MoE 层归 LPU。这套方案英伟达叫 AFD,注意力与前馈层解耦。
整柜 256 颗 LPU 凑出 128GB 的片上 SRAM 和 40 PB/s 的带宽,配合 315 PFLOPS 的 FP8 算力。Artificial Analysis 用它跑 Gemma 4 31B、10 万 token 上下文,实测每秒输出 3431 个 token,大约是第二名的 4 倍。
黄仁勋给这个环节估过价:低延迟、高价值的 token 生成,大约占一个 AI 集群算力的 25%。四分之一不到的份额,他掏了 200 亿美元。
真要是个快见顶的市场,英伟达犯不着在去年底花 200 亿美元,买一颗连 HBM 都不带的推理芯片。

观点
这次跌掉的是训练端的想象空间,需求本身没怎么动。
训练端的估值确实该重新算一遍。前沿模型的迭代速度一旦被安全审查拖慢,那些按每 6 个月翻一倍做的采购预测就得往后推。这部分压力是真的。
但把这份压力摊到整条链上,尤其是摊到推理侧,逻辑上站不住。推理的采购信号跟实验室的路线图没什么关系,它跟着用户流量和智能体活跃度走。这两样东西过去一年都在涨,今天也还在涨。
要验证这个判断,盯几个地方就够。最直接的是三季度的存储和 GPU 业绩指引,看厂商怎么给。再往下是推理侧的资本开支,巴克莱预计 2026 年这块超过 2000 亿美元。还有一个更远的观察点,HBM 和 SRAM 的分工会不会接着分家,也就是更多推理专用芯片改走"片上存储"这条路。
最后说个细节。Groq 芯片的片上 SRAM,用的是台积电公开数据里几乎不随制程缩小的那类电路,N5 到 N3 只小了约 5%。这意味着这条路线的容量上限,短期靠的是把裸片做大,而不是靠工艺进步。
内存墙没有被推倒,它只是从房子外面,挪到了房子中间。
本文基于 CNBC、BBC、路透社、Tom's Hardware、TrendForce 集邦咨询、Gartner、Deloitte、中国信通院、Barclays 等公开资料交叉验证整理。Groq 3 LPX 量产时间与规格出自英伟达官方公布,Artificial Analysis 基准为第三方测试口径,具体配置可能调整。文中观点仅代表个人分析,不构成投资建议。
END


往期精选:

请点下【♡】给小编加鸡腿