
随着大语言模型上下文窗口不断扩展,企业落地的大模型服务需要处理的请求越来越多元,短的日常问答可能只有几百词元,长的文档分析、检索增强生成请求动辄上万甚至几十万词元,加上请求流量在高峰和谷值差出数倍,多轮对话、系统提示词带来的大量重复前缀,给现有大模型服务系统带来了不小的挑战。为了加速长上下文请求处理,上下文并行技术被广泛应用,但现有方案大多采用静态配置,很难适配动态变化的生产负载,往往出现长请求排队、短请求浪费资源的问题。
论文标题:Adaptive Context Parallelism for Production LLM Serving
论文链接:https://arxiv.org/pdf/2609.04774
研究背景
当前生产环境中的大语言模型服务负载普遍存在三个典型特征:首先是请求长度高度异构,常规问答请求仅包含数百词元,而文档分析、复杂智能体请求的输入可能达到数万甚至数十万词元;其次是负载的时间动态性,请求到达率、长短请求的占比可能随时间发生数倍的波动;最后是前缀复用越来越普遍,共享系统提示词、多轮对话、智能体工作流都会产生大量重复前缀,前缀缓存已经成为降低冗余计算的核心手段。
为了应对长上下文请求的处理压力,上下文并行(CP)技术逐渐成为主流方案。它将请求的输入词元拆分到多个GPU上并行执行注意力计算,既可以利用多卡算力降低长请求的预填充延迟,也能缓解单卡的内存压力。不过上下文并行的收益和输入长度高度相关,短请求的计算量不足以抵消跨卡通信的开销,使用高CP度反而会升高延迟,只有长请求能从更高的CP度中获得明显收益。


现有支持上下文并行的系统大多存在三类明显不足:第一类是完全不将CP度作为核心调度维度,调度时只考虑请求特征、缓存局部性或者worker负载,忽略了CP度对性能的影响;第二类采用静态CP配置,部署时就确定每个worker的CP度,无法适配动态变化的负载,仅按请求长度路由的策略也没有考虑缓存命中和worker实时负载;第三类虽然支持动态调整CP度,但调整仅针对活跃请求或者批次,没有稳定的持久化worker集群,无法支撑前缀缓存的跨请求复用。这些问题导致现有方案很难在固定GPU预算下同时满足长请求延迟和整体吞吐量的要求。
Vertumnus系统整体设计
由北京大学和阿里巴巴集团团队联合研发的Vertumnus 系统针对这些问题给出了完整的解决方案,它将CP worker组合作为集群层面可动态调控的资源,在两个互补的时间尺度适配负载变化:在请求层面,调度器为每个 incoming 请求选择最合适的CP度worker;在集群层面,控制器根据负载变化动态调整不同CP度的worker数量。同时系统搭配全局前缀缓存管理器,跨不同CP度worker协调缓存的放置、复制和回收,在请求分配和worker配置变化时依然能保留缓存局部性。

整套机制能够在固定GPU预算下提升服务容量,同时在动态、高前缀复用的负载下满足服务等级目标(SLO)。相比现有方案,Vertumnus的核心创新点包括缓存感知的预填充时间模型、秒级集群worker重配置能力、跨CP度的全局前缀缓存管理三个部分。
请求级智能调度
在固定的worker组合下,不同CP度的worker并非可互换的资源:给请求分配CP度更高的worker可以降低预填充延迟,但也会占用更多GPU资源,减少同时服务的请求数量,因此单纯追求单请求最低延迟反而会降低整体吞吐量。加上前缀缓存和worker绑定,相同长度的请求如果在不同worker上的缓存命中情况不同,适合的CP度也会有明显差异,仅按请求长度路由的策略效果并不理想。
Vertumnus的请求调度器会综合考虑worker负载、前缀复用情况、不同CP度的执行效率,为每个请求计算所有候选worker的放置成本,选择成本最低的worker分配请求。放置成本由三部分构成:第一部分是排队延迟预估,根据worker当前未完成请求的预估服务时间计算,避免把请求分配给过载的worker;第二部分是缓存感知的预填充时间,基于自研的轻量模型计算,同时考虑CP度、已缓存前缀长度、未缓存后缀长度,预测误差控制在很小的范围内。
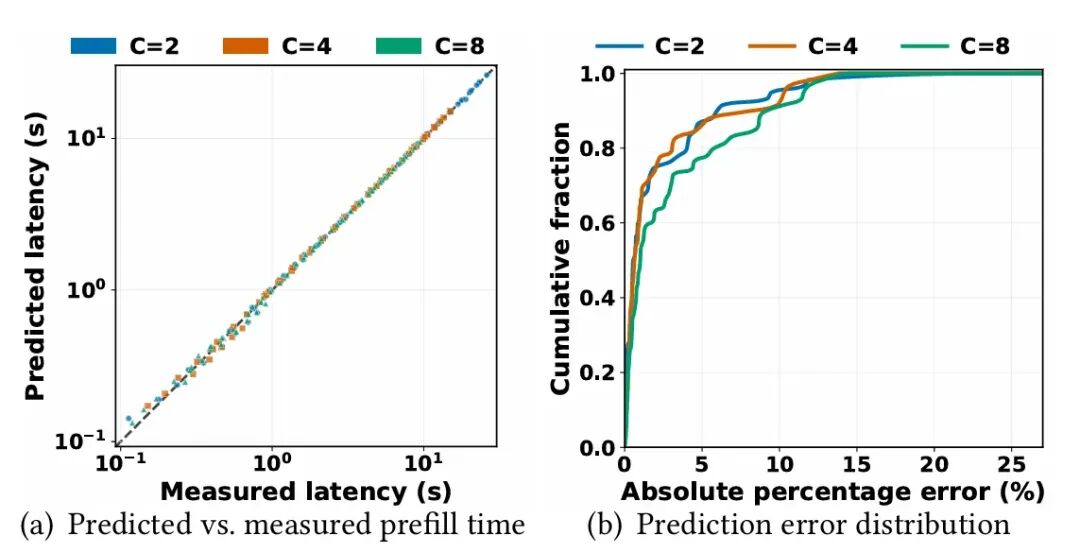
第三部分是额外GPU时间成本,计算当前CP度相比最小可用CP度多消耗的GPU时间,用来平衡单请求延迟和整体集群吞吐量,避免短请求占用高CP度worker造成资源浪费。调度器还会在分配请求后预占对应worker的预估资源,避免并发请求出现分配冲突。
集群级动态重配置
仅靠请求层面的调度无法解决worker组合和整体负载不匹配的问题:如果高峰期高CP度worker占比太高,集群能同时处理的请求数量有限,会出现严重的排队;如果低峰期低CP度worker占比太高,长请求的延迟无法达到要求。
Vertumnus支持秒级的worker拆分和合并操作,整个过程不需要重启进程,也不需要重新加载模型权重,只需要调整预创建的通信组配置即可完成。系统会周期性监控集群的负载情况和长请求占比:如果负载持续超过上限阈值,就把高CP度的worker拆分为多个低CP度的worker,提升集群的并发服务能力;如果负载持续低于下限阈值且长请求占比较高,就把多个低CP度的worker合并为高CP度的worker,提升长请求的处理速度。
拆分合并过程中,调整涉及的worker会停止接收新请求,排队中的请求会被重定向到其他可用worker,正在执行的预填充请求会正常完成后再切换配置,整个过程几乎不会影响服务可用性。实测显示,一次拆分或者合并操作仅需要1.1到5.1秒,其中配置切换本身耗时不到1秒,其余时间为等待存量请求执行完成的 drain 阶段。
全局前缀缓存管理
现有系统的前缀缓存大多和worker绑定,不同CP度的worker之间无法复用缓存,worker拆分合并后缓存也容易失效,导致大量重复计算。Vertumnus引入了全局前缀缓存管理器,用全局前缀字典树统一管理所有worker的缓存元数据,记录每个前缀在不同CP度worker上的副本数量、访问频次、未命中损失。
系统会周期性扫描字典树,动态调整缓存副本:如果某个前缀在某个CP度下的累计未命中损失超过阈值,就跨CP度复制缓存副本,让该CP度的请求也能命中缓存;如果同一CP度下某个前缀的平均单副本访问频次超过阈值,就增加同CP度的副本数量,均衡负载避免单个worker过载;如果副本的平均访问频次低于回收阈值,就回收对应副本释放缓存空间。为了避免频繁的复制和回收,系统设置了合理的阈值间隔,同时给访问数据添加衰减因子,让近期访问的权重更高。
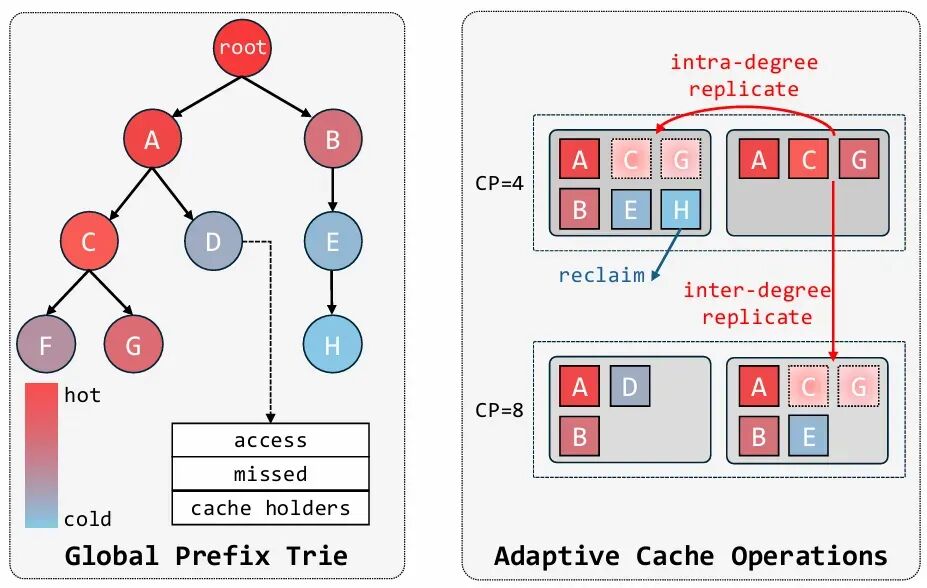
这种机制既提升了前缀缓存的复用率,也让调度器有更多选择,不用为了命中缓存把请求分配给过载的worker,进一步降低了整体请求延迟。
实验效果验证
研发团队在64张NVIDIA H20-3e GPU组成的集群上完成了测试,其中40张GPU分配给预填充池,24张分配给独立的解码池,测试覆盖DeepSeek-V4-Flash-FP8和Qwen3-30B-A3B两个主流模型,负载包括公开长上下文评测集L-Eval、智能体负载Tool-Agent以及真实生产环境采样的请求trace,对比了vLLM、SGLang、静态CP配置等主流基线方案。
整体测试结果显示,Vertumnus在所有负载下都取得了最低或者接近最低的平均和P90 TTFT,以及最高的SLO达标率,优势在高负载下尤其明显。对于Qwen3-30B-A3B模型,在最高测试负载下,Vertumnus相比最强基线,在L-Eval、Tool-Agent、生产三个负载上的平均TTFT分别降低13.9%、21.0%、28.1%,P90 TTFT分别降低17.8%、55.0%、29.5%,词元加权的SLO达标率分别提升0.9、13.3、1.1个百分点。
在动态负载测试中,面对交替出现的短请求高峰和长请求高峰,Vertumnus可以快速调整worker组合,始终比固定配置的基线取得更低的平均TTFT,短请求高峰时最多降低19.6%的平均TTFT,长请求高峰时最多降低14.5%的平均TTFT。缓存消融实验也验证了全局缓存管理的作用:在Tool-Agent负载下,相比只有本地缓存的版本,开启全局缓存管理的Vertumnus在高负载下平均TTFT降低10.3%,P90 TTFT降低18.7%。
总结
Vertumnus针对生产环境大语言模型服务的异构动态负载特点,首次实现了集群层面的自适应上下文并行管理,搭配缓存感知的请求调度和全局前缀缓存管理,在不增加GPU资源的前提下,有效降低了长请求的首包时间,提升了整体服务的SLO达标率,对于企业落地大模型服务、降本增效有很高的实用价值。
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群