它很神秘,代号叫 Ox Alpha。Ox 在英文里是公牛的意思,于是大家给它起了个名字叫“牛来”大模型。
大家纷纷猜测它背后到底是谁,有人说是小米,有人说是谷歌,甚至连苹果都被怀疑过。有开发者做黑盒指纹实验发现,Ox Alpha 与智谱的模型呈现出高度一致的关系。

终于在 8 月 26 日晚,智谱公布了答案:Ox Alpha 就是旗下最新的 GLM-5.3 Flash 模型,已经正式上线并开源。总参数 320 亿,是 GLM-5 系列第一个原生多模态模型,编程表现与 Claude Opus 4.8 持平。

因为全新的低成本架构,GLM-5.3-Flash 全面超越参数量高出一倍的 GLM-5.2,定价却只有它的十分之一。
那话不多说,我们四轮实测看看它的表现。
实测环节

每轮都开启新对话,模型选择 GLM-3.5 Flash,思考级别最高。
Part 1 · 3D 打印机
第一轮做一台网页里的 3D 打印机,上传一张图片,把它变成一个 3D 模型,支持 360 度旋转查看。用时 1 小时 30 分钟,免费账号额度消耗如图。

整体效果还是可以的,上传一个极果 logo 试试。哇塞,有点东西啊,就是转到背面感觉没有上色。

换个钢琴,空间关系识别不太准确。我上传的是一个完整的蛋糕,谁给我咬了一口。

最后试试茶壶,这个效果不错,还能导出 OBJ 文件。

导入 Blender 里面也能正常打开,大家可以看看效果如何。
Part 2 · 3D 街机赛车
第二轮来个硬核的,做一款 3D 浏览器街机赛车,要求两张完整地图,三辆不同设计的赛车,能漂移能加速。

好家伙,用了 3 个多小时还没跑完,这个 Flash 一点也不 Flash 啊。终于在频繁的测试后自己崩溃了,我这里接管催它尽快交付。
最后用时 3 小时 46 分钟,使用 GLM Coding Plan Lite 套餐,5 小时额度消耗 90%,周额度消耗 18%。
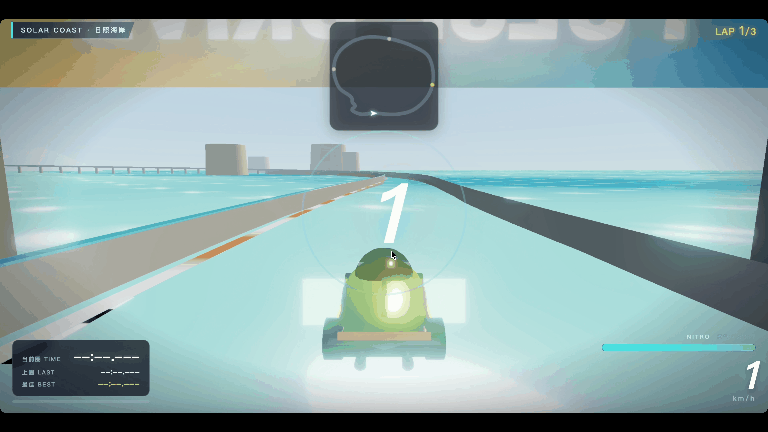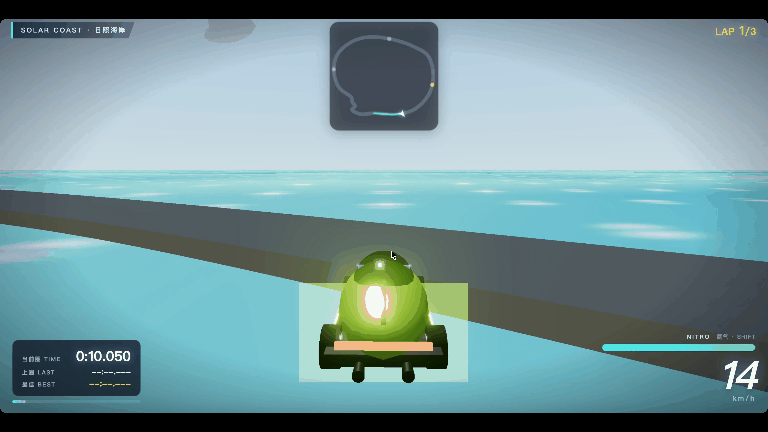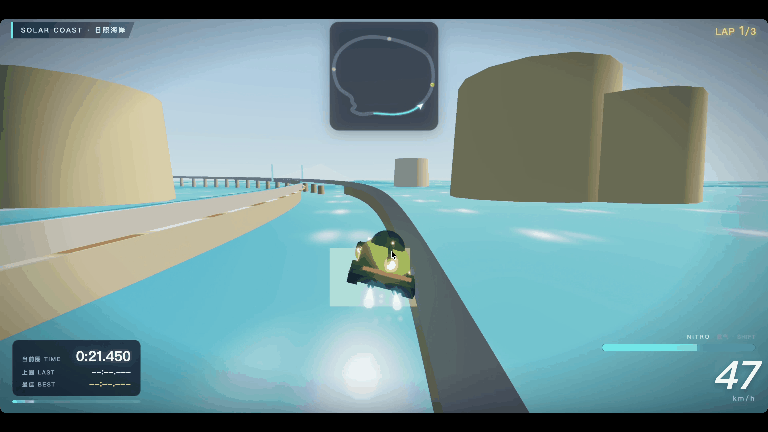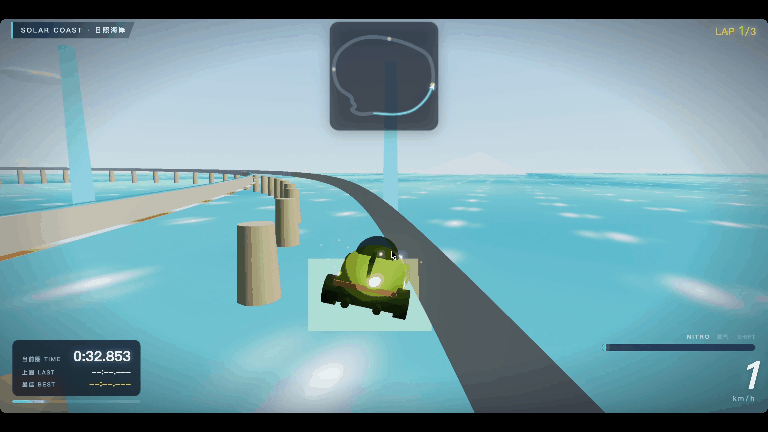
等了这么久,看看成品。方向键是反的。最大的问题是,一旦撞到赛道两边的护栏,车就动不了了。最后勉强跑完了一整圈,等了快四个小时,做成这样还是有点失望。
这里我也用了 DeepSeek 拥有视觉能力的新模型 DeepSeek V4.1 Flash 测了一下,只能说半斤八两。方向键终于能正常操作了,但是没有边界限制,可以满图随便跑。
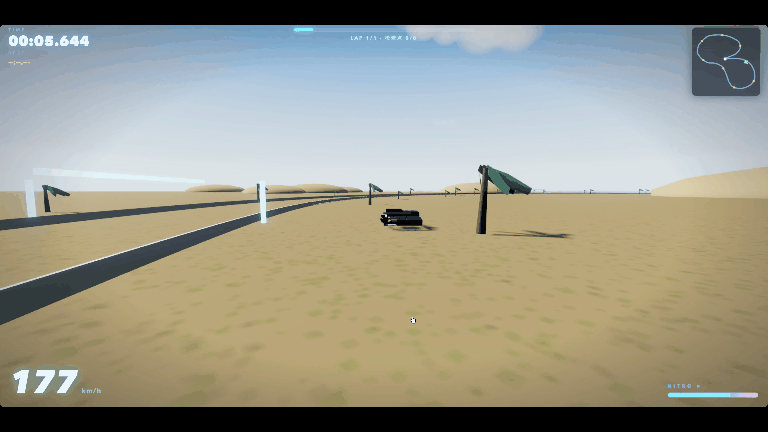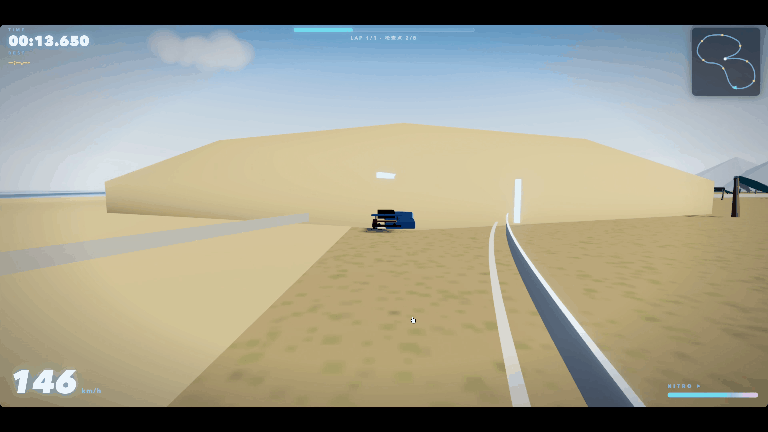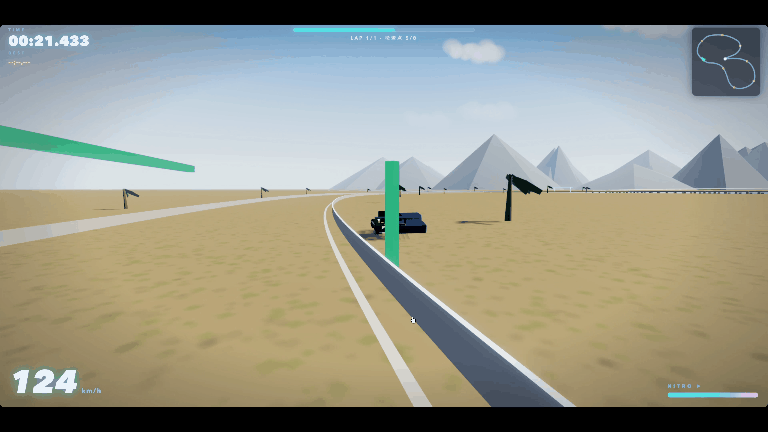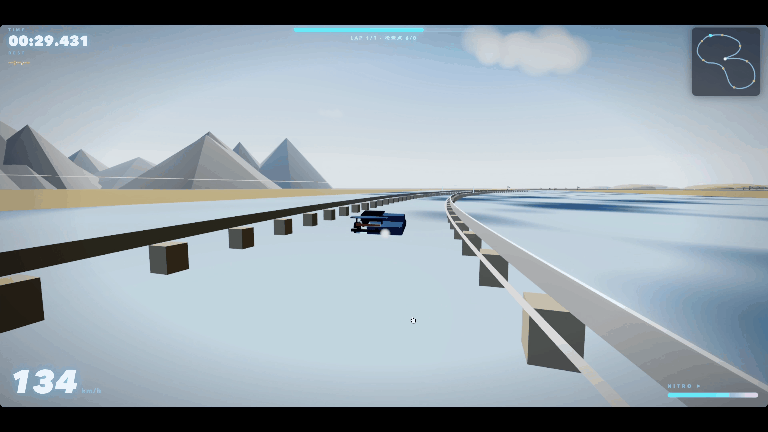
这轮两家的表现都差强人意。
Part 3 · 复刻操作系统
接下来是经典测试题,用一个 HTML 文件复刻整个 macOS 桌面系统,另外还得在里面做一个能玩的射击游戏。用了 1 小时 21 分钟,5 小时额度消耗 18%,周额度消耗 5%。
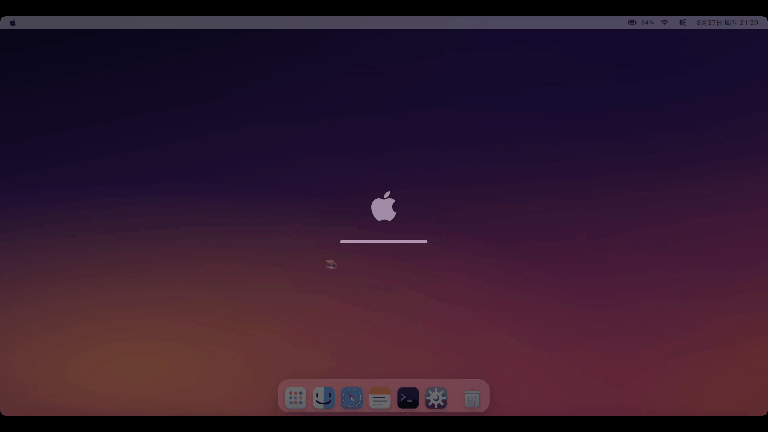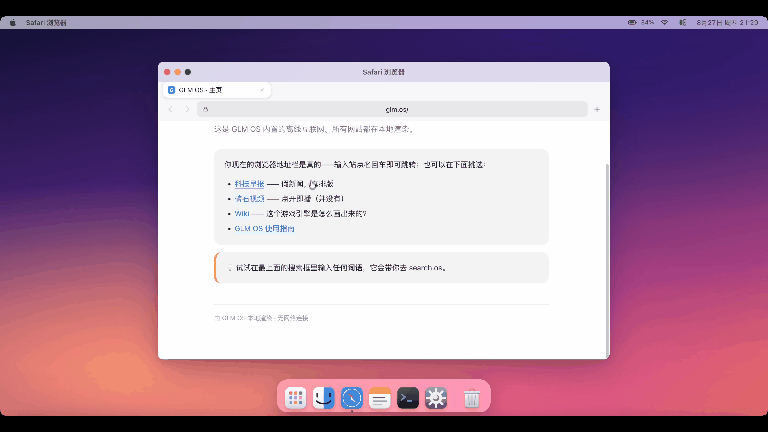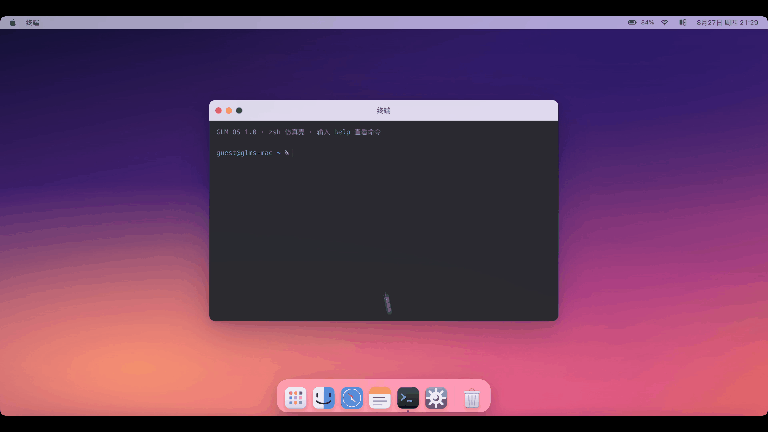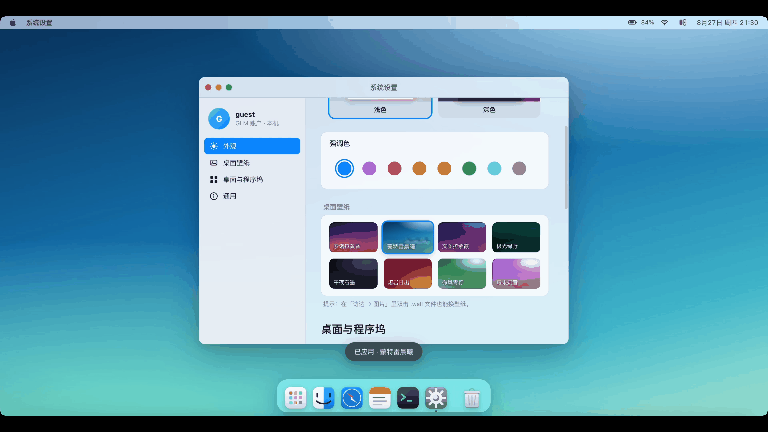
图标绘制得很精致,访达、备忘录、终端、设置都正常可用,壁纸也能换。

最后看看射击游戏,也没任何问题,走路的时候还有轻微抖动,有不同强度的敌人,整体没有出现任何 bug。
同样用 DeepSeek 也测了一下,效果比起 V4 Flash 还是有进步的,但是文字框排版有些拥挤。功能都正常,还多做了一个计算器 App,射击游戏也正常能玩。

这轮两家的完成度都不错,智谱的细节更好一些。
Part 4 · 自由网站设计
最后一轮,直接让模型自由发挥,做一个能展示网页设计能力上限的作品,主题自选。用时 1 小时 11 分钟,5 小时额度消耗 22%,周额度消耗 5%。

网站的名字叫做“最远的回声”,一进来就能听到音效。动画都很流畅,也有一些交互的内容。

旅行者 1 号是人类目前发射过最远的探测器,到现在还在工作。我喜欢这段文字的过渡动画,引用的是美国天文学家卡尔·萨根书中的一段话。

科学家估算,2026 年 11 月 18 日,旅行者 1 号将飞行到距离地球约 259 亿公里,也就是光走一整天的距离。我们在地球上发出一个无线电指令,它要 24 小时才能收到。
整体来看,GLM-5.3 Flash 的审美和前端设计能力还是蛮不错的。
成本对比
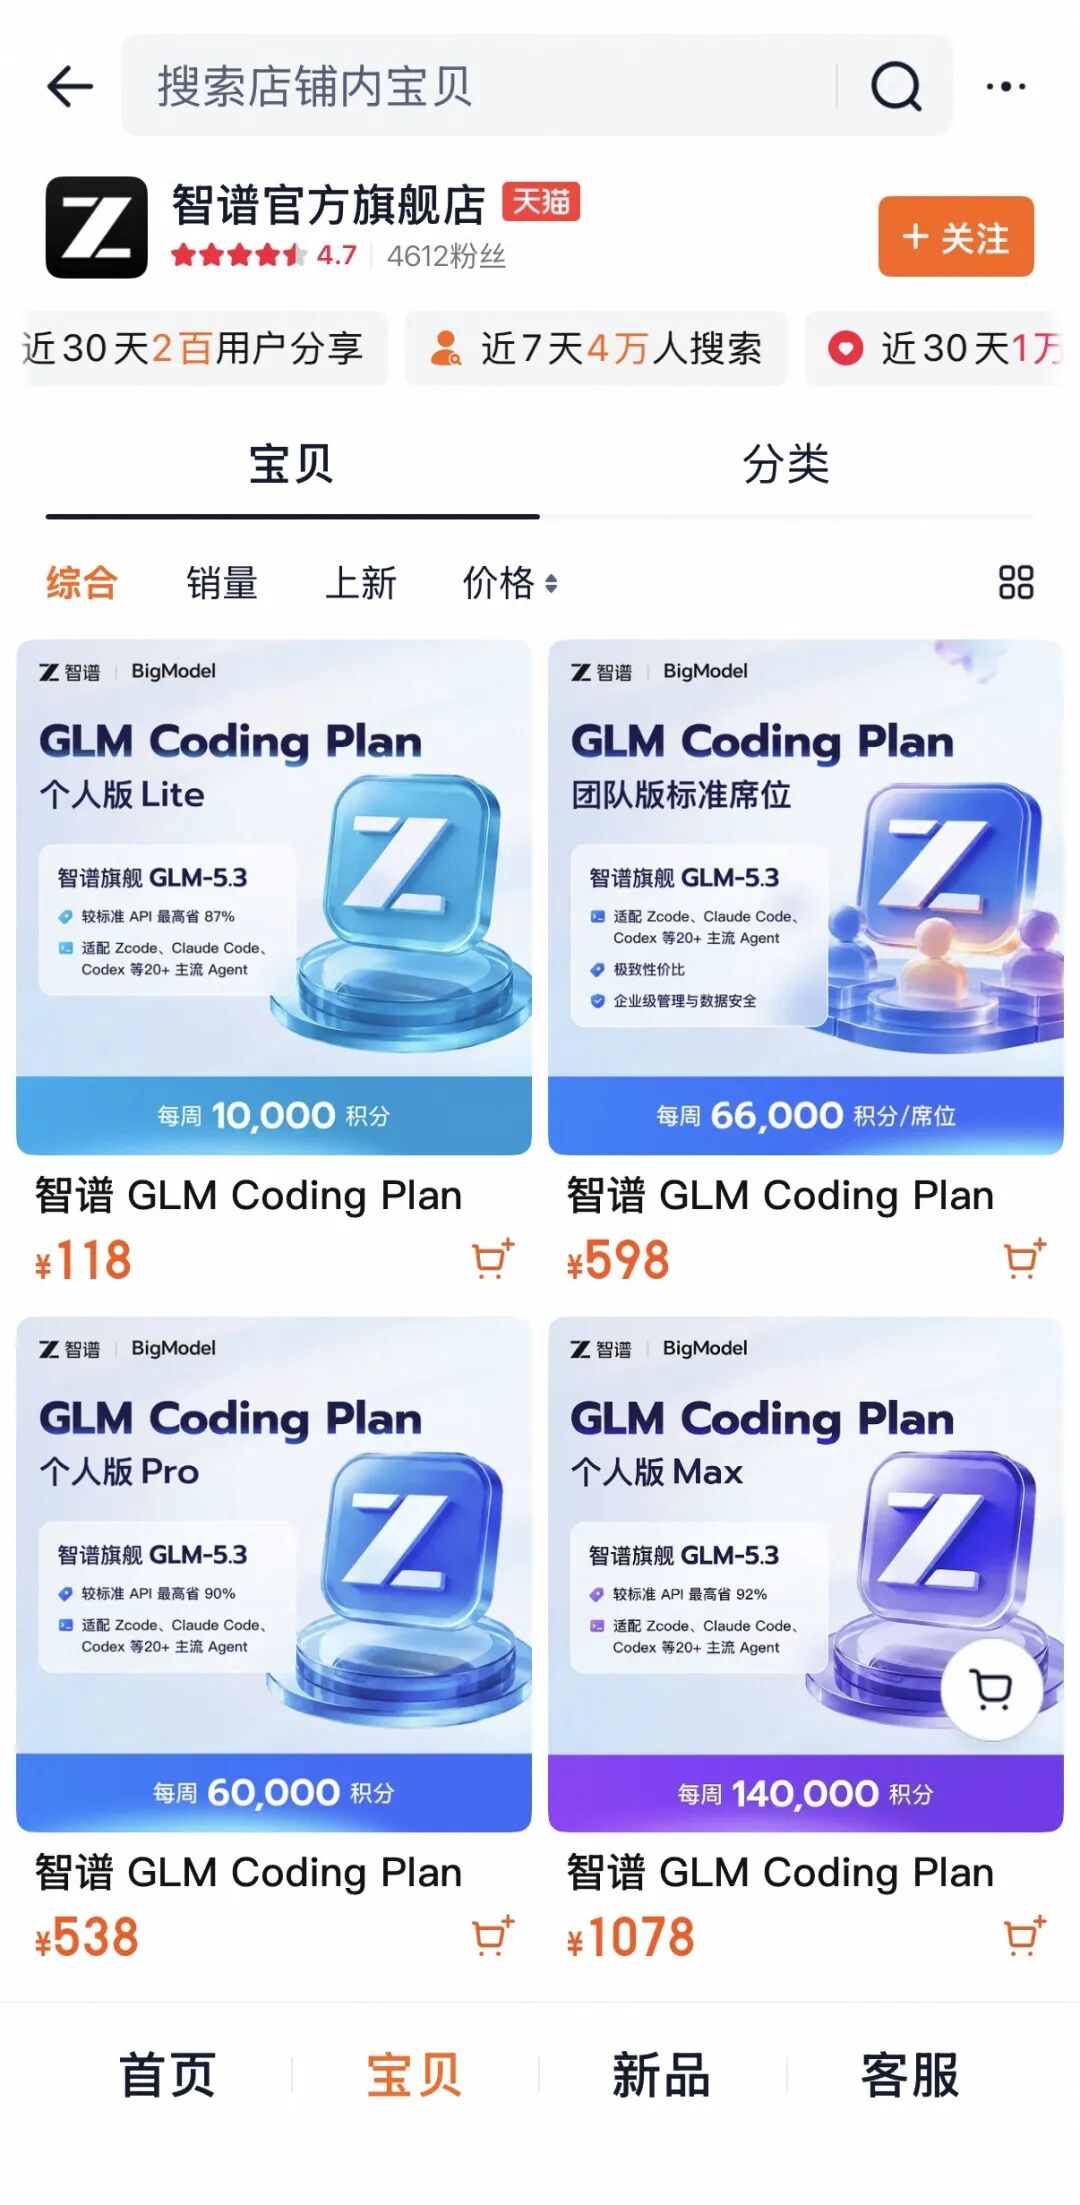
智谱的订阅计划现在已经在天猫旗舰店上出售了,不知道双十一会不会有优惠呢。

先来看 GLM Coding Plan 的个人套餐,套餐采用积分配额,同时有每 5 小时和每周的用量限制,三档都支持 GLM-5.3 和 GLM-5.3 Flash。非高峰时段包括周末全天,积分消耗只算标准的一半。

就在刚刚,智谱还发布了 GLM-5.3-FlashX,保持相近的智能水平,推理速度最高 200 tokens/s,比 Flash 快了 5 倍。那这个“牛来 X”模型,是不是可以简称“牛 X 模型”~
API 价格如下图所示

总结
最后做个总结,四轮实测下来,“牛来大模型”用着还可以,性价比也不错。但最大的问题就是速度和稳定性。

智谱官方称,面对匿名测试期和正式上线后的大规模调用,GLM-5.3 Flash 的推理服务全部由国产 AI 芯片集群承载。经过推理引擎和调度优化,硬件效率和单 Token 成本已经做到和主流英伟达 GPU 相当的水平。
国产芯片完全可以在大规模场景下,高效、经济地支撑前沿模型的推理需求。当算力不再成为限制国产模型开发者的一道坎,希望这一天早点到来。