因为公众号平台更改了推送规则。记得点右下角的大拇指“赞”和红心“推荐”。这样每次新文章推送,就会第一时间出现在订阅号列表里。

本文聚焦系统层面,探讨CXL在内存层次结构中的定位。
引言
HBM通过堆叠DRAM来提升带宽,而HBF则将NAND封装进HBM的结构中,以增加容量。
但当我们谈论数据中心内存时,有一个名字总是在GPU旁边频繁出现,那就是CXL。
无论讨论“构建内存池”、“虚拟机间共享内存”,还是“AI服务器的热/温/冷数据分层管理”,CXL都是一个不可或缺的关键词。
然而,当你真正去搜索CXL时,就连它的缩写都令人困惑:有CXL.io、CXL.cache和CXL.mem;有Type 1/2/3设备;版本号从1.1一路演进到2.0、3.0、3.1和3.2。这是一项入门门槛相当高的接口技术。
因此,本文我想从一个问题开始:
“我们已经有了DDR和PCIe,为什么还需要另一个全新的接口?”
回答这个问题,自然就能揭示CXL在内存层次结构中的定位,以及为何三大主要内存厂商(三星、SK海力士、美光)会同时加速扩展其CXL产品线。
为何还需要另一种接口——DDR与PCIe之间的空缺
简短回答:DDR无法扩展,而PCIe又难以用作内存。
在单台服务器中,CPU传输数据主要通过两条路径:
DDR通道:一种专用于内存的总线,直接连接到CPU旁的DRAM模块;
PCIe:一种通用串行总线,用于连接GPU、网卡和SSD等外设。
每条路径都有其明确且擅长的角色,但两者都已触及瓶颈。
DDR的局限:通道数量即上限
若要增加更多DDR内存,CPU必须增加内存通道数量。然而,增加通道意味着CPU封装上的引脚数增多,布线也随之变得更加复杂。
即便是最新一代的服务器CPU,其通道数也最多只有8到16个,每个通道上可连接的内存模块数量通常仅限于1到2个。
因此,单个CPU插槽的DRAM容量被限制在几TB以内。超过这一范围,物理上就无法再添加更多内存。
随着LLM推理节点所需处理的数据量(如KV缓存、模型权重、嵌入向量)迅速增长至数十TB,这种容量瓶颈正变得越来越常见。
PCIe的局限:速度快,却无一致性支持
那么,如果我们通过PCIe连接内存会怎样呢?在16通道链路上,PCIe Gen5每方向可提供约64 GB/s的带宽(双向总和为128 GB/s),这与单个DDR5通道的带宽(约50 GB/s)相当。
从内存扩展的角度来看,带宽本身其实并不匮乏。真正的障碍在于其他方面。
通过PCIe连接内存时存在两个问题。
首先,缺乏缓存一致性。缓存一致性是指,即使多个访问者(如CPU核心或设备)各自缓存了同一内存地址,当其中一个进行修改时,其他访问者也能看到最新的值。DDR内存位于CPU的一致性域内,因此CPU的缓存层次结构和内存控制器会自动维护这种一致性;而PCIe则处于该域之外。若要让CPU直接读写PCIe设备的内存,就必须在缓存行粒度上保证一致性。但PCIe本质上是一种基于数据包的I/O协议,无法提供此类保障。要像使用主内存一样使用PCIe内存,操作系统必须显式地将数据复制过去(例如通过memcpy)。
其次,内存语义较为粗粒度。PCIe以大于64字节缓存行的事务单元进行操作,无法实现内存所需的细粒度访问。
虽然可以通过PCIe连接内存,但从CPU的角度来看,这块内存是“别人的内存”,而不是“我的内存”。
一种缓存一致的内存接口
如果将上述所有内容归纳为一句话,那就是:
我们需要一种像DDR那样具备缓存一致性的内存接口,同时又能像PCIe一样扩展到系统之外。

填补这一空白的标准化方案正是CXL。
CXL并非从零开始构建的物理层,而是一个直接沿用PCIe物理层(PHY)并在此基础上叠加全新缓存一致协议的标准。
CXL的核心理念是:在现成的PCIe 5.0基础设施之上,增加一个缓存一致性协议,从而实现高速互连。
CXL的三种形态——CXL.io / CXL.cache / CXL.mem

CXL 并非单一协议,而是由三个子协议组成的集合。这三个子协议同时通过一条PCIe 链路传输。

这些名字容易混淆,因此让我逐一解释每个子协议的作用。
CXL.io — 与PCIe相同的底层基础
CXL.io在功能上与PCIe完全一致,它负责设备发现(枚举)、读取配置空间(配置)、传递中断以及通过DMA传输大量数据。
每个CXL设备都必须实现CXL.io。这正是CXL被设计为建立在PCIe之上的标准协议的原因——以便现有的PCIe基础设施(如操作系统驱动、BIOS、控制器IP)可以原样复用。
CXL.cache — 设备缓存CPU内存
设想一种情况:像GPU或加速器这样的设备频繁地从CPU的主内存中读取数据。
使用PCIe时,每次都需要从主内存中获取数据。但如果在设备内部加入一个小型缓存,并将常用的数据存储其中呢?只要能保证CPU和设备看到的是同一份数据,就可以显著减少通信开销。
CXL.cache正是实现了这一点。它允许设备以缓存行(64字节)为粒度缓存主机内存,并保持该缓存与CPU缓存的一致性。
在内部实现上,这是将CPU的缓存一致性协议(例如MESI)扩展到CXL链路的一种方式。设备对缓存行所处的状态(修改/独占/共享/无效)以及当其他缓存代理已持有该缓存行时的处理方式,均已被标准化。
CXL.mem — CPU 将设备内存当作主内存处理
还存在相反情况,即设备连接了大量内存(如DRAM 或更多),而CPU 想要像对待自身主内存一样加载和存储这些内存。
CXL.mem 就承担这一角色。从CPU 的角度来看,设备内存表现为其物理地址空间中的一个区域,可通过普通的加载/存储指令直接访问。
关键在于,CPU 扮演了“主机”角色。在Type 3 类型中,设备仅存储内存,此时主机自行管理一致性即可。
相比之下,在Type 2 类型中,设备同时拥有自己的缓存,此时会应用基于偏置的一致性机制——明确标记某条缓存行的“所有者”是设备还是主机。由于控制该行的是哪一方负责一致性,双向一致性流量便可大幅减少。
听起来复杂,但实际实现对设备端的负担相当轻。对于Type 3,设备只需像内存控制器一样响应读写请求即可。
三种协议的结合
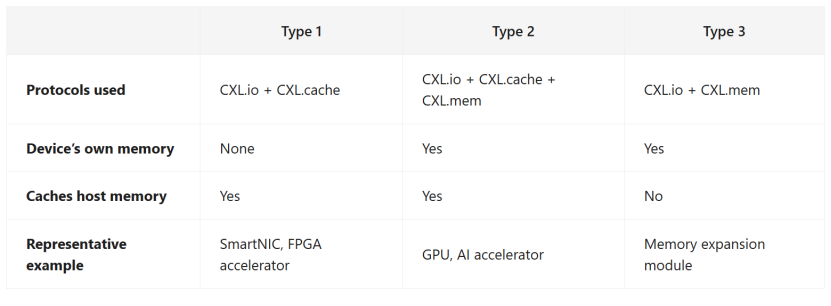
CXL设备会根据其功能选择并实现三种协议之一。
无自身内存、仅缓存主机内存的设备:CXL.io + CXL.cache
具有内存且只需主机将其作为自身内存使用的设备:CXL.io + CXL.mem
具有内存并同时需要缓存主机内存的设备:CXL.io + CXL.cache + CXL.mem
这三种组合构成了下一节中讨论的Type 1 / Type 2 / Type 3设备的基础。
Type 1/2/3设备
下面来详细说明每种类型的职责和使用场景。
Type 1——仅缓存的加速器
Type 1设备本身没有独立内存,而是缓存主机内存。
典型的代表是智能网络接口卡(SmartNIC)。在处理从网络传入的数据包时,它会频繁地读取主机的描述符队列和数据包缓冲区。通过将这些数据保留在网卡内部缓存中,并保持一致性,可以大幅降低数据包处理的延迟,而无需每次都要往返访问主机内存。
对于频繁引用主机数据结构的工作负载(例如FPGA加速器),Type 1能发挥其优势。
Type 2——兼具内存与缓存的加速器
Type 2设备拥有自己的内存,并同时缓存主机内存。它使用三种协议。
典型例子是通过CXL连接的GPU或AI加速器。该加速器拥有独立的HBM/GDDR,但也会从主机内存中读取并缓存模型权重或输入数据。它通过CXL.cache从主机获取数据,并通过CXL.mem将加速器的内存暴露给主机。
需要注意的是,Type 2是实现起来最复杂的类型。由于需要双向管理一致性,设备端控制器的负担非常大。因此,目前实际大规模生产的Type 2设备并不多。
Type 3 — 最常见的内存扩展模块
Type 3设备仅拥有自己的内存,不缓存主机内存,只需实现CXL.io和CXL.mem即可。
简单来说,它就是“一个带有CXL接口的内存模块”。从主机的角度来看,它看起来就像一个距离稍远一些的DDR模块,可通过普通的load/store操作访问。
目前处于大规模生产或即将商用阶段的大多数CXL产品都是Type 3。原因显而易见:
它实现起来的复杂度最低,
最直接地缓解了DDR通道的瓶颈,
并且能自然融入现有内存厂商的产品线中。
我们稍后将介绍的三大内存厂商推出的CXL内存模块(CMM)系列,也都属于Type 3。
原文链接:
https://hyper-accel.github.io/en/posts/what-is-cxl/
高端微信群介绍 | |
创业投资群 | AI、IOT、芯片创始人、投资人、分析师、券商 |
闪存群 | 覆盖5000多位全球华人闪存、存储芯片精英 |
云计算群 | 全闪存、软件定义存储SDS、超融合等公有云和私有云讨论 |
AI芯片群 | 讨论AI芯片和GPU、FPGA、CPU异构计算 |
5G群 | 物联网、5G芯片讨论 |
第三代半导体群 | 氮化镓、碳化硅等化合物半导体讨论 |
存储芯片群 | DRAM、NAND、3D XPoint等各类存储介质和主控讨论 |
汽车电子群 | MCU、电源、传感器等汽车电子讨论 |
光电器件群 | 光通信、激光器、ToF、AR、VCSEL等光电器件讨论 |
渠道群 | 存储和芯片产品报价、行情、渠道、供应链 |

< 长按识别二维码添加好友 >
加入上述群聊

带你走进万物存储、万物智能、
万物互联信息革命新时代