9月22日,星凡智能(XFEON)举办“芯启航,智万物-2026新品发布会”,正式发布覆盖芯片、数据、算力与算法的物理AI产品矩阵,进一步明确“物理AGI底层能力构建者”定位。

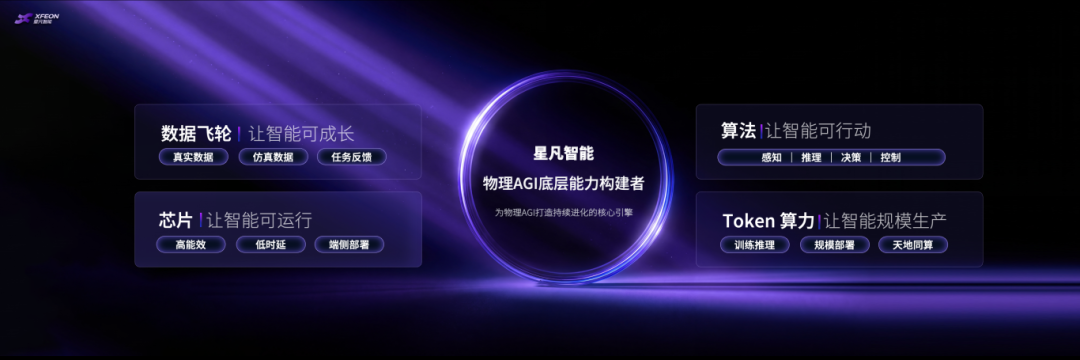
本次发布的产品矩阵覆盖四类底层能力:
● 芯片侧,以端侧物理AI芯片星核S1为核心,形成面向具身智能的星核R系列、面向太空计算的星核K系列和面向边缘智能的星核E系列;
● 数据侧,推出由XGAIA DataFlow全流程数据处理平台、XGAIA Operator多Agent自主执行平台、GEgo数采设备、GHG触觉手套与DexCore仿真一体机构成的物理AI数据飞轮产品体系;
● 算力侧,推出面向大模型训练、推理和规模化部署的星辉D/N系列Token工作站;
● 算法侧,发布AGLobe星凡具身大脑并推出XBoost加速平台端侧版。
这并不是一次单颗芯片或单一模型的集中亮相,星凡智能试图回答的是一个更具系统性的问题:如何让智能在真实世界中行动,并在持续反馈中不断成长?
AI的输出
正在从Token走向Action
过去几年,大模型推动AI在文本、图像和代码领域快速发展,智能的主要输出是一个个Token。随着具身智能、无人系统和太空计算加速发展,AI开始走出屏幕,进入连续、动态且充满长尾任务的物理世界。
星凡智能合伙人、副总裁高君效在发布会开场时表示:“AI的下一次跃迁,不只是生成更好的答案,而是能够真正进入物理世界,完成任务、创造价值。AI的输出正在从Token走向Action。”
然而,真实世界把AI的难度提高了一个维度。
机器人不会等待云端返回答案,时延可能直接影响动作安全;电池容量限制了算力与运行时间;视觉、语音、环境和运动数据需要同时处理;网络中断不能让系统停止运行;面对不断变化的环境,智能体还要具备持续学习能力。
因此,物理AI需要解决的已经不只是模型规模或峰值算力问题,而是如何在有限功耗、存储和成本条件下,完成实时感知、推理、决策与控制,并让智能在一次次真实任务中持续成长。
这也让AI产业的竞争从单点能力转向系统级较量。

物理AI端侧芯片承载智能在机器人及各类物理终端中运行,并在真实任务执行过程中持续产生数据;数据回流云端,由Token算力工厂完成治理与模型训练;算法与具身大脑进一步将模型能力转化为感知、推理、决策与控制能力,让智能真正形成可执行的Action;新的能力再部署回端侧芯片,在下一轮运行与执行中产生新的数据。
由此形成一条完整的物理AGI持续进化闭环,围绕这条闭环,星凡智能作为物理AGI底层能力构建者,按照芯片、数据、算法与算力四个部分,正式发布面向物理AI的产品矩阵。
芯片|让智能可运行
让每一瓦功耗、每一GB 存储都转化为更有效的端侧智能
模型规模持续增长,与端侧芯片算力供给之间正在形成巨大鸿沟。云端可以通过扩大集群获得更多算力,端侧却无法无限增加功耗、存储和散热资源。因此,物理AI需要的不是简单堆叠算力,而是在有限资源中获得更高的“有效智能密度”。
此次发布的星核S1,是星凡智能物理AI端侧计算产品的底层算力核心。该芯片采用定制多核架构和自研AI算法加速内核,硬件原生支持INT2至INT8混合精度计算,单芯粒INT8等效算力为105 TOPS,典型功耗约25W,能效比超过4 TOPS/W,并支持多路视频编解码。

星核S1的设计重点并非单纯提高峰值TOPS,而是将量化算法、推理引擎与芯片数据通路协同设计,使模型压缩、计算加速和存储优化能够直接转化为实际运行效率。在指定模型、配置和测试条件下,围绕S1构建的软硬协同方案可实现推理吞吐量提升50%、模型显存占用减少85%、持续学习显存占用降低90%。
围绕机器人本体、AI卫星与边缘设备的不同需求,星凡智能进一步形成星核芯片方案。
星核R系列:面向机器人本体智能的高性能算力产品
当前机器人仍面临多模态感知不协同、决策响应滞后、云端依赖高和本体适配难等问题,具身智能还“不够智能”。真正智能,需要拥有更强的端侧算力。

星核R系列面向多本体、多传感器和多任务复杂度,提供多模态融合、本地大模型推理、任务决策与实时控制所需的本地算力,最高整形算力280TOPS,等效算力达420TOPS,支撑复杂多模态任务和大模型本地运行。目前,星核R系列已进入机器人客户适配和量产导入前验证阶段,进入多家头部具身智能企业供应链。
星核K系列:面向卫星在轨智能的高可靠算力产品
未来的卫星不只是数据采集节点,更应成为能够实时感知、分析和决策的在轨智能节点。但通用海外芯片难以同时满足星载低功耗、高可靠、抗辐射和自主可控等要求。
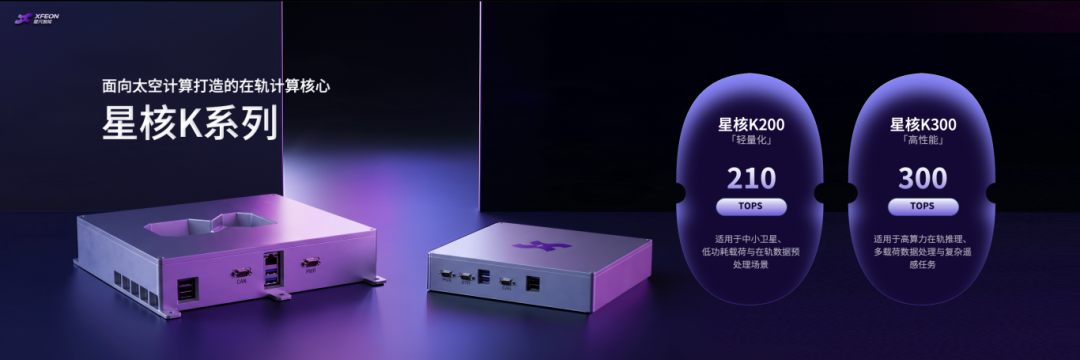
星核K系列作为星凡智能面向太空计算打造的在轨计算核心,基于国产化算力架构与自主可控设计体系,支持遥感分析、目标识别、数据筛选与压缩,可达300 TOPS等效算力,能效比达2.5 TOPS/W,在有限星载能源下支撑高性能AI计算。目前,星凡智能已深度参与“星算计划”等项目,助力构建天地一体化算力网络,推动星核K系列从产品验证走向规模化应用。
星核E系列:面向边缘智能的高效能算力产品
星核E系列面向工业设备、智能终端和边缘节点,以低功耗、本地化计算支撑边缘侧模型推理与实时响应,提供可快速集成的端侧AI推理能力。凭借极致的能效,星核E系列已在政务、工业和高校等边缘智能场景深度应用。

从机器人本体到卫星在轨,再到各类边缘设备,星核系列解决的是同一个问题:让模型不再依赖遥远的云端,而是在物理现场实时完成计算与决策。
发布会上,西安交通大学人工智能学院执行院长、星凡智能芯片首席科学家/联合创始人孙宏滨教授还介绍了双方围绕下一代端侧智能芯片取得的阶段性研究成果。
围绕低比特量化、细粒度跳算和片上训练,双方已形成三项协同创新成果:
成果1:性能保持的低比特模型轻量化技术:在4-bit权重、6-bit激活值量化条件下,相关方法可使72B模型准确率较已有先进量化方法最高提升5%以上,同时实现最高4.5倍推理加速;
成果2:高性能低功耗的大模型推理架构:细粒度跳算技术在平均精度损失低于1%的情况下,实现71.74%的平均计算跳过率,配套架构实现3.14倍加速和1.82倍能效提升;
成果3:高能效低开销的模型片上训练架构:片上训练方法使浮点运算量降低40%、外部存储访问量降低39%,稀疏度提升63.6%。
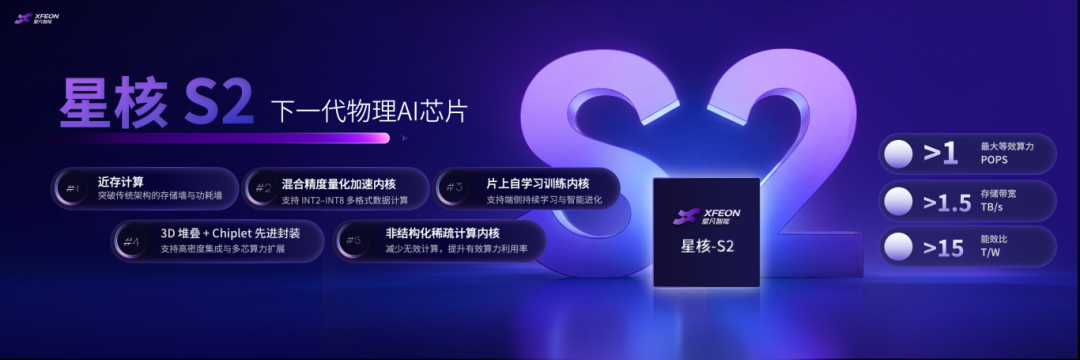
这些已经取得的研究成果将支撑下一代星核S2的技术演进。按照发布会公布的规划,S2已在研发中,并将引入近存计算、3D堆叠、Chiplet先进封装、非结构化稀疏计算和片上自学习训练内核。
从当前的高效端侧推理,到下一阶段的端侧持续学习,星核芯片正在推动物理AI从“能够在端侧运行”走向“能够在端侧成长”。
数据飞轮|让智能可成长
让真实世界成为机器人智能的燃料
见过真实世界的多样性,才能更好地应对未知场景。
基于这一判断,星凡智能旗下聚焦物理AI数据基础设施的企业星凡盖亚(XGAIA),构建起覆盖数据采集、治理、训练供给与场景反馈的具身智能数据体系。星凡智能具身智能事业部总经理、星凡盖亚CEO叶晶也谈到:“真实世界没有标准答案,模型决定起点,真实世界数据决定智能的上限。”
机器人进入真实环境后,面对的物体、光照、空间、动作方式和异常情况几乎无法被穷举。但现实中的大量原始数据并不能直接用于训练。只有经过时序对齐、清洗、标注、质量检测和结构化治理,数据才能转化为模型可以学习、可以复用的经验。
因此,具身智能真正稀缺的,不只是更多数据,而是更多可训练、可复用、可持续进化的“高质量数据”。
围绕这一问题,星凡智能构建了由星凡盖亚具身智能创新中心、XGAIA DataFlow、XGAIA Operator、GEgo数采设备和GHG触觉手套组成的数据产品体系,贯通多源数据接入、仿真数据生成、数据治理、任务执行和反馈回流。

独创的DELTA具身智能数据处理架构,是整个物理AI数据飞轮的核心。给真实世界数据建立统一的“语法”和进化秩序,将具身智能数据升级为“自动化工业流水线”,让一次任务经验能够跨场景、跨任务、跨本体复用。
XGAIA DataFlow作为面向具身智能的数据处理与训练闭环平台,依托自研DELTA数据处理架构,覆盖多源数据接入、时序对齐、清洗、标注、质量检测、跨本体映射和数据增强,仅需7步,将机器人产生的多模态原始数据转化为可训练的数据资产,让原始数据直达模型训练。将高价值数据占比提升至60%—80%,精选数据集训练性能可达全量数据95%以上,并降低30%—50%的训练计算成本。
XGAIA Operator则面向真实场景中的多Agent自主执行,将自然语言任务进一步转化为任务理解、环境感知、动作规划和设备控制。它能够根据任务目标拆解工作流程,协调不同机器人、传感器、执行器及软件Agent之间的协同关系,并结合实时环境变化动态调整执行策略。机器人在完成实际工作的同时,持续沉淀交互数据、执行结果与异常反馈,让任务本身成为数据生产过程。
面向多源操作数据获取,同步推出GEgo数采设备与GHG触觉手套。GEgo采用头戴式双目RGB与高频IMU硬同步设计,可同步记录视频、姿态与时间戳;GHG融合高精度运动捕捉、双向力反馈与多模态触觉渲染。
DexCore仿真一体机作为面向具身智能训练与验证的软硬一体仿真平台,提供高保真、可复用、高并发的仿真训练环境,相比人工搭建仿真环境,DexCore支持任务与场景快速切换,减少重复搭建成本。单台设备可支持64个以上虚拟机器人并行训练,任务执行效率提升最高300倍,训练时间可缩短至传统方式的约10%,让机器人训练从“数月试错”走向“小时级出师”。

近日,星凡智能旗下星凡盖亚具身智能创新中心已在马鞍山正式启动。项目规划用地约1万平方米,聚焦具身智能数据中心、研发测试中心和产业智造基地建设,推动星凡智能在长三角的具身智能产业布局落地。
按照2‑3年发展规划,星凡智能计划在全国布局约10家具身智能创新中心。依托规模化创新中心建设,计划三年内形成3000万小时/年的数据产能。
让每一次任务,都成为下一次智能进化的燃料。
Token算力|让智能规模生产
将海量数据转化为可训练、可部署的模型能力
数据需要被训练为模型,模型需要持续推理和迭代,这背后离不开稳定、可规模化的Token算力供给。
但客户真正关心的已经不只是卡数和FLOPS,而是模型能否部署、单位成本能够产出多少Token、业务需要多长时间才能上线。算力的价值,正在从“拥有多少算力”,转向“能够高效产出多少Token”。
围绕大模型训练、推理和规模化部署,星凡智能发布星辉D/N系列Token工作站。D系列面向国产化部署、政企私有化和行业大模型应用,N系列面向高性能训练、高并发推理及Token算力工厂。
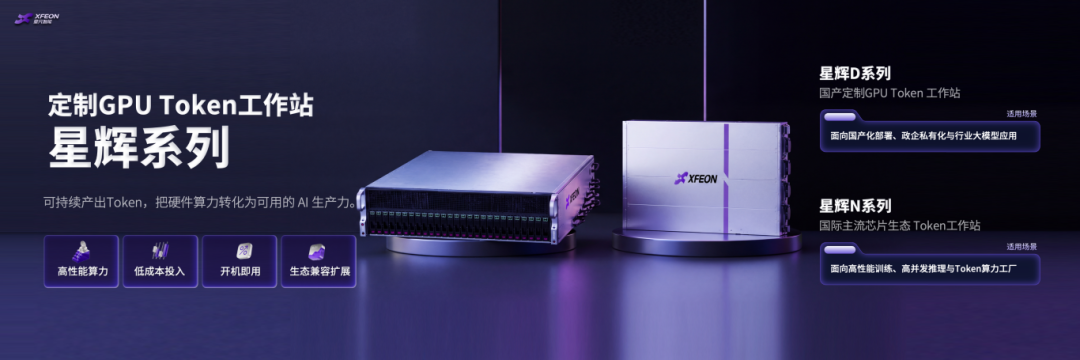
两条产品线融合多芯片生态、自研量化算法和XBoost加速能力,支持BF16至INT2多格式混合精度量化,模型体积最高可缩减85%。一台8卡星辉系列Token工作站可以承载671B参数大模型,无需建设大型计算集群即可开机运行,软硬一体化交付实现最快7天上线。
目前,星凡智能累计交付等效算力已超过数千P,星辉系列已在重庆南部、皖东、粤东及桂东等项目中实现规模化部署。
算法/具身大脑|让智能可行动
一次示教,举一反三,探索VLA与世界模型之外的“概念”新路径
数据为智能提供经验,算法则决定这些经验能否转化为理解任务、解决问题和适应新环境的能力。
星凡智能认为,通用智能要减少对数据的需求,同时提升每条示教数据的复用价值。除了积累更多经验,智能体还需要从示教数据中提取可以迁移、组合和复用的任务概念,从而减少相似任务的重复采集与重复训练。
当前具身智能主要沿着VLA和世界模型等路线发展:VLA连接视觉、语言与动作,帮助机器人理解指令并生成行为;世界模型通过预测环境状态及其变化,帮助机器人判断行动结果。星凡智能则进一步探索除VLA与世界模型之外的“第三条路”——让机器人从经验中学习概念,再利用概念的迁移和组合实现举一反三。
围绕这一方向,星凡智能正式发布行业首款基于综合知识论、以概念学习为核心的具身大脑——AGLobe,由星凡智能首席算法科学家、董事/合伙人谭铭玺主导研发。尝试从少量甚至一条示教数据中,从时间、空间、量变和因果等范畴抽象出可迁移可组合的概念,让一条数据的价值从“复现一次动作”延伸为“学会一类任务”。这也是AGLobe所强调的“一次示教,举一反三”。


进入概念迁移阶段后,任务对象、初始位置和目标容器发生变化,机器人仍可调用已经形成的概念,将新的物体移动到新的目标位置,无需重新采集一套完整任务数据。
在概念组合阶段,任务进一步扩展为连续操作,例如先将一个对象放入指定容器,再将另一个对象移动至不同位置。机器人通过组合“将物体X从位置A移动到位置B”等已有概念,完成未示教的复杂任务。

为了将能力部署到不同物理终端,星凡智能在既有XBoost异构加速平台的基础上,进一步推出XBoost加速平台端侧版,覆盖模型压缩、混合精度量化、算子优化、推理引擎和硬件适配,并兼容PyTorch、ONNX、vLLM等主流框架及开源模型生态。在指定模型与硬件环境下,XBoost可实现2至8倍综合性能提升,部分场景推理吞吐量最高提升10倍;模型体积可由约720GB压缩至约200GB,硬件适配周期可由数周缩短至小时级。
物理AGI持续进化闭环
每一次Action,都是下一次智能进化的起点
星凡智能发布的,是一套能够让智能在真实世界中持续运行、持续反馈、持续成长的底层能力体系:端侧运行产生数据,数据推动模型进化,模型形成行动能力,新的能力再回到端侧完成下一次任务。每一次Action,既是本轮智能能力的输出,也是下一轮智能进化的起点。
物理AI的竞争将不再局限于单颗芯片的峰值算力或单个模型的参数规模,而取决于数据生产、模型迭代、端侧部署和任务执行能否高效协同。贯通芯片、数据、算法与算力,星凡智能希望让AI不止思考,更能行动——让每一次Action,都成为下一次智能进化的起点。

推荐



