过去数十年,算力增长主要依靠制程微缩;当单颗芯片逼近面积、带宽与功耗的边界,产业先以 2.5D 集成把多个芯粒在水平方向展开,再进一步引入垂直 方向3D 堆叠,让计算、缓存和存储在第三个维度上重新组合。但从“平铺”走向“堆叠”,并不意味着性能会自然增长:哪些模块值得叠、数据应该放在哪里,散热、良率与成本又如何平衡?《集成芯片与芯粒技术白皮书(第二版)》试图为这些问题建立共同的技术坐标,第四届集成芯片和芯粒大会也将成为产学研集中讨论这场架构变革的学术盛宴。大会早鸟注册已延期至 9 月 25 日;在此之前,不妨先从 Hot Chips 2026 的AMD/Intel 和华为海思韬定律的几颗新芯片出发,看看算力为何正在从“做得更小”走向“向上生长”。
01 3.5D 集成:垂直和水平的交融
先厘清 3.5D 集成的含义。芯片在同一平面铺开、通过硅中介层互连,我们称为 2.5D 集成;芯片纵向堆叠、通过 TSV 或混合键合互连,我们称为 3D 集成;3.5D 集成则把二者结合起来,在横向扩展的同时引入局部纵向堆叠。当单颗芯片面积逼近光刻掩模版极限(约 858mm²),仅靠平面扩张已经越来越难。面向下一代高端服务器 GPU,国际巨头如何继续推高算力上限,以及国产芯片如何借助先进封装绕开单一制程约束、突破技术垄断,正成为两条值得关注的主线。其共同变化是:互连和封装不再只是“后道实现”,而开始成为“架构设计变量”。

3.5D 集成的基本形态:2.5D 集成的水平铺开与 3D 集成的垂直堆叠相结合,形成“横向扩展 + 纵向堆叠”的混合集成体系。
AMD 与 Intel 不约而同地采用 3.5D 集成,试图突破 GPU 以 2.5D 为主的传统集成方式。AMD MI455X 延续了 MI300 系列的 3.5D 路线,也可视为目前最早获得云端服务器验证的方案之一:IO Die 承担有源硅中介层(active interposer)的功能,下方还有一层无源硅中介层,计算芯粒则集成在有源层之上,并通过混合键合与缓存形成垂直近邻。这一代最显眼的升级,是部分计算晶粒由 3nm 转向 2nm,在保留原有封装框架的同时提升总体性能。AMD 的策略因此可以概括为“小步快走”:不推倒整套系统,而是逐代替换部分晶粒,用有限改动组合出新的产品配置。
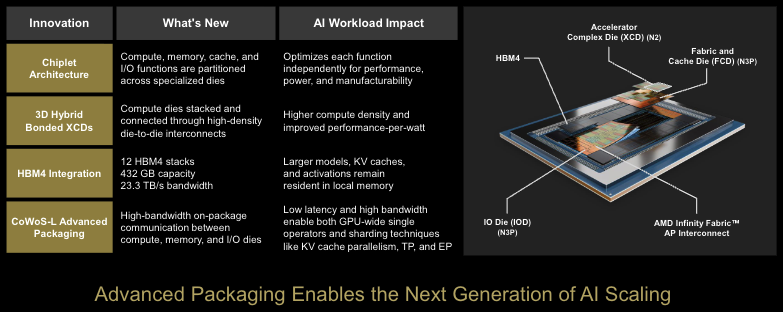
AMD MI455X:XCD 通过 SoIC 垂直堆叠于 FCD 之上,HBM4 与 IOD 在中介层上水平展开
Intel 则选择了更激进的重构。Clearwater Forest 在某种程度上仍接近 MI300/400 系列的组织方式,而 Diamond Rapids 基本舍弃旧路径:16 个 Core Chiplet(18A-P,最多 256 核)堆叠在 4 个 Base Tile 上,1.28GB LLC 位于计算模块正下方;两个中央 Fabric Hub 集中承载内存控制器、I/O,并针对 Scale-up 数据流进行优化。可以把它理解为把传统单个 IO Die 或中介层的功能拆开,让“计算芯粒只管算,Fabric Hub 专门管数据”。这套结构能否成功仍待验证。Fabric Hub 采用外部工艺,也引出一种值得讨论、但尚需更多证据支持的解释:Intel 可能希望借助更成熟的模拟与 I/O IP,把计算工艺与接口工艺解耦。若如此,Diamond Rapids 的创新就不只是芯粒怎么摆,更是如何利用跨工艺组合弥补单一工艺的能力边界。

Intel Diamond Rapids:16 个 18A-P Core Chiplet、4 个 Base Tile 与 2 个 Fabric Hub,通过混合键合实现三维直连
Cerebras CS-6 把这种探索推进到晶圆级。WSE 已经把 300mm 晶圆的二维面积用到极致:面积约 46,000mm²,超过掩模版极限 50 倍;WSE-3 集成 4 万亿晶体管和 90 万个计算核心。但横向扩展逼近极限后,片上 SRAM 从 WSE-2 的 40GB 增至 WSE-3 的 44GB,容量增长明显放缓。CS-6 因而尝试把 3D DRAM 直接叠在逻辑/SRAM 晶圆之上,用纵向带宽继续扩展存储。它比 AMD、Intel 的局部堆叠更激进,也更值得怀疑:晶圆级系统能否在数据中心大规模部署,相比多芯片 Scale-up 路线是否真有系统优势,目前尚未得到充分证明。DRAM 上叠还会把散热、良率和缺陷绕行问题,与存储一致性、时序和功耗管理等编程问题绑在一起。CS-6 的关键不只是能否造出来,而是能否被稳定、经济地用起来。

Cerebras CS-6:在晶圆级引擎之上堆叠 DRAM,以纵向扩展突破二维面积和片上 SRAM 容量的约束
D-Matrix 在 Hot Chips 2026 讨论的 Raptor 3D-DRAM,则代表一条更保守的计算—存储垂直集成路线。它采用“逻辑 Die + 3D DRAM”的面对面(Face-to-Face,F2F)结构:顶部为 TSMC N4 逻辑芯片,底部为 3D DRAM,通过约 36μm 节距的微凸点与 TSV,把存储放到计算单元下方。它没有采用混合键合,互连密度和带宽因此受限,却降低了工艺风险,也放宽了两块芯片对面积一致性的要求;同时只做一层堆叠,进一步优先考虑可靠性、成本与量产良率。与 Cerebras 相比,Raptor 不追求一步跨越,而是在可制造性与性能之间选择更现实的平衡。

D-Matrix Raptor 3D-DRAM:顶部为 TSMC N4 逻辑 Die,底部为 3D DRAM,采用约 36μm 间距的 F2F 面对面堆叠
从 reticle 级的 AMD、Intel,到晶圆级的 Cerebras,再到较保守的 D-Matrix,3.5D 集成并没有唯一答案。真正一致的趋势,是系统优化正从“增加多少计算单元”转向“如何减少数据搬运”:垂直互连让计算、缓存与存储成为近邻,横向互连负责扩展规模。代价也随之转移——大 die 的制造风险被拆开了,键合良率、热管理、封装产能和软件复杂度却成为新的瓶颈。3.5D 的竞争,本质上是在性能、可制造性与可编程性之间重新寻找平衡。
这正是《集成芯片与芯粒技术白皮书(第二版)》将 3.5D 集成列为重要趋势的现实背景。白皮书同时强调的散热供电与多物理场仿真,也不是外围问题,而是决定这条路线能否从少数旗舰产品走向规模化应用的基础能力。
02 2.5D 集成:如何应对 DRAM/HBM 价格上涨
3.5D 集成为系统扩展打开了新空间,也带来了更复杂的热、力、电耦合问题。垂直堆叠会提高局部功率密度,混合键合仍受到翘曲、对准精度与良率约束。因此,3.5D 集成更像正在加速演进的关键路径;相比之下,经过十余年量产验证的 2.5D 集成,仍是当前大算力芯片更成熟、更可靠的集成路线。Hot Chips 2026 上,围绕 2.5D 集成展开的竞争依然最为充分。
让这场竞争升温的,还有 2026 年以来的内存价格:传统 DRAM 合约价一度单季上涨 90% 以上,HBM 的晶圆消耗又显著高于 DDR5,成本随之上行。若把封装、带宽和可用容量一并计入,一些系统中 DRAM/HBM 的有效单位容量成本与片上 SRAM 的差距正在缩小,“DRAM 天然便宜”的旧直觉不再足以指导设计。如何配置 HBM 与 SRAM、哪些数据必须留在片内,因而成为 2.5D 集成的重要考察方向,并直接决定每 Token 的成本与吞吐率。
围绕这本“内存账”,不同厂商给出了不同答案。微软 Maia 200 配置 272MB 片上 SRAM,用于保留热点数据;按照官方口径,其单位成本性能提高 30%,同功耗 Token 吞吐提升 40% 以上。

Microsoft Maia 200 SoC:Tile/Cluster 结构、HBM3E 与集成 NIC 协同设计,FP4 峰值算力 10,145 TOPS
SambaNova SN50 将模型计算图映射到片上,使 decode 阶段的数据尽量不离开芯片,并以成本更低的 CXL-DDR 承载 Prompt Cache,减少对 HBM 容量的依赖,单机架可运行 671B 参数模型。
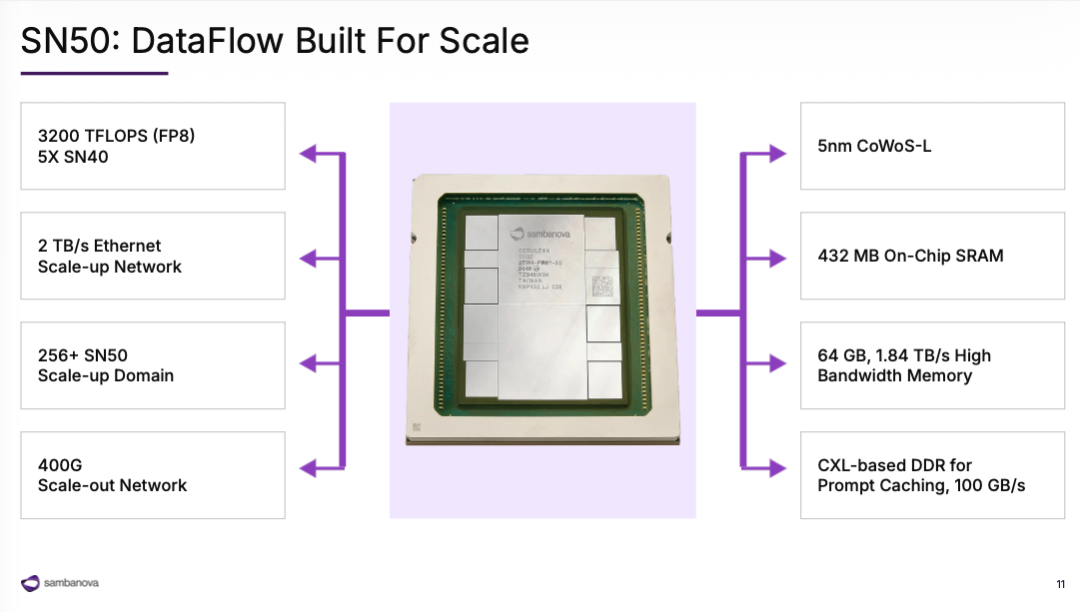
SambaNova SN50:可重构数据流 RDU,FP8 峰值算力 3,200 TFLOPS,配置 432MB 片上 SRAM 与 2TB/s 以太网 Scale-up
Google 则从第四代开始,就长期贯彻推理卡与训练卡各走一路的思路。这一代 TPU 8i 将 KV Cache 放入 384MB 片上 SRAM,以降低相较 HBM 的访问延迟和能耗,官方给出的单位成本性能提升为 80%;而 TPU 8t 更侧重训练、TPU 8i 更侧重推理,即便在统一架构下,训练与推理也被拆分成差异化的存储配置。在此过程中,如何在推理卡上做裁剪、从而提升成本效益,成了最关键的考察点。

Google TPU 8t / 8i:同样面向大模型,8t 侧重训练、8i 侧重推理,计算与存储配置随工作负载分化。
OpenAI Jalapeño 强调数据局部性:64 个计算切片分别配置近邻 HBM,尽量避免数据跨区域搬运,实测吞吐约为 GB200 的 2.7 倍。更值得玩味的是,它把 AI 引入芯片设计迭代,本身也在尝试降低工程投入。过去,降本主要靠缩小芯片或减少存储;未来,会不会连工程师数量也成为优化变量?这句略带玩笑的追问,对今天的毕业生却并不轻松。
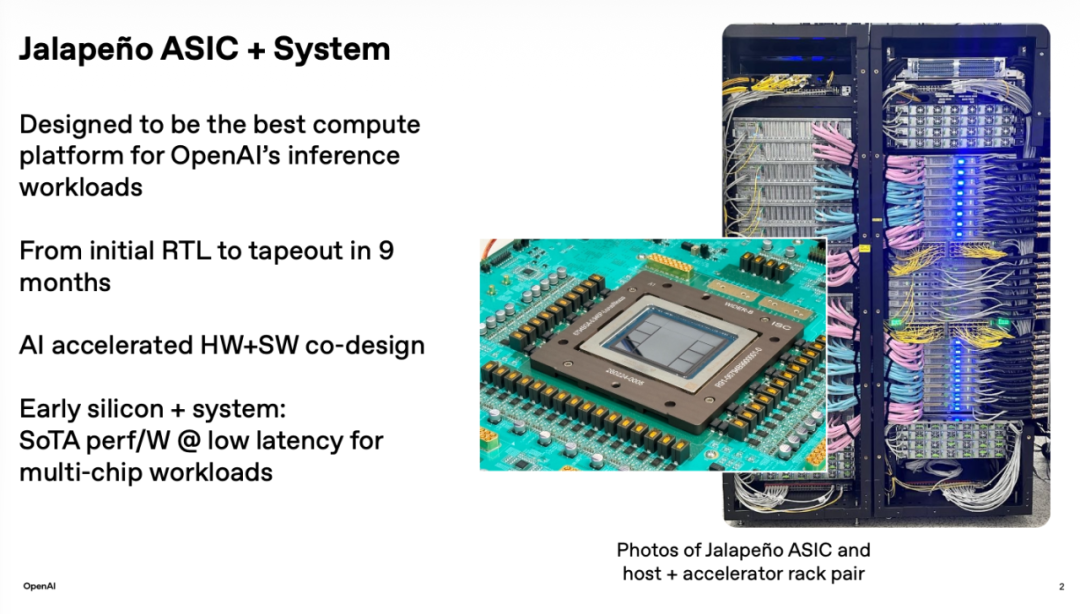
OpenAI Jalapeño ASIC 与系统:针对推理负载定制,从 RTL 到流片历时 9 个月(官方演讲截图)。
单 die、双 die、训推分离、存储切片,这些选择表面上不同,本质上都在权衡数据驻留位置、带宽、容量和成本。白皮书将“计算向存储靠近、存储层级重新组织”的探索概括为近 DRAM 计算趋势。HBM 靠近计算、增加片上 SRAM、将 KV Cache 内移,都是这一趋势的具体形态。3.5D 集成仍需继续解决散热和多物理场问题,而成熟的 2.5D 集成正在以更可控的工程代价,承接当前这一轮内存成本压力。
03 逻辑折叠 vs 逻辑堆叠:到底有没有用?
逻辑折叠(Logic Folding),是把大模块内部的逻辑单元与关键路径按数据依赖关系分到不同层,再通过垂直互连重新接近;它不同于逻辑堆叠(Logic Stacking)——后者通常只是把缓存、计算或存储等大模块叠在一起,前者则深入模块内部,几乎要对每一级电路和互连重新布局。华为提出这一思路,与韬定律的判断直接相关:当制程微缩的边际收益下降,互连逐渐取代晶体管本身,成为延迟和功耗的重要来源。既然瓶颈在“线”,就把平面上的长线折成更短的垂直连接。问题也由此而来:如此细粒度的折叠,带来的收益是否足以覆盖设计、制造与散热的额外代价?
逻辑折叠的核心是双层细粒度堆叠:按照数据依赖关系将逻辑划分到上下两层,通过混合键合实现单元级近邻连接,而不是只在大模块层面进行堆叠。其因果链条可以清楚地展开:细粒度堆叠将原本需要水平长走线连接的逻辑单元改为垂直相邻,使总布线长度减少;走线缩短带来 RC 延迟下降,关键路径随之缩短;获得时序裕量后,系统可以在维持目标性能的前提下降低电压和频率;根据动态功耗关系 Pdynamic∝CV²f,电压和频率下降最终转化为功耗降低与能效提升。公开数据中,走线长度约减少 20%,关键路径约减少 70%。

TIRAMISU 逻辑聚合:在不改变 RTL 的前提下,将二维长互连折叠为更短的三维互连(官方技术图)。
麒麟 9050 Pro 给出了系统级验证:三层堆叠与约 5000 万个垂直连接,将 Reg2Reg 距离从 1.0L 压缩至 0.xL,晶体管密度由 1.55 亿/mm² 提升到 2.38 亿/mm²(约 +55%)。在等性能条件下,NPU 频率下降 63%,工作电压由 0.85V 降至 0.55V,功耗下降 66%;GPU 与 CPU 性能核功耗分别下降 58% 和 41%。这些收益并不意味着“堆得更密就天然更凉”,而是说明缩短互连后节省的搬运功耗和获得的降压空间,有可能抵消部分三维堆叠带来的热密度压力。

逻辑级三维集成还需要同步时钟、垂直互连和可编程供电网络协同工作(华为官方技术图)。
但至少有一个问号值得保留。逻辑折叠的收益更多体现在单个模块内部:面积缩小、布线缩短,带来的好处偏局部。相比之下,逻辑堆叠可以在模块与模块之间实现——例如 AMD 的 3D V-Cache,虽然是非常大的模块,依然能对整体性能带来显著增益。换句话说,逻辑折叠的局部优势,对手机这类对面积与能效敏感的芯片很有价值;但对追求极致吞吐的算力芯片而言,逻辑折叠是否同样具有那么高的意义,恐怕还要打个问号。况且,τ=RC 描述的是时间常数、并不是能量定律,若把缩短关键路径获得的余量全部用于提高频率,功耗仍会回升,早期 DSP 折叠实验中功率密度也曾上升 24%。这些都在提醒我们:逻辑折叠的收益并非没有代价。
04 集成芯片下半场的学术盛宴
前面三种路线看似差异很大,背后其实是同一道题:在制程之外,如何重新组织计算、存储与互连。7 月 18 日,第三届 CCF 芯片大会在无锡举行,《集成芯片与芯粒技术白皮书(第二版)》在开幕式上正式发布,为这些正在分化的探索提供了一个共同框架。中国科学院院士刘明、施毅共同发布白皮书,白皮书秘书组组长韩银和系统介绍了集成芯片的基本内涵、技术演进与未来趋势。

第三届 CCF 芯片大会现场:《集成芯片与芯粒技术白皮书(第二版)》正式发布(现场实拍)。
白皮书下载:《集成芯片与芯粒技术白皮书(第二版)》|https://www.gitlink.org.cn/zone/iChips/source
这套白皮书的脉络始于 2023 年 10 月。第一版在 CCF DAC 2023 发布,尝试把原本分散在体系结构、先进封装、EDA、互连和工艺等领域的讨论纳入同一框架,并提出芯粒抽象描述、大规模芯粒并行、测试容错、散热供电、多物理场仿真等十项技术难题。它主要回答“集成芯片是什么、有哪些关键问题需要解决”。
三年后,第二版进一步追问“集成芯片将走向何方”。白皮书用“新能源汽车”作类比:汽车电动化并非简单地用电机替换发动机,而是重构动力系统、电子电气架构、软件和供应链;同样,集成芯片也不只是封装技术升级,而是要在同一套系统工程中重新组织计算、存储、互连、工艺、EDA 与测试。芯片的物理边界由此变得模糊,产业分工和创新机会也随之改变。
本文讨论的三个方向,正可以放进这一框架中理解:AMD、Intel、Cerebras 以及 D-Matrix 展示了 3.5D 集成在不同尺度上的形态;各家 2.5D 集成芯片围绕 HBM、SRAM 和 KV Cache 进行取舍,呼应了近 DRAM 计算与存储层级重组;逻辑折叠则表明,随着混合键合节距缩小,三维集成正在从芯粒级继续深入到逻辑级。白皮书提出的 3.5D 集成、近 DRAM 计算、光 I/O、芯粒库和开放互连等趋势,说明所谓制程之外的“第三条路径”,正在从概念讨论走向更完整的技术体系。
而这套体系仍在快速演进,许多答案尚未定型。第四届集成芯片和芯粒大会将于 2026 年 10 月 9—10 日在上海浦东嘉里大酒店举行,主题为“三维连 Token,智能芯时代”。大会将继续汇聚学术界与产业界,围绕前沿技术、产业创新和生态建设展开交流。对于希望理解集成芯片下一步技术走向、寻找跨领域合作机会的研究者与从业者,这将是一场值得参加的学术盛宴。大会早鸟注册现已延期至 9 月 25 日。

第四届集成芯片和芯粒大会 ICCC 2026|2026.10.09—10|中国·上海
第四届集成芯片和芯粒大会
时间:2026 年 10 月 9—10 日(10 月 8 日报到)
地点:上海浦东嘉里大酒店
主题:“三维连 Token,智能芯时代”
主办:复旦大学、中国科学院计算技术研究所、武汉大学
早鸟注册已延期至 9 月 25 日:学生 ¥800,非学生 ¥1600(含午餐,不含晚宴);之后正常注册费为学生 ¥1000,非学生 ¥2000。官网:iccconf.cn/entry。



