林方舟 发自 凹非寺
量子位 | 公众号 QbitAI
叮咚~众包骑手,哦不,众包数采员来新单了!
一边干着家务或上着班,一边轻松地采集具身数据,结束了还能赚一笔外快,真有这样的好事吗?
答案是肯定的。上个月,Figure推出了机器人训练数据众包平台Index,如今,“中国版Index”也来了。
9月23日,觅蜂科技打造的“觅蜂派”亮相,“硬件+App+数据引擎”三位一体,自称是“全球首个全品类高质量物理AI数据众包服务平台”。

普通人下载“觅蜂派”手机软件,申领一台采集设备,领取采集任务,便可以接单采数据了。用户不用额外付出时间,不影响正常的工作和生活。这些数据经治理、分级后,再被售卖,用于机器人训练。
外卖、网约车等行业都靠众包模式取得了成功,甚至连自媒体在某种程度上也是一种众包,那么在天花板更高的具身智能领域,众包数采能跑通吗?
2万台设备,百万小时数据
一条机器人训练的无本体数据,从采集到使用,一共分为几步?
作为一家具身数据服务商,觅蜂给出的答案是:采→懂→译→用,一共4步。
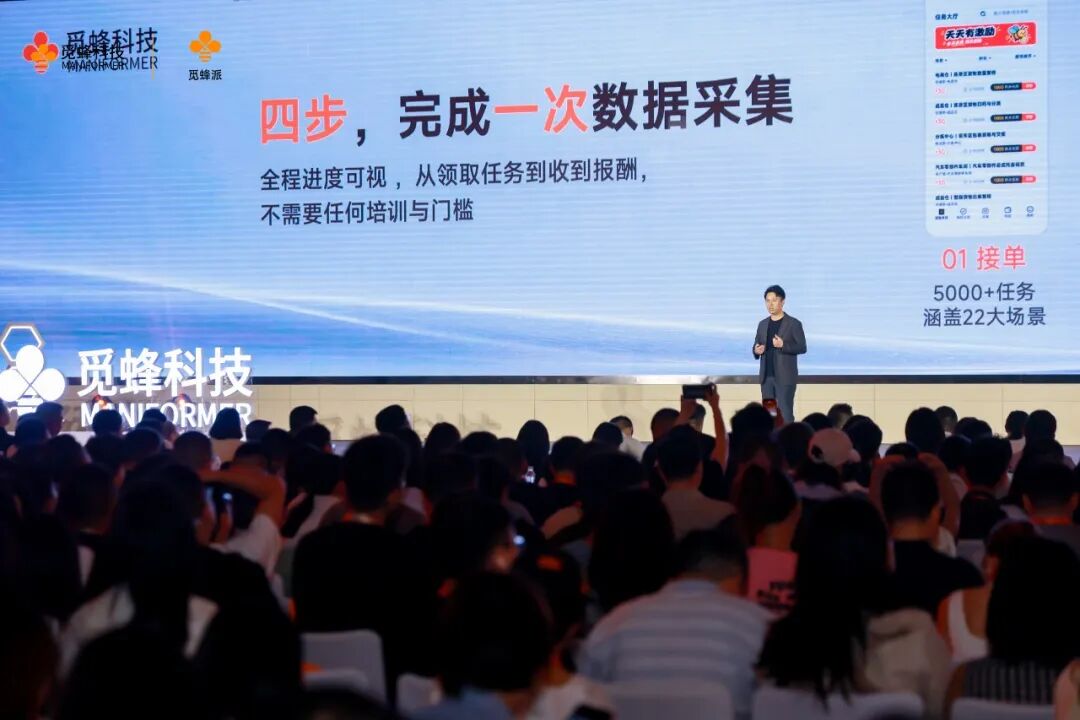
先说第一步——采集。采集所需的硬件设备是一切的基础。
觅蜂自研的MEgo系列无本体采集终端,包括MEgo View和MEgo Gripper两个产品。
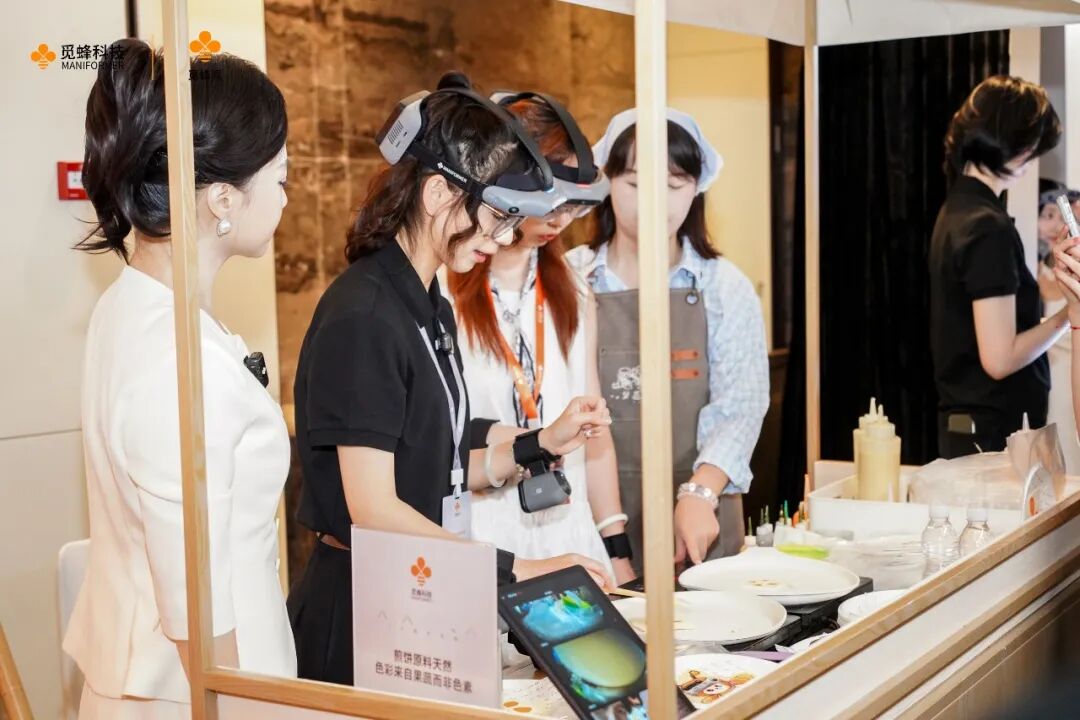
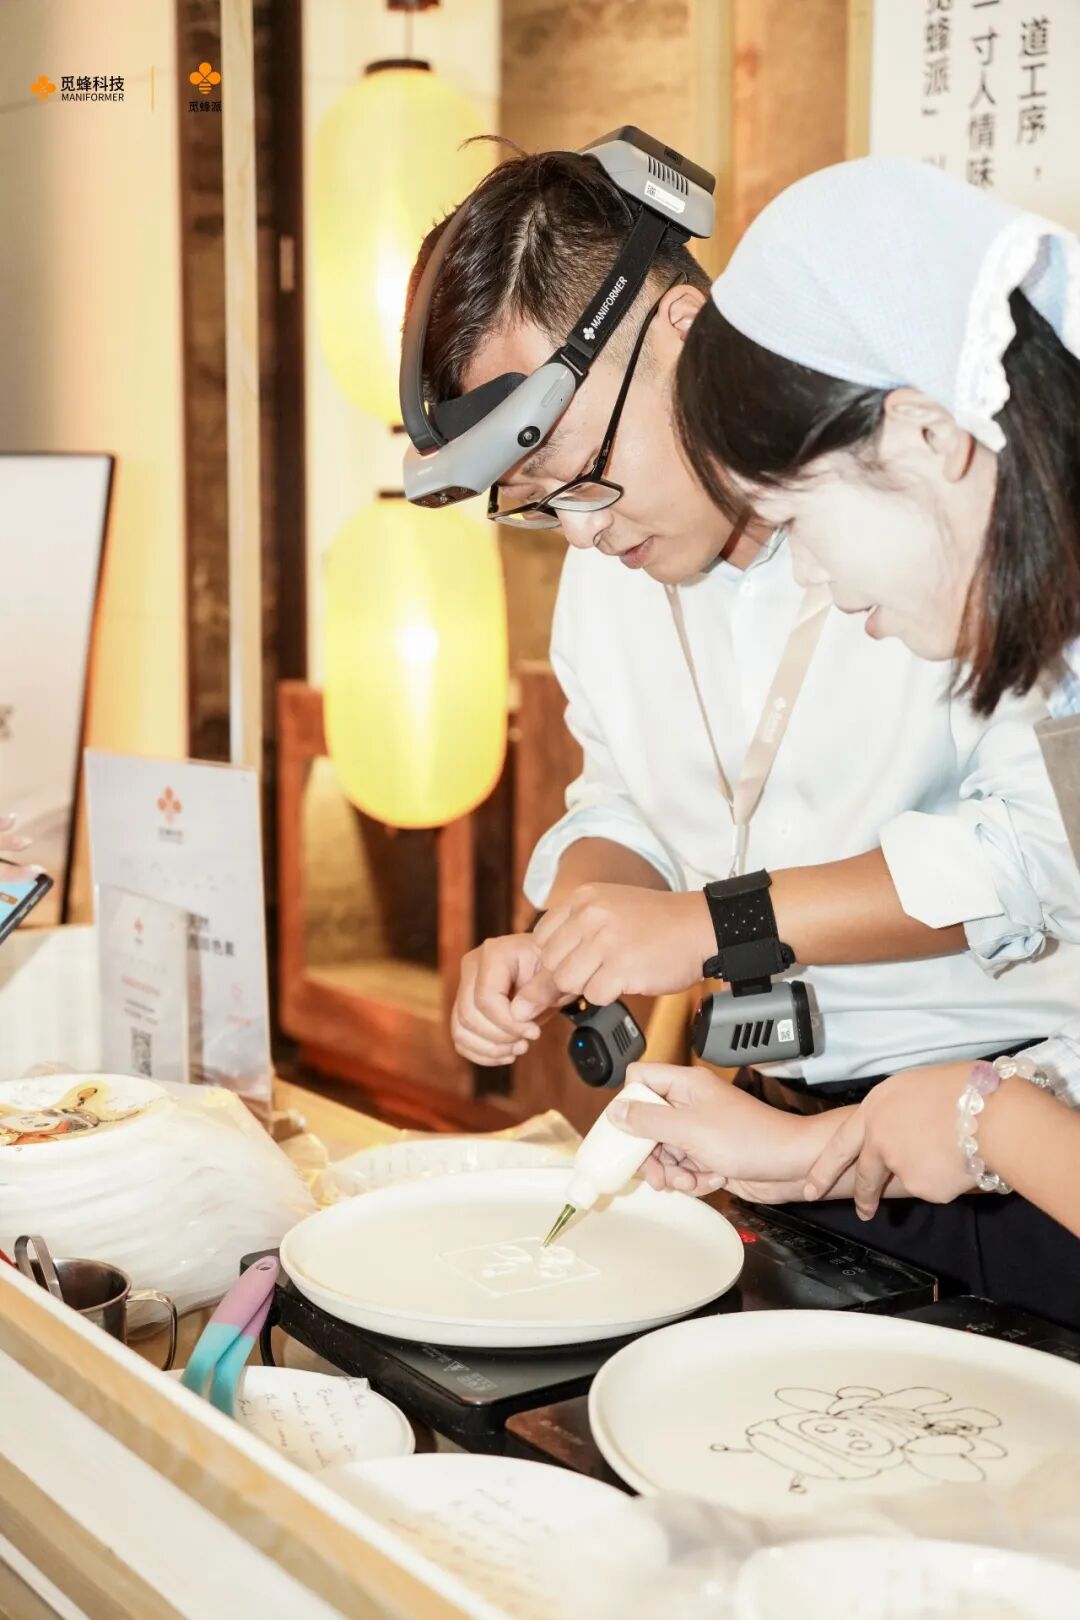
MEgo View针对的是Ego数采场景,采用头戴式全景相机+腕部特写相机,头部视角记录周围环境,腕部视角补充操作细节。
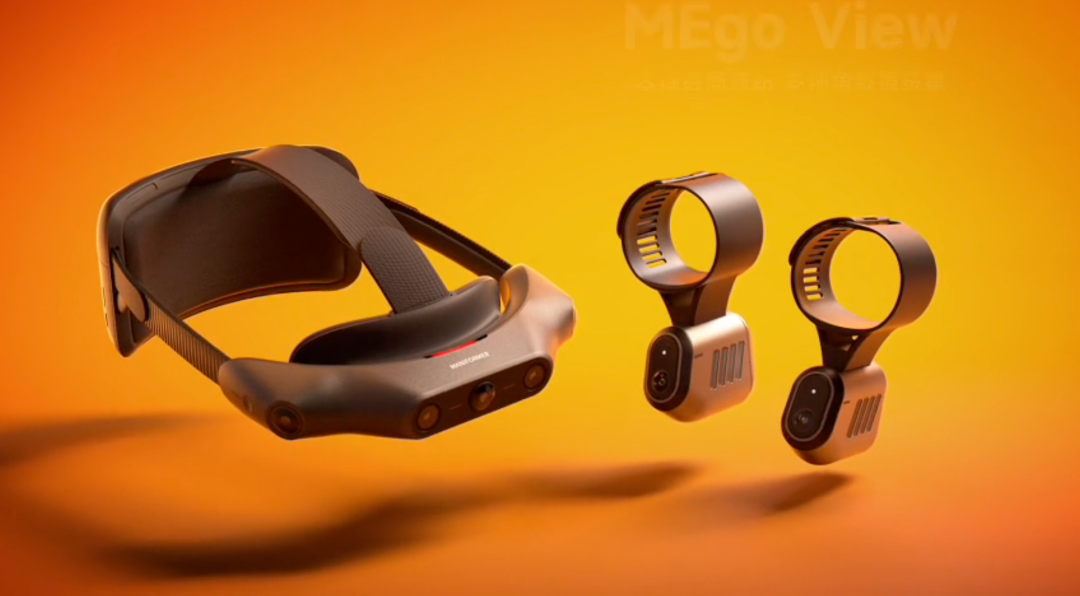
而MEgo Gripper是UMI设备,轻量化采集夹爪重不到一斤,标配三维触觉。

我也体验了一下MEgo View,它不是很重,戴在头上感觉跟戴电动车头盔差不多,长时间佩戴也不会有太大压力。而且操作简单,不需要调试,像戴帽子一样自然。
这种轻量化、无线设计对于“In the wild”采集数据非常重要。毕竟,谁也不想像戴个刑具似的,俺们脆皮的肩颈是真的受不了啊!
截至目前,觅蜂已经下线了2万套MEgo设备,这是行业第一次把这类设备做到大规模量产。
行业里的玩家都想早日实现规模化。规模化意味着成本下降,意味着生态有了基础,意味着数据飞轮有望运转……好处有太多太多。
觅蜂董事长兼CEO姚卯青说,电网建成之后,电力才真正改变了世界。如今,具身数据采集也有了属于自己的基础设施。
姚卯青透露,MEgo设备现在的产能达到数万套/月。这意味着,公司可以快速拉升设备的保有量。
如今,这2万套MEgo设备已进入真实场景,累计采集了百万小时有效数据。觅蜂自称是行业首家拥有百万小时级可对外售卖无本体数据的数据服务商。
这些数据全来自开放环境的真实采集,覆盖22大类场景,采集形态包括裸手、腕戴和夹爪,数据模态涵盖彩色图像、深度、惯性测量、触觉和音频等。

手被挡住也没关系
“采下来”只是第一步,接下来还要“看得懂”和“译得准”。
奶茶店员拿起杯子,手指被杯身挡住一大半;美甲师和顾客的手凑在一起,到底哪只手是采集者的;给宠物洗澡,手上全是沐浴露的泡沫……
真实世界的动作天然复杂。高速运动、手部出框、重度遮挡、多人交互等等在实验室里被刻意规避的“雷区”,恰恰是真实世界的日常。
怎么从这些复杂的视频里,准确重建人类手部动作和全身姿态,还要弄清每一步在做什么?
这就是MEgo Engine数据引擎要干的活。它负责对数据做预处理、空间感知、标注和质量评估等一整套工作。

例如,数据引擎中的HandPose高精度手部重建技术,专门处理手部动作这个难点。
它结合五目全景感知、手部追踪和三目深度融合,再通过参数化手部重建、轨迹恢复等技术,还原连续动作。
在遮挡、交互、快速移动等真实作业场景中,它的七项核心指标全部达到SOTA水平。
团队说,在奶茶制作场景中,即便手部可见率低于30%,仍能实现亚厘米级三维重建;美甲时,区分采集者与他人双手不在话下;宠物洗护时,高速运动产生模糊、泡沫改变手部外观,系统也能稳定重建。
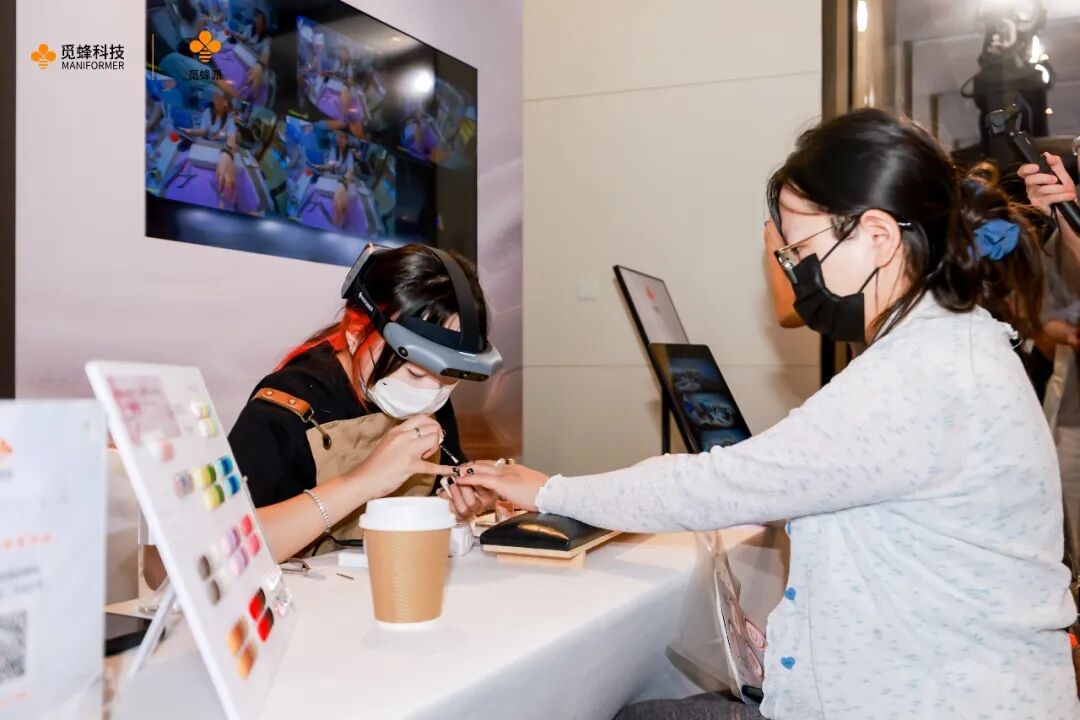
这大大解放了采集者,因为采集数据对于他们而言,只是日常工作基础上的锦上添花,总不能要求他们为了采数据,以0.5倍速做本职工作吧。
除了手部,觅蜂还构建了面向头部、身体、机器人末端及环境的空间重建能力。觅蜂自研的统一算法底座MPR,在头部、手部以及夹爪三类位姿重建上,轨迹还原误差均小于1厘米,环境稠密深度重建达到亚厘米级。
“翻车”数据也有用
数据处理好了,接下来就该回答:它能教会模型什么?
觅蜂的办法是先做“因材施教”。只不过,这次需要分班的是数据。
觅蜂的ManiEval多维度质检体系,从数据类型、任务类型、传感器质量、语义质量和动作质量等维度评估数据,再进行S、A、B、C分级,匹配不同训练需求。
动作轨迹精确的数据,可以用于策略模仿学习;场景丰富、任务含义清楚的数据,适合通用预训练和表征学习;操作失误的过程,可以用来训练错误识别;少见的场景和困难样本,则有助于检验、拓展泛化能力。
好家伙,没有废数据,只有放错地方的数据啊(doge)。
觅蜂把这套方法称为“不过滤,只分级”。不过,团队特别解释,这一做法以合规和基本质量要求为前提,并不代表所有原始数据都能直接拿来训练。
围绕具身大脑、视觉-语言-动作模型(VLA)、世界动作模型(WAM),觅蜂正在探索这些数据各自适合的用法。
其中,大规模无本体数据主要承担通用预训练的作用,让模型学习物体、动作、空间关系和任务过程。到了具体机器人上,仍需要对应本体的真机数据进行后训练和优化。

而机器人上岗之后,学习也没结束。
觅蜂自研的REMORA任务进度模型,能让模型理解机器人当前做到哪一步了、哪里出错了;再结合Value Model,筛选真实部署中有训练价值的失败和困难样本,送回数据体系。
也就是说,这次训练翻车了不打紧,经验和教训还可能成为下一轮训练的养料。
由此,觅蜂正在打通“采集—重建—质检—训练—部署—回流”的完整闭环,飞轮这不就转起来了嘛~
人人都能成为机器人训练师
聊完了设备和技术,最后再聊聊我认为觅蜂派最核心的一点——众包模式。
最近一段时间,一些国内外具身公司用无本体数据训练的模型都拿到了大结果。
例如Figure的Helix 2.5,先用Index收集的大规模人类行为数据打基础,再学习具体任务。机器人在30个陌生家庭干家务,加入人类数据预训练后,任务成功率从9%提高到了56%。

虽然具身数据还没有收敛,但在当下的行业内,无本体数据的优先级明显正在提升。
今年不少具身公司都喊出百万小时数据的目标,而到了明年,一些公司的数据规模目标又将提高一个数量级,达到千万小时。
如果具身模型要scaling up,千万甚至上亿小时级别的数据量是必要的,按照目前趋势看,其中大部分或许都是无本体数据。
觅蜂认为,现在集中式、半集中式的数据生产方式,无法满足不断增长的数据需求,成本也比较高,所以要逐步走向社会化采集。
说实话,我没想到用户对众包数采的积极性还挺高的。
觅蜂称,觅蜂派在正式上线前为期一个月的内测中,平台注册用户达到2万人之多,累计提交了1.3万份采集任务。
用户领取任务、佩戴MEgo设备完成指定操作,上传后通过审核,按有效时长获得相应报酬,有人一个月赚了5000多元。
觅蜂派的众包网络,包含“场景网络”和“人群网络”。场景网络连接酒店、餐饮、商超、物流、工厂、医疗、家庭、养老、非遗等真实作业环境;人群网络连接不同年龄、行业和地区的参与者。
觅蜂还给参加众包数采的人取了个专门的名字:机器人训练师。由此,众包网络中的超市店员、酒店清洁工、餐厅服务员,有了一个新的身份。
在大洋彼岸,Figure的Index也在尝试众包这条路。
今年8月,Index从隐身状态浮出水面,四个月内积累了1600万条上传视频,覆盖108个国家,应用下载量突破26.4万次,每周活跃贡献者超过4.3万人,已向参与者支付1500万美元报酬,Figure计划未来一年在数据和算力上投入超过10亿美元。

两家公司的共同判断是:具身智能的数据瓶颈,不能靠堆专职采集员的人力,得把“人人都能成为机器人训练师”这条路跑通。
但觅蜂与Index也有显著差异。
Index是Figure自家训练模型用的,属于“自产自销”;而觅蜂派面向的是各类数据采购客户,按客户需求组织生产,处理后对外交付。
客户多了,需要的场景、任务、数据模态和质量标准也更复杂。要给各行各业的客户提供数据,觅蜂靠啥保证这么多品类?
一方面,中国具有庞大的产业场景基础,有全球规模最大的制造业体系、密度最高的物流仓储网络,还有数一数二丰富的零售和服务业态,这些真实场景是机器人最好的“教室”。
产业场景再丰富,也得有人把它们一个个接进数据生产链路。另一方面,觅蜂也在牵头拓展数据生态。

觅蜂发起了“场景数据联盟”,把场景方、采集网络、机器人和模型企业全拉进群,主打一个从需求、采集到训练、落地的“一条龙”闭环。首批就有50多家企业和机构入伙了。
据觅蜂披露,其百万小时级无本体数据已开始服务腾讯Robotics X实验室、蚂蚁灵波等客户。
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
🌟 点亮星标 🌟