蚂蚁AI安全实验室 投稿
量子位 | 公众号 QbitAI
AI实时交互,一直存在一个常见难点:查资料、跑任务需要时间,用户却常常在此期间继续追问或补充信息。
如何边处理当前的任务,边听懂并及时回应用户的新需求,是对AI助手的一大考验。
围绕这一挑战,TML-Interaction-Small、SeedRealtime及Qwen-Omni-Realtime近期相继推出了闭源方案。蚂蚁AI安全实验室与清华大学人机交互实验室则联合发布Realtime-Venus,通过开放模型权重与代码,将全双工交互与后台任务委托能力开放给开发者,支持自主部署、定制与扩展。
系统包含Omni和Audio两款能边听边说的全双工交互模型,模型的参数量均为9B。遇到需要外部能力的任务,模型可以委托后台处理,再将结果带回对话。用户在此期间仍可插话、追问或补充需求。
两款模型如何支持实时交互
Realtime-Venus将主动感知和对话控制交给前端模型,通过配套的Harness连接后台服务,让任务执行与对话同时进行。Omni还可借助外部记忆检索历史视听信息,回答与早先画面有关的问题。
持续感知,在关键时刻主动提醒
“裁判一吹哨就提醒我。”这个例子展示了Realtime-Venus-Omni的主动交互能力。模型持续接收比赛画面和声音,在关键事件发生前保持倾听,在示例时间线的第16秒发出提醒:“裁判吹哨了,比赛开始!”在这个过程中,用户只需交代任务,模型会持续观察,并根据新发生的事件判断是否开口。用户不必反复追问“现在呢”,助手也能在需要的时候主动回应。

△Omni持续观察比赛,在哨声出现后主动提醒
能边听边说,也要懂得何时停下
主动开口之后,还要知道什么时候停下来。用户说“对,没错”,通常是在鼓励助手继续;说“等等,我改一下”,则是在要求它停下来。旁边有人聊天,也未必是在跟AI说话。如果一检测到声音就停止回应,助手就可能把附和和无关声音都当成打断。
Realtime-Venus采用主动全双工交互,让模型在说话时继续接收输入,并结合语义判断何时续说、何时让出话语权。遇到用户纠正或提出新请求时,模型可以停下当前回应,调整尚未说出的内容,再继续交流。后台结果返回后,也需要结合当时的对话状态选择播报时机。
团队用Full-Duplex-Bench v1.5评估模型的对话表现。在用户附和、用户转而对他人说话,以及背景中出现人声这三类应当继续回应的场景中,Realtime-Venus-Audio的续说率分别为97%、88%和86%,均高于参评的Gemini 3.1 Live和GPT-4o。
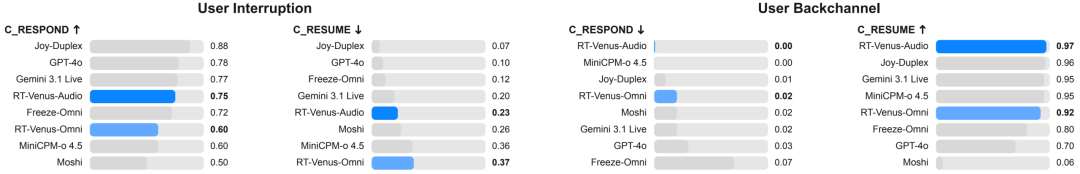
△用户打断与附和场景下的响应和续说表现
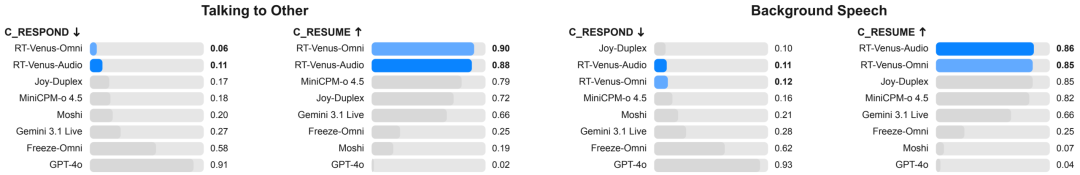
△对他人说话与背景人声场景下的响应和续说表现
面对用户真正的打断,Audio的响应率为75%,与上述闭源模型仍有差距。这组结果说明,模型在减少无关声音造成的中断方面表现较好,对用户真正打断的响应能力还需要提升。
后台执行任务,前端继续对话
查实时信息、调用业务工具或完成多步推理时,前端模型可以通过Delegate机制,用自然语言描述任务并委托后台处理。等待结果期间,模型仍能继续与用户对话。
团队配套设计的Realtime-Venus-Harness,负责连接前端模型与后台服务。一次委托从发出到结果回到对话,需要处理任务上下文、后台执行和结果交付几个环节。
委托发起时,Harness先保存当时可用的对话与视听证据,并将这些信息绑定到任务上。用户之后可以继续补充需求,已发出的任务则保留发起时的上下文,避免把不同时刻的信息混在一起。
任务随后交给已注册的后台能力执行,包括多模态感知、通用推理或自定义技能。后台处理期间,前端照常接收新输入,与用户保持交流。
结果返回后,Harness将其整理成适合口头表达的回复,送回原会话。此时用户可能正在说话,前端模型还要结合当前交互状态,选择合适的时机播报。
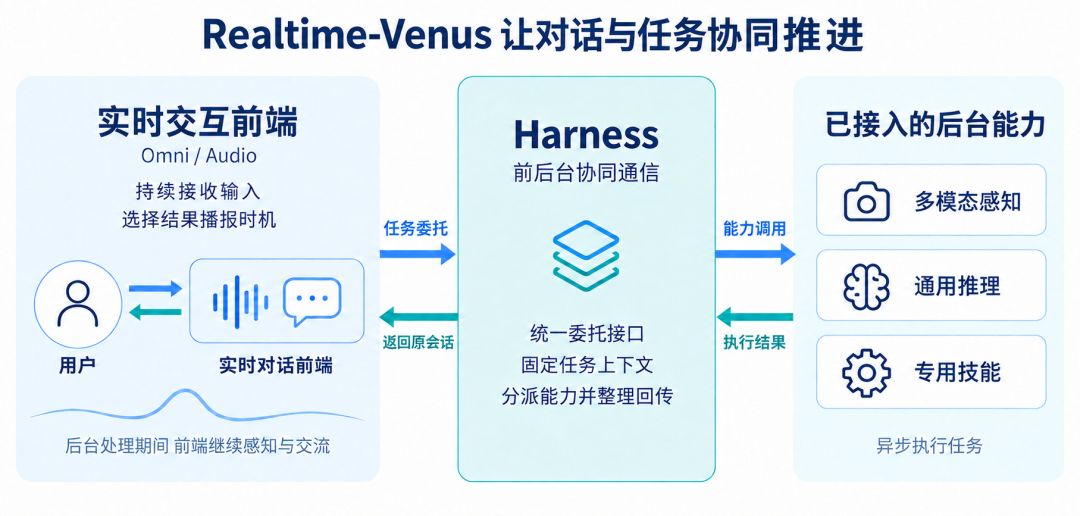
△前端持续感知和交流,Harness负责委托执行与结果回传
系统还会记录排队、执行中、已完成、交付中和已送达等任务状态。开发者据此可以区分结果尚未返回、已经返回但等待播报,以及语音已播放完毕等情况。接入新的推理模型或业务工具时,也可以复用这套委托与回传流程。
找回原先画面,回答当前追问
随着视频通话持续进行,早先的画面会逐渐移出模型的上下文窗口。用户再问“刚才是谁把盘子递给厨师的?”,相关场景可能已经不在当前窗口里。对话能够继续,回答问题所需的历史信息也得有办法找回来。
Realtime-Venus-Omni为此配备了长视频记忆模块,无需额外训练或更新参数。系统根据视觉变化等信号筛选历史画面,并保留与视频时间线对齐的音频。收到问题后,系统结合语义相关性与画面新颖度检索证据,再取回相关画面及其邻近音频,与近期视听内容一起重新组织为回答所需的上下文。
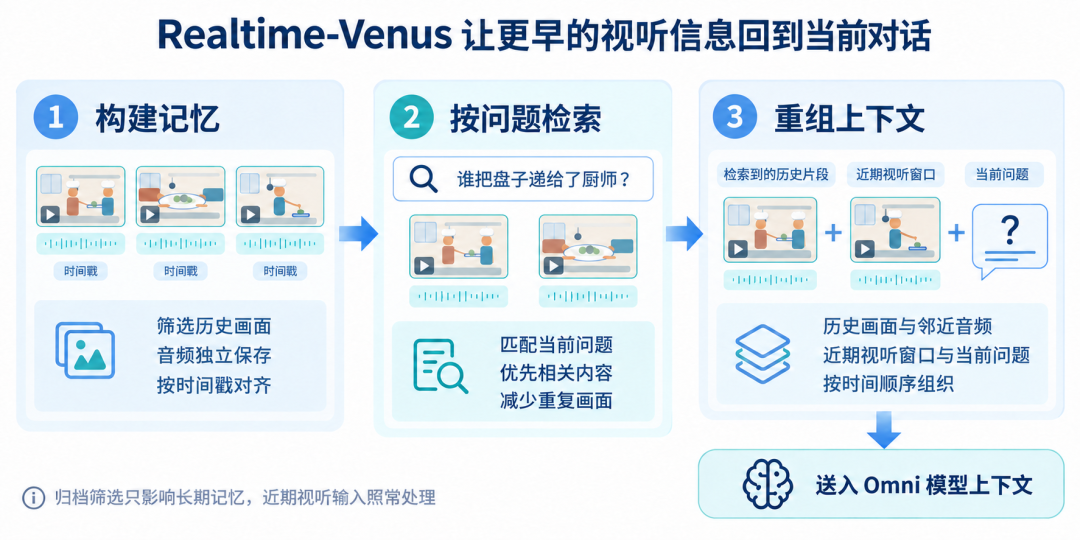
△构建记忆、检索历史证据、重组回答上下文
引入记忆模块后,Omni在长视频问答中的准确率有所提升。在LVOmniBench的60至90分钟视频子集上,准确率从41.18%升至47.06%,增加5.88个百分点;在LongVideoBench的40至60分钟子集上,从57.14%升至61.90%,增加4.76个百分点。
从视听理解到任务执行
除了双工能力和历史记忆,团队也评估了模型对当前输入的理解能力。视频理解方面,在对比的在线模型中,Realtime-Venus-Omni在八项视频基准中的六项取得最高分,其中StreamingBench为70.2%,OVO-Bench为64.7%,Daily-Omni为81.3%。
音频理解方面,Realtime-Venus-Audio在MMAU和MMAU-Pro上的得分分别为78.0%和63.2%,均为参评模型中的最高水平。语音问答方面,其Llama Questions得分为83.8%,Speech CMMLU得分为67.8%,均在所比较模型中领先;VoiceBench AlpacaEval得分为4.81,并列最高。

△视频理解、音频理解与语音问答结果
工具使用方面,在Full-Duplex-Bench v3中,Omni与Audio的工具选择F1分别为86.0%和82.0%,分列参评系统第二、第四,其中Omni仅次于GPT-Realtime。完成整项任务还需要准确填写参数,并顺利执行后续步骤。两款模型的完整任务成功率Pass@1分别为43.0%和42.0%,参数准确性和多步执行仍有提升空间。两款模型均基于MiniCPM-o 4.5构建,分别独立训练。用于后训练的语料总量超过280万条,涵盖九类数据源。其中,Omni使用视听与音频数据,Audio使用音频子集。
主创寄语
清华大学计算机系长聘教授、人机交互实验室负责人史元春表示:
“人机交互的终极目标,是让机器像人一样自然地理解和回应我们。Realtime-Venus让AI助手在‘想’的时候还能‘听’,在‘做’的时候还能‘说’——这朝着人机共生迈出了一步。但自然的交互不止于听和说,还包括理解上下文、预判需求、在合适的时机交付结果。从‘能交互’到‘会交互’,我们还有很长的路要走。”
让实时助手更自然,也更可靠
Realtime-Venus尝试让用户在AI办事的过程中持续参与。前端模型继续接收新输入、回应用户,Harness负责将任务委托给后台,并把结果送回对话。用户追问早先的画面时,Omni还可以借助外部记忆找回相关证据。
现有评测也给出了后续改进的方向。模型对用户真正打断的响应仍需改善,工具调用也要进一步提高参数准确性和多步执行的成功率。进入更长时间的连续交互后,如何保留有用信息、在任务失败后恢复,还需要更多验证。
团队接下来将继续探索更细粒度的流式交互和更长的上下文窗口,并研究复杂任务的执行与恢复。开源之后,开发者可以接入自己的业务工具,在实际使用中检验对话节奏和任务完成情况。这些来自具体场景的尝试,有助于发现和解决问题,让助手在持续交流中更可靠地把事情做好。
项目主页:https://realtime-venus.github.io
GitHub链接:https://github.com/inclusionAI/Realtime-Venus
HuggingFace链接:https://huggingface.co/inclusionAI/Realtime-Venus
ModelScope链接:https://www.modelscope.cn/models/inclusionAI/Realtime-Venus
一键三连「点赞」「转发」「小心心」
欢迎在评论区留下你的想法!
— 完 —
【学术投稿】请在工作日发送邮件至:ai@qbitai.com,标题注明【投稿】,并告诉我们:你是谁,从哪来,投稿内容附上项目/主页链接,以及联系方式。
🌟 点亮星标 🌟