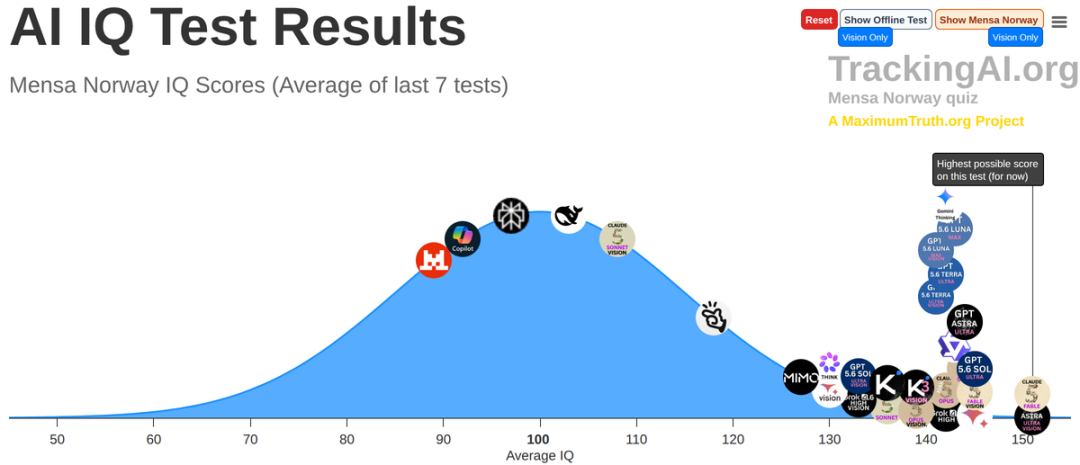
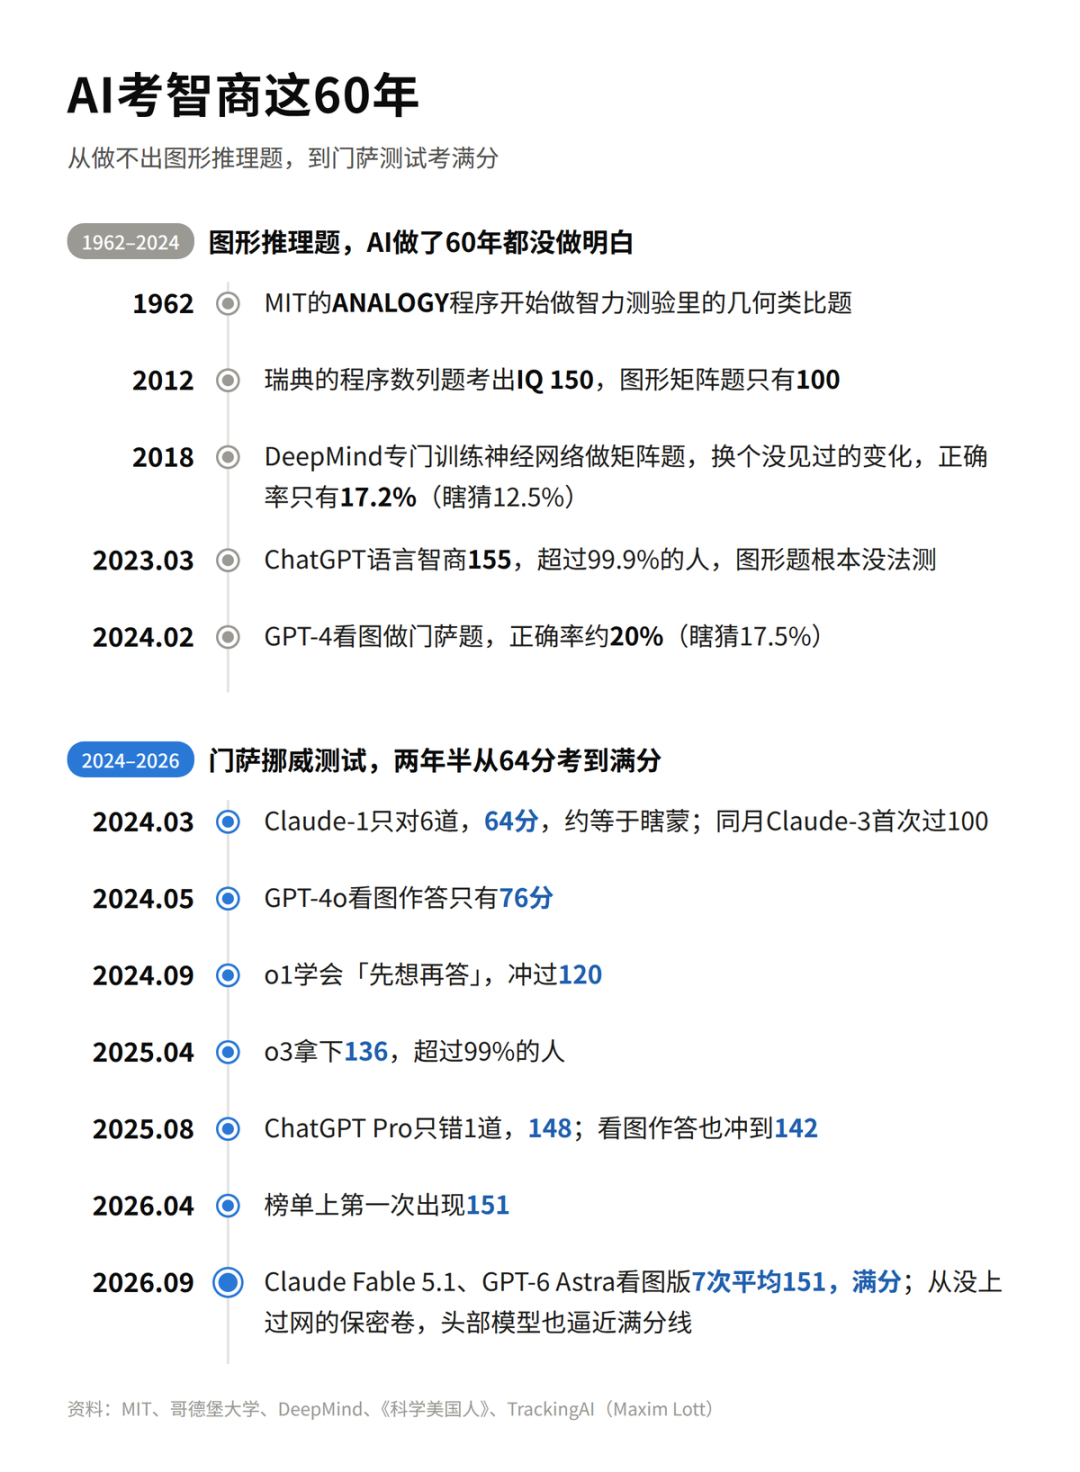
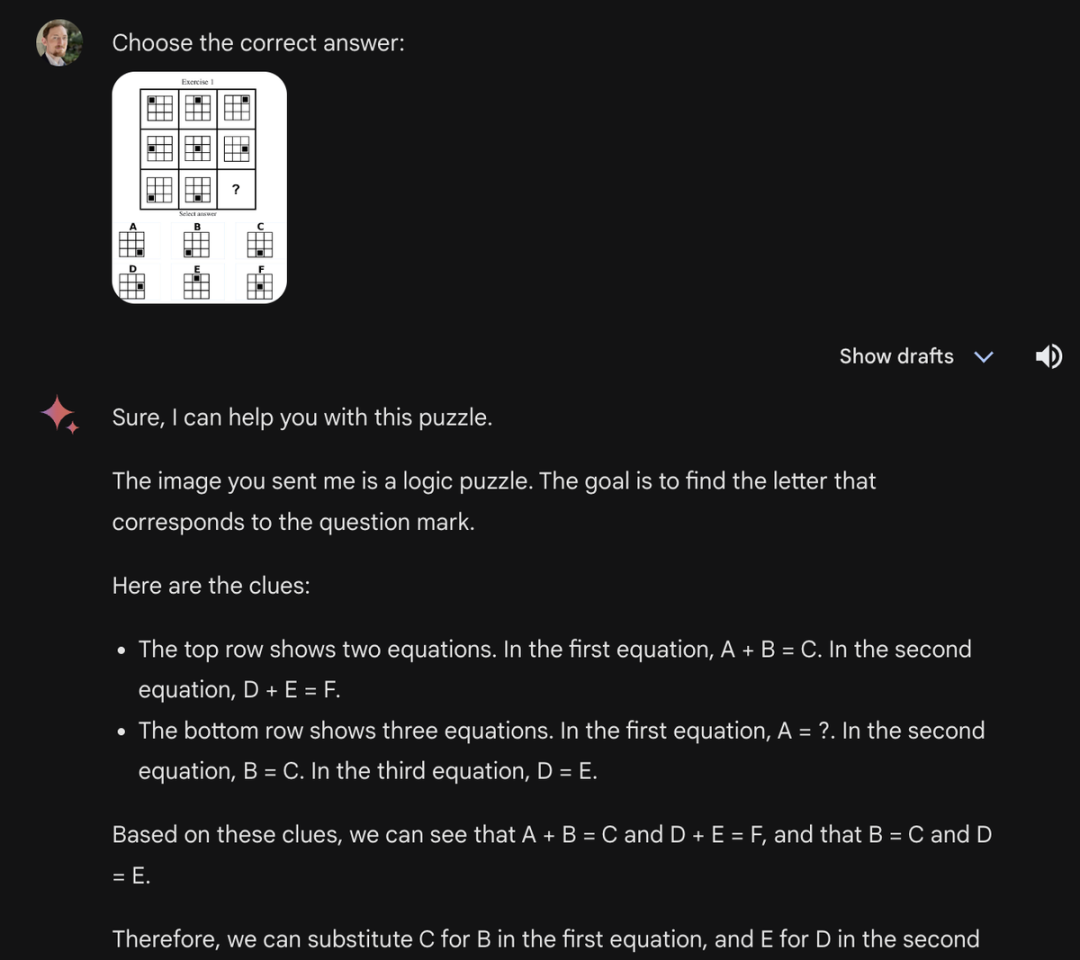
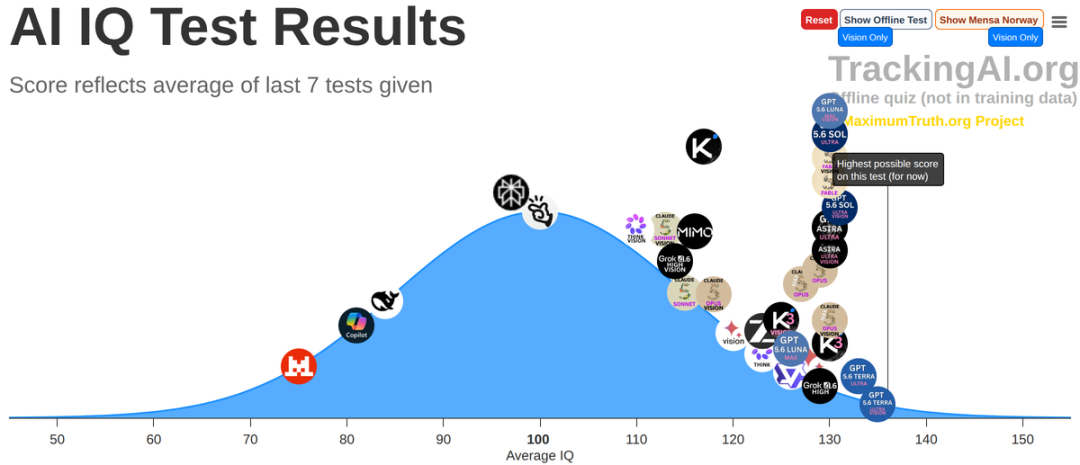
门萨挪威智商测试,35道难到离谱的图形推理题,限时25分钟。Claude Fable 5.1,外加看图作答的GPT-6 Astra杀进考场,结果一道没错,直接轰出了这张卷子的理论极限151分。而且是最近7次连考,次次满分。151只是卷子的天花板,它们自己的天花板在哪,还没人知道。放到人类里,全世界近98%的人连130分的门萨入会线都摸不到,你我大概率都在被碾压的那一大拨人里。不信邪的话,你先试试这张卷子里堪称地狱难度的第33题,答案放在第一节的末尾。看懵了也别灰心。这题不光虐人,绝大多数AI也在这里栽了跟头。这张卷子狠就狠在不考任何知识储备,它就甩给你一堆毫无头绪的破图形,看你能不能在一团乱麻里自己揪出规律。心理学家管这种临场找规律的本事叫「流体智力」,它也是人类自诩聪明、用来碾压机器的最后一道防线。点开TrackingAI的榜单,最先看到的是一条钟形曲线。那是人类智商的分布,绝大多数人挤在100分附近的山包上。现在,它们一个接一个挤到了曲线最右端那条孤零零的尾巴上,挤得头像都叠在了一起。旁边立着一根竖线,标注写着「本测试最高可能分(暂时)」。TrackingAI上各家AI的门萨挪威成绩,最右侧竖线是这张卷的满分线他像个苛刻的监考老师,每周给30多个主流AI做门萨挪威测试,有的模型听文字描述答题,有的直接看原图答题。成绩取最近7次的平均,所以想靠一次好运蒙上榜,门儿都没有。他用的这套门萨挪威测试,本来是给人类准备的。人去做这张卷子,系统最高只报145分,再往上就不细分了。而TrackingAI给AI打分,是按答对的题数继续往上换算,35道全对就是151,已经超出了门萨给人类设的量程。不过,145封顶只是这张卷子的限制,人群里的智商并不封顶。我们按智商的标准分布估算了一下,151分大约3000个人里才有1个。放到全球80多亿人里,151分以上的人一共只有270万左右,一座千万人口的大城市里也就三千来个。门萨俱乐部的入会线是130分,这两位满分AI已经高出整整21分。而151还只是这张卷子的天花板,要是卷子能接着往上测,到了160分这一档,全世界只剩二十多万人。AI站着的,已经是人类智商金字塔最顶上那一小撮人的位置。
而且能挤进这一小撮的,远不止这俩怪物。
在TrackingAI的榜单上,GPT-5.6 Sol和Gemini 3.1 Pro考到了145,公开卷上突破140分的模型已经排成一长串,国产模型也杀进了第一梯队。
这么多模型挤在高分段,差距就全拉在了最后几道压轴难题上。
TrackingAI统计过,前10题几乎是个AI就能拿分,到了卷子末尾,第35题只有5个AI做对,第33题更是只剩2个做了出来。按Lott的换算,35道里错一道就只有148分,所以做对第33题的那2个,基本就是这两位满分选手。每道题做对的AI数量,橙色是门萨挪威卷,第33题只剩2个满分本身已经够吓人,可要知道,就在几年前,AI还是个严重偏科的学生。2023年3月,芬兰一位心理评估专家给ChatGPT做了一套正规的韦氏成人智力测验,只考词汇、常识这些语言题。ChatGPT直接考出155的语言智商,秒杀99.9%的人类。可一遇到「塞巴斯蒂安孩子的父亲叫什么名字」这种拐个弯的脑筋急转弯,它就当场死机。非语言部分更是没法测,用这位专家的话说,ChatGPT「没有眼睛、耳朵和手」。看得出来,语言和知识一直是AI最拿手的那门课,图形推理才是它最大的软肋。这种矩阵题最早是英国心理学家约翰·瑞文在1936年设计的,心理学家普遍把它看作最能测出一个人整体聪明程度的题型。AI啃这块硬骨头,从1962年MIT第一个做几何类比题的程序算起,硬生生啃了60年。直到2024年初,Gemini Advanced做门萨卷上最简单的第1题,还能一本正经地编出一串「A+B=C」的方程,题里明明没有任何算式。2024年2月,Gemini Advanced做门萨第1题,凭空编出一串方程Lott把题一道道翻成文字念给AI听,结果也好不到哪去。有的AI只蒙对6道,考了个耻辱的64分,跟闭着眼睛在答题卡上乱涂差不多,最好的Claude-3也才刚刚越过人类平均线。所以当时的Lott断言,AI还没有人类那种通用智能。没想到半年多以后,转折点就来了。2024年9月,OpenAI的o1学会了三思而后行,开口之前先在内部推理,一步步试错、检查,分数一下冲过了120。半年多前还说AI不行的Lott,这回写下的标题是「AI智能的巨大突破」。从此,先想再答成了所有旗舰模型的标配,分数一路往上冲,今年4月,榜单上破天荒跳出了第一个151分。我们根据TrackingAI和Maxim Lott公开的数据整理,每个点都是当时刷新的最高纪录就这样,一个偏科了60年的学生,只用两年半,就从64分的瞎蒙选手考到了151分满分。按Lott的统计,从2024年5月到2025年10月,头部AI的智商分数平均每个月狂涨2.5分。整个20世纪,随着营养和教育改善,人类的智商测验分数大约每十年才涨3分,这就是有名的弗林效应。这么一比,人类要花30多年才爬完的10分,AI只要4个月就涨完了。涨得这么快,任何正常人的第一反应都是,它是不是偷偷把答案背下来了?毕竟门萨挪威测试在网上挂了很多年,题目和答案早被网友扒了个干净。连TrackingAI自己都把35道题的文字版连同正确答案一起公开了,所以AI训练时大概率刷过。TrackingAI公开的门萨挪威题文字版,右侧一栏就是正确答案为了排除这种可能,2024年5月,他专门找了一位门萨会员从零出了一套新题。这套题只找读者试做过一轮用来定分数标准,从没在互联网上露过面,任何AI的训练数据里都不可能有。换卷之后,刷题效应确实露了出来。直到今天,有的模型一换到这张保密卷就原形毕露,比公开卷掉了二十来分。保密卷只有16道题,能打出的最高分大约是136,OpenAI的GPT-5.6 Terra看图版已经杀到135。Fable 5.1和Astra也都有130分,旁边还并肩站着一个国产模型。保密卷的成绩分布,这张卷从没上过网,竖线是它的满分线去年10月,Lott还胸有成竹地立过flag,估计AI至少要再等两年,才能在这张卷子的看图版上拿满分,说好2027年万圣节回来验收。结果不到一年,GPT-5.6 Terra就一脚油门冲到了线前,比他的预测早了一年多。既然背答案解释不通,剩下的结论就只有一个,两年半前还在瞎蒙的AI,是真的长脑子了。所以TrackingAI在满分线旁边标的才是「最高可能分(暂时)」。Lott去年底就盘算着,今年要给130分以上的区间补一批更难的题,好把高分段的AI重新拉开差距。「Keras之父」François Chollet设计了一套专门为难AI的推理测试ARC-AGI。他前不久还放话,如果把智能定义成把经验转化为能力的效率,也就是见同样多的例子谁学得更快,现在的AI大约还落后人类6个数量级,差了一百万倍左右。偏偏Chollet自己给AGI划的终点线,也落在出题上。今年2月他透露,ARC-4正在憋大招,明年初发,后面还要出到第6、第7代。用他自己的话说,关键是一直出新题,直到再也提不出人类能做、AI却做不到的题为止。这个月初有人再问他,2030年的判断还作不作数,他改口说会更早,因为进展比他预想的快。有人问Chollet,2030年实现AGI的判断还算不算数智商测试诞生于1905年。120年来,从学校分班到军队挑人,人类一直心安理得地用这把尺子给同类排座次。这把尺子背后藏着一个人类几乎从没怀疑过的前提,被测量的只会是人,能站上最高刻度的也只能是人。如今尺子还在,前提却已经塌了。一个压根不是人的东西,顺着刻度从头爬到了尾,最顶端的那根线也没能拦住它。Lott还可以出更刁钻的卷子,Chollet也能接着掏出下一代ARC。可照着AI两年半从瞎蒙到满分的速度,人类的大脑里还能榨出多少道AI解不出的题,已经没人敢打包票。等到人类题库彻底枯竭的那一天,我们要重新思考的就不只是AI到底有多聪明,还有剥掉「聪明」这层外壳之后,人类自己究竟还剩下些什么。参考资料:
https://x.com/aisafetymemes/status/2103369359481852116
编辑:摩西
关于科技区角:国内科技展会垂直内容策划服务商,提供从论坛内容全案策划、会展市场化IP打造到精准专业观众一站式邀约服务,以产业内容吸引高质量B端人群,打通展会从议题设计、演讲嘉宾邀约、宣传预热、精准邀观到供需对接全链路。