点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
一、开放词汇3D场景理解的“三座大山”:慢、重、糊
开放词汇3D场景理解让用户可以通过自然语言在复杂3D环境中分割任意物体,无需预定义类别。这种灵活性对于机器人操作、3D场景编辑和AR/VR等真实应用至关重要。当前主流方案遵循一条固定的技术路线:用SAM提取2D物体掩码,用CLIP提取语义嵌入,然后通过渲染引导的迭代特征优化、对比学习和特征量化,将2D语义蒸馏到3D场景中。
但这条路线有三个绕不开的问题。
第一是优化瓶颈。反复的渲染和CLIP对齐让特征蒸馏成为整个流程中最慢的一环。LangSplat需要40分钟完成特征蒸馏,LEGaussians需要50分钟,OpenGaussian需要30分钟,即使是最快的LUDVIG也需要4分钟。这种时间开销在需要快速迭代或实时响应的场景中是不可接受的。
第二是内存负载。每个3D高斯都存储高维语言特征。以CLIP的512维特征为例,论文原文指出每个高斯需要存储2028字节。10万个高斯就要占用约200MB——而标准高斯的全部参数(位置、颜色、不透明度、旋转、缩放、球谐系数)加起来才23.6MB。语义特征的内存占用是几何参数本身的近10倍,这严重限制了可处理的场景规模。
第三是2D到3D的语义漂移。基于渲染的方法在2D上做分割,当高斯在渲染过程中混合时,语义变得模糊,模型无法在3D空间直接定位物体。LangSplat和LEGaussians在渲染后将3D高斯投影到2D再蒸馏特征,重叠的高斯模糊了特征,导致高质量2D特征难以有效迁移到3D。2D评估也只能提供模型3D理解能力的一个局部视角。
论文的核心洞察是:跳过昂贵的优化,用离散索引直接把2D语义链接到3D结构。这一思路的转变带来了三个数量级的效率提升。

LightSplat实现了50倍更快的特征蒸馏、更高的精度和64倍更低的内存占用。
二、2字节索引:把“每本书的完整内容贴在书脊上”变成“只贴一个索书号”
LightSplat最激进的设计是给每个高斯只分配一个2字节的掩码索引,而不是存储完整的语言特征。这个索引通过一个轻量级的索引-特征映射表关联到对应的CLIP特征。
打个比方:传统方法相当于把每本书的完整内容都印在书脊上,方便你一眼找到,但书架会变得极其庞大。LightSplat的做法是只给每本书贴一个索书号,真正的语义信息放在一个独立的索引表里,查询时通过索书号去表里取。内存占用从每个高斯2028字节直降到2字节,压缩了约三个数量级。
但这个设计的意义远不止省内存。索引-特征映射是整个管线的核心枢纽:它解耦了特征存储与3D表示,让推理时可以在簇级别做语义比较,而不是逐高斯或逐像素比较。论文报告,推理复杂度从比较超过10万个高斯降低到约100个簇,相似度计算量降到不到0.1%——这意味着在ScanNet场景中,平均推理时间从LUDVIG的6毫秒降至仅2毫秒。
索引-特征映射包含两个层级。掩码-特征映射将每个2字节掩码索引映射到其对应的CLIP特征,让每个高斯只存储索引而非高维语言特征。簇-特征映射在聚类阶段将相关的掩码-特征映射合并为紧凑的簇-特征映射,通过单步操作将多视图中的相关掩码分组。这两个映射共同构成了完整的索引-特征映射。
索引式特征注入:只给“有贡献”的高斯贴标签
不是所有高斯都值得被赋予语义。LightSplat计算每个高斯对渲染图像的像素级贡献——使用3DGS渲染方程中的alpha-blending权重:
其中 是第 个高斯的不透明度, 是透射率,量化光线到达该高斯前被遮挡的程度。透射率通过累加同一光线上所有前序高斯的遮挡效应计算:
只有贡献度超过阈值 的高斯才会被赋予掩码索引。这种方式避免了top-k选择可能纳入视觉影响可忽略的高斯的问题。论文在补充材料中给出了具体的时间分配:在整个特征蒸馏流程中,渲染占36.5%,索引式特征注入占53.7%,3D感知掩码过滤占3.8%,上下文感知3D聚类占6.0%。绝大部分计算集中在渲染和注入上,这两步对每个视图都是必需的,而后两步仅在单步中操作,几乎不增加额外开销。
3D感知掩码过滤:让语义在3D空间“站得住脚”
2D掩码在3D空间中的几何支撑可能很弱——一个在单张图像中出现的掩码,如果只关联到少量高斯,它的3D语义一致性就不可靠。LightSplat通过一个简单的过滤规则解决这个问题:
只有当掩码关联的高斯数量超过阈值 时,该掩码才会被保留。这一步抑制了视角相关的伪影,增强了多视图语义一致性。消融实验显示,去掉3D感知掩码过滤后,mIoU从47.58骤降到29.31——噪声掩码破坏了聚类质量,干扰了2D-3D对齐。
三、单步3D聚类:不做迭代优化,只做一次图连通
有了掩码索引之后,LightSplat构建一个无向图 ,每个节点代表一个过滤后的2D掩码,边表示掩码之间的连接关系。初始时每个节点只有自环边,即每个掩码自成一个簇:
边的建立依赖于两个条件的同时满足。几何重叠通过两个掩码关联的高斯集合的IoU衡量:
语义相似通过两个掩码的CLIP特征余弦相似度衡量:
两个掩码被连接当且仅当几何重叠超过阈值 且语义相似度超过阈值 。每个连通分量就是一个物体级簇。
簇级语义特征通过直接平均所有关联掩码的CLIP特征获得——这是一个单步操作,因为掩码-特征映射已经建立,聚类在掩码级别进行,簇-特征映射可以立即构建。
这个设计的精妙之处在于:几何和语义的联合约束让聚类同时具备空间一致性和概念一致性。消融实验有力地证明了这一点:去掉语义感知聚类,mIoU降至19.56,因为模型无法识别跨视图的语义对应掩码;去掉几何感知聚类,mIoU暴跌到2.01,因为模型完全忽略3D空间中的掩码重叠,无法利用2D-3D对应关系。
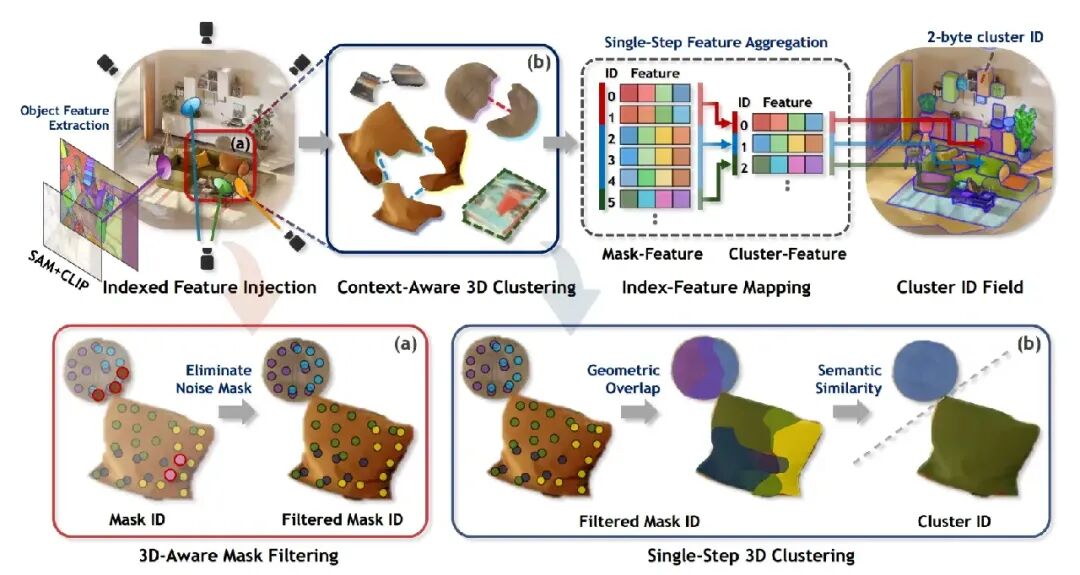
从多视图图像中获取SAM掩码和对应的CLIP特征,通过索引式特征注入将其对齐到3D场景,基于投影影响为每个高斯分配紧凑的2字节掩码索引。(a) 为确保语义一致性,执行3D感知掩码过滤;(b) 通过基于几何和语义关系的索引-特征映射构建掩码间图,引导单步上下文感知3D聚类。

四、实验结果:从LERF-OVS到ScanNet的全面领先
LightSplat在三个基准上进行了评估:LERF-OVS(多视图图像+文本查询-2D掩码标注)、ScanNet(1500个室内场景的RGB-D数据集)和DL3DV-OVS(论文提出的开放词汇扩展,覆盖公园、道路、商店、办公室四个大型室内外场景)。
评估涵盖两个标准任务。3D物体选择的目标是根据开放词汇用户查询分割3D物体,在LERF-OVS和DL3DV-OVS上使用mIoU和mAcc@0.25评估渲染结果与真值掩码。3D语义分割为每个3D高斯从开放词汇文本输入池中分类最相关的语义标签,在ScanNet上直接评估3D分割性能,报告19类、15类和10类设置下的mIoU和mAcc。
对比方法包括LangSplat、LEGaussians、OpenGaussian、Dr.Splat和LUDVIG。由于Dr.Splat不提供推理代码,论文采用其论文中报告的推理结果,其余结果均自行测量。所有模型在单张RTX 4090 GPU上评估,LUDVIG是唯一例外,运行在A6000上,因为其高维语言特征操作超出24GB内存限制。
3D物体选择:快50倍,精度更高
在LERF-OVS上,LightSplat在零训练的情况下取得SOTA性能。表1 展示了定量对比。LightSplat在四个场景(Waldo、Ramen、Figurines、Teatime)上的平均mIoU为47.58,mAcc@0.25为68.32,比前SOTA平均高出4个mIoU和4.45个mAcc@0.25。特征蒸馏时间仅4.55秒,而LangSplat需要40分钟,LEGaussians需要50分钟,OpenGaussian需要30分钟,LUDVIG需要4分钟。在Ramen场景中——包含鸡蛋、筷子等小型复杂物体——LightSplat的mIoU达到45.07,远超其他方法。

在DL3DV-OVS上,LightSplat同样表现出色。表2 显示,在公园场景中mIoU达到69.78,而LUDVIG为37.03,OpenGaussian为29.65。在办公室场景中,面对重复的椅子、显示器等物体,LightSplat的mIoU为43.13,而LUDVIG为18.58。整体均值44.98,远超LUDVIG的29.21。相比LUDVIG,LightSplat实现了15.77更高的mIoU、3.93更高的mAcc@0.25,以及150倍更快的特征蒸馏。


LangSplat和LEGaussians等基于渲染的方法在开放词汇场景中难以产生干净的分割,因为高斯在2D渲染混合时语义变得模糊。OpenGaussian虽然关联了3D空间中的语言特征,但缺乏语义引导的聚类导致高斯分组不准确、物体边界不一致。LightSplat即使对小型复杂物体(如鸡蛋、玻璃杯中的茶)也能产生干净的分割。

LightSplat在大型室内外场景中保持清晰边界,能处理多个相似物体(椅子、显示器)、远处的户外物体(汽车)以及大型室内区域(白色沙发)。
3D语义分割:19类配置下领先7.68个mIoU
表3 展示了ScanNet上的3D语义分割结果。在最难的19类配置下,LightSplat的mIoU为37.11,mAcc为58.66,超越前SOTA 7.68个mIoU和14.06个mAcc。在15类配置下mIoU为39.78,mAcc为60.91;在10类配置下mIoU为47.78,mAcc为68.21。推理时间仅2毫秒,特征蒸馏4.1秒,每个高斯的语义存储仅2字节——而LUDVIG需要2048字节,OpenGaussian需要324字节,LangSplat需要36字节。


基于渲染的方法只能识别少数物体类别,OpenGaussian和LUDVIG能更好地区分物体区域但仍存在模糊边界和误标。LightSplat在物体级类别(门、柜子)和大面积语义(地板、墙壁)上都表现出色。
推理速度:毫秒级
表S2 展示了LERF-OVS和DL3DV-OVS上的推理时间。LightSplat在LERF-OVS上仅需0.001秒,在DL3DV-OVS上仅需0.003秒,而LangSplat分别为1.046秒和0.175秒,LUDVIG分别为5.923秒和1.865秒。论文报告使用预计算的簇特征,文本查询检索可达500 FPS。

推理速度的优势来源很明确:LangSplat需要通过自编码器做逐高斯潜在解码,LEGaussians通过MLP做逐像素语义解码,OpenGaussian需要为每个高斯计算高维特征,LUDVIG需要在图上扩散2048维特征。LightSplat通过索引-特征映射做簇级推理,避免了逐高斯比较和扩散。
消融实验:每个组件都不可或缺
表4的消融实验揭示了各组件的重要性:完整方法mIoU为47.58,去掉3D掩码过滤降至29.31,去掉语义感知降至19.56,去掉几何感知暴跌至2.01。值得注意的是,特征蒸馏时间在所有变体中都保持在4.4-4.5秒左右,差异仅约0.1秒——这说明大部分计算量集中在评估高斯对2D掩码的贡献上,这是本质上必需的,而后续步骤的额外开销可忽略不计。
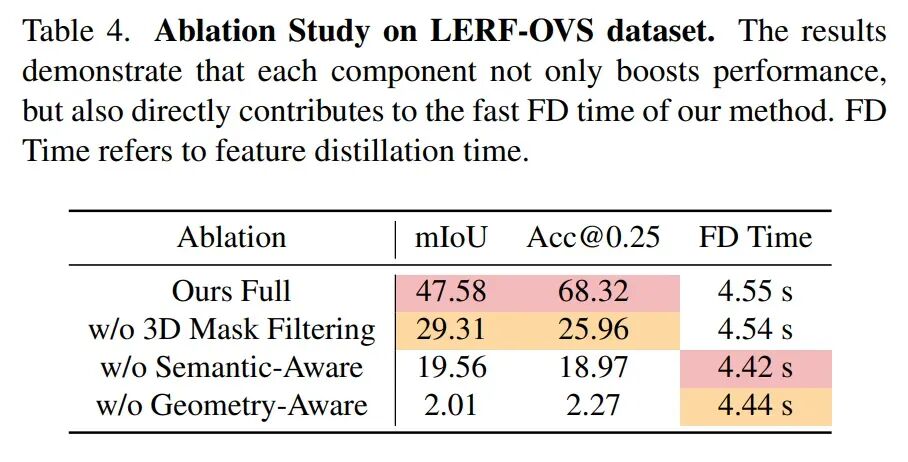
这一结果直接验证了论文的核心设计哲学:快速的部分来自索引式注入本身,而准确的提升来自过滤和聚类的联合约束,两者不冲突。
五、DL3DV-OVS:为复杂室内外场景打造的开放词汇基准
论文提出了DL3DV-OVS,这是DL3DV-10K的开放词汇扩展,用于评估模型在大规模复杂场景中的鲁棒性。数据集覆盖室内外环境,具有广阔的空间布局和多样的场景结构,提供22个文本查询,涵盖汽车、椅子、显示器、路灯等物体。这些物品在尺寸和距离上差异显著,经常在同一视图中多次出现。
表S1 列出了每个场景的文本查询。公园场景包括长椅、停车标志、垃圾桶、信息板、汽车;商店场景包括黑色抽屉、盆栽、灭火器、相框、白色沙发、圆形木制咖啡桌、台灯、床;道路场景包括长椅、花盆、路灯、车顶、消防栓、垃圾桶;办公室场景包括椅子、白板、键盘、鼠标、显示器。

DL3DV-OVS包含四个场景(公园、道路、办公室、商店),每个场景提供960×540多视图图像、文本查询和对应的真值2D掩码。

SAM掩码ID被提升到3D并精炼为连贯的物体级簇,产生最终的簇ID场。该方法在不同室内外场景中无需场景特定调优即可产生干净的簇ID场。
六、从代码到实验:快速上手LightSplat
项目主页https://vision3d-lab.github.io/lightSplat/含论文摘要、方法概览、核心贡献和基准测试结果。GitHub仓库提供了完整的复现代码,涵盖3D物体选择、3D语义分割和文本驱动的3D场景编辑三个任务。
环境配置方面,需要准备CUDA环境并安装PyTorch、3DGS渲染器、SAM和OpenCLIP等依赖。数据准备支持LERF-OVS、ScanNet和DL3DV-OVS三个基准。
3DGS设置方面,论文使用预训练的3DGS模型,训练30000次迭代,与LangSplat和OpenGaussian相同。不修改任何高斯参数,仅额外分配2字节空间存储索引。一个完整的语言特征每个高斯需要2028字节,10万个高斯需要约200MB,远大于标准高斯参数所需的23.6MB。LightSplat不再为每个高斯存储这个2028字节的特征,而是只存储一个小索引,总索引大小仅0.2MB,不到逐高斯语言特征所需200MB的0.1%。
物体特征提取方面,LangSplat使用SAM生成的全部三个层次掩码并为每个层次学习单独的语言特征。为确保公平比较和计算效率,论文遵循OpenGaussian的做法,采用大掩码策略。通过裁剪每个SAM掩码、调整到224×224并零填充,然后使用OpenCLIP编码,提取掩码级CLIP特征。
超参数设置方面,论文对所有场景使用相同超参数。更密集的视图或更紧凑的场景产生更高的掩码重叠,因此需要更严格的IoU阈值;文本查询更多样的数据集需要稍微放宽的特征相似度阈值。对于LERF-OVS、ScanNet和DL3DV-OVS,四元组 (contrib, noise, IoU, feat) 分别设置为 (0.04, 200, 0.6, 0.75)、(0.04, 500, 0.35, 0.8) 和 (0.09, 450, 0.5, 0.8)。
推理流程遵循四个步骤:首先从多视图图像中用SAM提取物体掩码、用CLIP提取语义特征;然后基于高斯贡献度注入2字节掩码索引;接着执行3D感知掩码过滤;最后进行上下文感知3D聚类,形成物体级簇。整个过程无需迭代训练,特征蒸馏在约5秒内完成。
七、文本驱动的3D场景编辑:簇级语义控制的自然延伸

上图展示了基于簇级语义控制的3D场景编辑能力。通过管理簇级语义,LightSplat可以快速准确地分割文本指定的3D物体。基于这一分割能力,用户可以直接删除、重新着色或重新定位识别出的物体,实现高保真场景编辑。论文展示了重新着色和放大两个代表性示例——放大通过调整高斯距离和缩放实现,重新着色通过修改球谐系数实现。编辑操作的开销极小,交互场景中推理时间几乎不变。
这些结果展示了该方法在沉浸式内容创作、AR/VR和机器人领域的交互式3D操作潜力。
八、局限与未来方向
论文在补充材料中坦诚地讨论了当前方法的局限。物体特征选择方面,SAM提供高质量的物体分割掩码,CLIP作为大规模数据集上训练的共享嵌入空间基础模型支持有效的图像-文本交互。但SAM掩码并不总能产生完美的边界,CLIP在区分语义相似的物体(如红苹果和绿苹果)时可能因特征相似度过高而力不从心。这些限制可以通过额外模块或迭代训练缓解,但会破坏方法的速度-精度平衡。
超参数方面,该方法仅使用四个主要超参数在单步中完成语义注入和3D聚类,相比基于训练的方法涉及的众多模型初始化和优化超参数,所需参数少得多,避免了高训练成本和内存使用。尽管如此,方法仍可能受超参数选择影响,可以进一步优化。
论文的结论是:通过直接向3D高斯注入基于影响的紧凑2字节掩码索引,并通过索引-特征映射管理语义,消除了迭代优化和高维逐高斯存储的需求。上下文感知聚类利用几何和语义线索从逐掩码特征形成簇级语义,实现快速可解释的推理。大量实验证明,LightSplat以50-400倍更快的特征蒸馏和64倍更低的内存使用实现了SOTA性能,为实时3D应用提供了可扩展的实用基础。
写在最后
LightSplat的核心贡献不在于提出更复杂的网络架构,而在于用最轻量的表示重新思考了开放词汇3D场景理解的语义存储方式。2字节索引替代2028字节语言特征,单步聚类替代迭代优化,簇级推理替代逐高斯比较——每一个设计选择都在追求同一个目标:让开放词汇3D理解从“实验室可行”走向“部署可用”。
论文最值得关注的数字是5秒和64倍。5秒的特征蒸馏时间意味着用户完成3D重建后,几乎可以立即用自然语言搜索和编辑场景中的物体;64倍的内存压缩意味着同样的GPU可以处理更大的场景或服务更多的并发查询。对于机器人、AR/VR和数字孪生等对延迟和内存极其敏感的应用场景,这两个数字直接决定了技术能否落地。
当前方法的局限在于对SAM和CLIP的依赖以及超参数需要针对数据集调整。但论文的设计哲学提供了一个清晰的改进方向:在保持索引式表示和单步聚类核心思想的前提下,通过更精确的掩码生成或更鲁棒的语义编码来提升质量,而不必回到昂贵的迭代优化路线。
代码和项目主页已公开,项目主页地址:https://vision3d-lab.github.io/lightSplat/,研究者和工程师可以快速复现论文中的全部实验,并在此基础上探索更广泛的3D场景理解应用。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。



