小引:
据我了解,目前国内很多大学是没有开设FPGA相关课程的,所以很多同学都是自学,但是自学需要一定的目标和项目,今天我们就去看看常春藤盟校Cornell University 康奈尔大学开设的FPGA项目课程,大部分课程是有源码的,而且和国内使用习惯类似都是Verilog开发,还是很有借鉴意义的。
项目链接
https://people.ece.cornell.edu/land/courses/ece5760/FinalProjects/
项目介绍
2024年春季 开发板:CycloneV DE1-SoC
线框世界和康威生命游戏

概述
在DE1-SoC FPGA上实现Wireworld和康威生命游戏。Wireworld和康威生命游戏都是元胞自动机(https://en.wikipedia.org/wiki/Cellular_automaton#:~:text=A%20cellular%20automaton%20(pl.,tessellation%20structures%2C%20and%20iterative%20arrays.),这意味着它们的“世界”由一个单元格网格构成,这些单元格的状态会根据自身及其相邻单元格的当前状态不断更新。用户可以通过PS/2鼠标直接与FPGA交互来修改状态(点击想要修改状态的单元格)。此外,我们还开发了一个命令行工具,该工具允许用户根据自动机的规则更新整个系统的状态,并将整个状态保存到文件中,或加载之前保存的状态。
背景
Wireworld
Wireworld(https://en.wikipedia.org/wiki/Wireworld)是一个元胞自动机,它通过规则模拟电子流动。为此,它定义了元胞可以具有四种状态:

每次更新时,单元格将根据自身及其邻居的当前状态来更新其状态:

空位更新为空位,头位更新为尾位,尾位更新为指挥位,如果一个或两个邻居是头位,则指挥位更新为头位(否则保持指挥位)。
根据这些规则,“电子”(首尾对)沿着导线路径朝头部方向流动。此外,所有基本的数字逻辑模块(与门、非门、或门等)都可以使用 Wireworld 的规则构建,这使得元胞自动机成为图灵完备的(https://en.wikipedia.org/wiki/Turing_completeness)。
下图是一个时钟发生器的示例,它持续产生电子脉冲并向右发送。这是 Wireworld 中的一个基本构建模块,有助于直观地理解电子为什么会沿着导体路径运动。

康威生命游戏
本项目中实现的第二个元胞自动机是康威生命游戏。该元胞自动机与 Wireworld 非常相似;它定义了两个状态,而不是四个状态:

注意颜色上的相似性;状态在自动机之间重复使用,根据使用的自动机规则,具有不同的语义。
与 Wireworld 类似,康威生命游戏也提供了根据单元格及其邻居的当前状态来更新状态的规则:

如果恰好有 3 个邻居存活,则死亡状态变为存活状态。如果邻居存活的数量少于 2 个或多于 3 个,则存活状态变为死亡状态。
在最初实现 Wireworld 时,设计以一个 RTL 模块为中心,该模块会根据单元格及其邻居的当前状态计算下一个状态。由于 Wireworld 和康威生命游戏的自动机具有相似性,可以让更新规则在两者之间动态切换,从而在相对较少的更改下实现更多功能(因为模拟和查看自动机的其他基础设施已经存在)。
此外,由于 Wireworld 比康威生命游戏多两种状态,因此从 Wireworld 切换到康威生命游戏时,电子头和电子尾会先切换到“存活”状态,然后才会成为康威生命游戏中的角色。
高级硬件/RTL设计
节点
结构中最基本的模块是节点。该模块实现了自动机的逻辑;它接收单元格的当前状态以及该单元格邻居的当前状态,并计算该单元格的下一个状态应该是什么:

最初实现此功能时仅考虑状态操作;然而,随着康威生命游戏功能的加入,添加了另一个输入wireworld_or_conway,用于确定更新逻辑应遵循哪个自动机。该输入连接到 FPGA 上的一个开关,使用户能够轻松地在不同的自动机之间切换。
迭代器
有了节点之后,就可以将其实例化到迭代器中。迭代器负责遍历整行状态,并在遍历过程中为单元格提供新的状态:

在这里,可以看到迭代器会将读取到的状态进行流水线式处理,以便将当前单元格 及其邻居的状态传递给节点;迭代器始终会读取当前单元格两步之后的状态,从而计算出下一个状态。这样做的一个额外好处是,当我们把新状态写回内存时,它已经被读入迭代器,从而保证我们不会读到刚刚计算出来的新状态。
列数据路径
每个迭代器负责遍历状态的一行。为了更新整个状态,我们需要一 列这样的迭代器,每个迭代器负责一行。下图所示;各列迭代器从同一地址 ( raddr ) 获取数据 ( rvals ) ,确保状态同步更新,并允许使用写使能信号 ( we ) 将新状态 ( wvals ) 写入同一地址 ( waddr ) 。这里,地址对应于特定的列,列中每一行的值都是并行读取的。

这里需要控制逻辑来确定正确的读写地址,尤其要注意的是,当到达网格的开头或结尾时, 需要额外输入空值,以避免回绕。我们使用有限状态机(FSM)来实现此控制逻辑,该状态机具有初始化(INIT)状态来输入这些额外的空值,并更新一个计数器来跟踪我们应该从哪里读取数据以及应该写入数据。

值得注意的是,我们分配的比特位比寻址整行所需的比特位多一位,以便迭代器在超出行长度时能够接收空值。每当raddr = ROW_LEN时,都会向迭代器管道注入一个空值,以确保自动机 能够将行的末尾(以及下一行的开头)解释为空值。
图中未显示:启动信号来自HPS。当HPS需要求解器更新时,它会将此寄存器设置为要执行的更新次数。求解器在INIT0阶段检查此寄存器,仅当其为高电平时才继续执行(并在进入INIT1阶段时减1 )。最后,从寄存器发送给求解器的启动信号仅在水平消隐状态开始时为高电平,如下所述。这确保我们仅在水平消隐开始时启动更新;由于此状态需要 45行 * 800像素/行 = 36000个周期,因此这确保了在水平消隐结束(以及失去写入能力)之前,整个状态都可以更新。
鼠标界面
为了与我们的设计进行交互,使用了一个 PS2 鼠标,从而可以直接通过 FPGA 控制它。为此,使用了一个外部 IP(https://class.ece.uw.edu/271/hauck2/de1/index.html)来与 PS2 协议进行接口,从而获取鼠标的当前位置以及鼠标点击的时间:

我们与鼠标进行的主要交互是更新内存。为此,使用写缓冲区,当鼠标点击时,它会将当前位置转换为内存写入操作(包括地址、值以及基于写入列中哪一行的写使能)。这样,缓冲区就负责将给定的坐标转换为我们要写入的单元格。

之所以称之为“缓冲区”,是因为还有一些底层信号会导致鼠标写入操作进入缓冲状态;具体来说,当我们收到点击事件时,我们会等待读取到相应的位置,以便确定下一个状态(鼠标点击会遍历所有可能的单元格状态)。然而,鼠标并不一定控制这些信号,而是监听已读取的内容,因此为了简洁起见,我们省略了这些信号。
VGA接口
除了 PS2 鼠标之外,设计中需要交互的另一个外部硬件是 VGA 显示器。为了实现这种交互,能够重用 Adams 教授在实验 2 中使用的 VGA 驱动程序;由于我们已经了解了该 IP 的工作原理,因此能够将其顺利集成到我们的项目中(尽管为了支持完整的 24 位色彩,我们对其进行了修改)。

为了将此驱动程序完全集成到我们的设计中,需要一个VGA 映射器。该模块负责将 VGA 请求的坐标映射到我们内存中的单元格,类似于鼠标写入缓冲区。此外,它还会检测我们是否接近单元格的“边缘”,如果接近,则始终显示灰色(同样,如果请求的单元格无效,则始终显示紫色,无效单元格由我们单元格网格的参数化大小决定)。

坐标映射
通常情况下,可以将鼠标接口直接连接到写入缓冲区;类似地,可以将 VGA 驱动程序连接到映射器。然而,在我们的设计中,我们希望实现缩放和平移功能。这就需要一个中间模块,将初始输入坐标转换为反映已发生缩放或平移的“映射”坐标。
在我们的设计中,缩放是通过两个FPGA按钮实现的。平移则是在按住鼠标右键并移动鼠标的同时进行的,这样用户就可以拖动鼠标在单元格网格上移动。我们的坐标映射器模块将这些数据作为输入,以跟踪当前的缩放和平移量。然后,它可以将输入的VGA坐标和鼠标坐标转换为映射后的坐标,以反映用户进行的缩放和平移操作。这些映射后的坐标将被送入鼠标写入缓冲区和VGA映射器,以便它们能够基于所需的映射坐标进行操作。

HPS接口
自动机状态的最后一个接口是与硬处理器系统 (HPS) 的接口。在这里,希望允许用户代码也能读取和写入状态。这是通过 PIO(其协议在用户程序中描述)实现的。HPS 接口负责将来自这些 PIO 的信号转换为对内存的读写操作,使用的地址-值组合与其他模块类似。值得注意的是,HPS 操作的是绝对单元值,而不是屏幕坐标,因此无需进行任何转换。

简而言之,当HPS接口在请求PIO上收到请求时,它会执行该操作,并在操作完成后更新resp_row和resp_col以匹配req_row和req_col ,表明HPS可以继续执行下一步操作。更多详细信息请参见“程序”页面。
记忆组织
设计的一个重要组成部分是如何存储自动机的状态;我们使用 M10K 模块来实现这一点。每个单元格需要 2 位来表示 4 种状态之一,这意味着使用 M10K 的容量,可以存储多达 390 * 4K = ~150 万个单元格的状态(尽管在最终实现中,将单元格数量限制在1000x1000 的网格上)。
最初,将每个迭代器分配给一个单独的 M10K 块;然而,这限制了我们的纵横比,因为我们只能有 390 个迭代器,因此网格中也只能有 390 行。为了实现想要的1000x1000网格,将 8 个迭代器映射到 1 个 M10K 块。为此,在 M10K 块之前设置了一个写缓冲区:
如果给定列的全部 8 个条目都被写入(例如迭代器运行时),则写入操作会被记录,然后在下一个周期立即写回,从而在写入操作之前加入一个流水线阶段。由于我们从不在写入某个位置后立即读取,因此这仍然能够保证完整的吞吐量。 如果给定列中只写入一个条目(例如鼠标点击或 HPS 写入),则该值会被记录。稍后,系统会读取相应的条目,用新值更新,然后写回。这样做是为了避免数据丢失;如果我们只写入一个条目,我们就不知道其他 7 个条目的值应该是什么,因此必须读取它们的当前值才能知道需要写回哪些数据。
这是通过内存封装实现的,每个 M10K 块都被封装在其中。请注意,读取的值可以选择注册为接下来要写入的值。此外,我们还会跟踪写入地址,并在需要剩余数据时,可以选择将其用作读取地址。

系统组成
构建该系统的主要难点在于组织内存访问模式。有很多元素都需要读取和写入状态:
读取:求解器、VGA、HPS、内存封装器 写入:求解器、HPS、鼠标、内存包装器
为了实现这一点,利用了不同的 VGA 状态。当 VGA 图像在屏幕上循环显示时,协议要求在每一行的末尾(垂直消隐)以及屏幕末尾后的几行(水平消隐)设置一个“消隐”区域,在此期间不会向 VGA 发送任何数据:

在这些状态下,会定义哪些模块可以进行读写操作(主要限制是VGA在激活状态下能够读取数据)。模块必须知道VGA驱动程序所处的状态,并且不能假设如果它们不在可读写的状态下,其读写操作仍然正确。
活动区
读取: VGA驱动程序 写入: HPS接口(启用时),否则为鼠标接口
这样一来,用户在 HPS 写入数据时就无法使用鼠标;由于 HPS 的写入操作频率很低,我们认为这没问题。
垂直落料
读取:内存包装器(使用存储的写入地址) 写入:内存包装器(使用存储的写入地址)
在这里,通过读取当前状态、添加要写入的任何值,并将 8 行的完整值写入,来清除任何部分写入。
水平落料
读取: HPS 接口(激活时),否则读取(自动机)求解器。 写入:(自动机)求解器
这样一来,自动机在HPS更新期间就不会更新。这是可取的;否则,在HPS写入状态的过程中,求解器可能只会更新当前已写入状态的那部分,这意味着只有我们设计的一部分会被更新。
基于此,我们可以构建整个系统,其中 VGA、求解器、鼠标和 HPS 都能够访问内存中的状态:
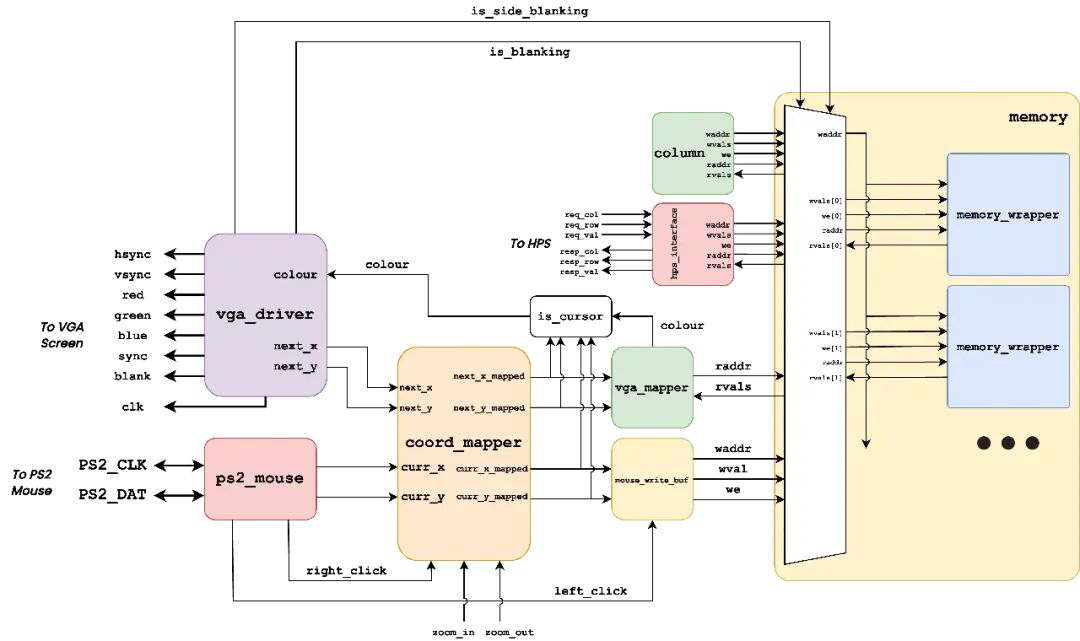
这其中包括一些之前未讨论过的高层逻辑:
内存块中的多路复用器根据is_blanking和is_side_blanking指示的 VGA 状态,按照上述规则,控制哪些模块可以进行读写操作。每个连接模块的控制逻辑也以这些信号作为输入(图中未显示),以确定何时可以进行有效的读写操作。
is_cursor代码块是一个底层逻辑,它检查当前查看的坐标是否与光标坐标对应或接近;如果对应,则显示不同的颜色来指示光标(否则,直接从内存读取颜色)。这样,我们就可以在状态之上显示光标,从而向用户指示鼠标的位置。zoom_in和zoom_out分别连接到 FPGA 上的按钮 2 和 3。
图中未显示“缩放”模块;该模块跟踪我们当前的缩放量(通过按钮按下增加或减少),可以将其视为图中坐标映射器的一部分。
还有一些其他控制信号没有显示,但这些信号对于方便用户使用至关重要:
求解器节点的wireworld_or_conway信号连接到 FPGA 上的开关 0。
mouse_write_buf模块有一个来自开关 1 的额外输入,用于确定单击时是切换状态还是擦除状态(如果用户想要一次擦除多个块,擦除会更有用)
HPS项目设计
在这个项目中,希望尽可能多地将工作(尤其是鼠标接口)保留在FPGA上,仅在必要时才使用HPS。项目完成后,确定了HPS应该处理的三件事:
从文件中加载状态 将状态保存到文件 通知求解器更新
前两项对于最终想要设计的项目(一个能够加载和保存 Wireworld 设计的项目)至关重要。虽然第三项可以通过 DE1-SoC 上的各种开关来实现,但小组认为通过终端指定更新速率更简单、更清晰。
为了实现这三个功能,在连接 ARM HPS 和 FPGA 的系统中增加了 9 个 PIO 端口:
来自FPGA并进入HPS的参数
resp_col
响应行
响应值
来自 HPS 并输入到 FPGA 的元素
req_col
请求行
请求值
hps_init:位 0 表示 HPS 是否处于活动状态,位 1 表示我们正在读取 (0) 还是写入 (1)
循环值
循环时钟
这些PIO可用于实现上述目标:
将值加载到内存状态
将req_val设置为您想要写入的值
分别将req_row和req_col设置为要写入的行和列。
将hps_init设置为0x00000003(我们处于活动状态并正在写入)
等待接口中的resp_row和resp_col与req_row和req_col匹配,表示该值已写入。
HPS 可以遍历文件中的所有值以加载整个状态。
从内存状态存储值
分别将req_row和req_col设置为要读取的行和列。
将hps_init设置为0x00000001(我们处于活动状态并正在读取)
等待接口中的resp_row和resp_col与req_row和req_col匹配,表示该值已被读取。
读取resp_val中给出的值,并将其存储在所需位置。
HPS 可以遍历网格中的所有值以保存整个状态。
正在更新状态
将cycle_val设置为求解器需要进行的更新次数。
将cycle_clk置高,然后再置低,以将更新值翻转到 FPGA 中的相关寄存器中(这将决定求解器的执行值)。
HPS 可以周期性地执行此操作,值为 1,以可变频率持续更新状态。
尽管HPS现在能够正确访问FPGA内存,但如何格式化这些数据仍然是一个问题。为了确定正确的数据格式化方法,参考了Wireworld处理器(https://www.quinapalus.com/wires11.html)。为了便于重复使用他们的文件,采用了相同的格式方案:状态存储在扩展名为.wi的文本文件中 ,该文件使用一个特殊字符来表示四种可能的状态。根据处理器文件确定的四个字符是:
“ ”用于空 “ “@”代表HEAD “~”代表尾部
通过这种格式化方案,可以轻松地将resp_val中的数据转换 为要存储在文件中的所需字符,以及将字符转换为要放入req_val中进行写入的状态值。
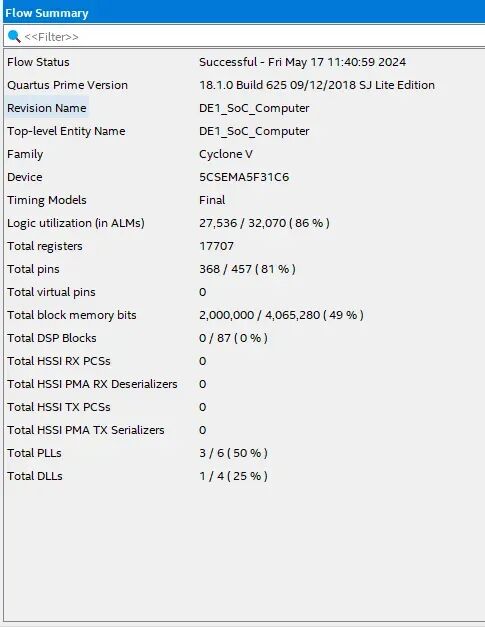
结果
该项目主要以可视化为主;整个项目的核心在于观察单元格的更新。以下几张图片展示了用户在 Wireworld 中可以执行的一些操作,直观地体现了项目的成功之处。


使用的外部 IP
PS2 接口取自华盛顿大学的 EE 271 课程,该课程本身是 Terasic PS2 鼠标示例的修改版本。
https://class.ece.uw.edu/271/hauck2/de1/index.html
VGA驱动程序由Adams教授为ECE 5760课程编写。该驱动程序与ECE 5760实验2中使用的驱动程序相同,仅做了一些细微修改,例如将其更改为接受24位颜色而不是8位颜色。
https://vanhunteradams.com/DE1/VGA_Driver/Driver.html
Wireworld处理器(包括布局)由 David Moore、Mark Owen、Julien Thevenon 以及 Quinapalus 的其他成员制作。
https://www.quinapalus.com/wi-index.html
项目链接
https://people.ece.cornell.edu/land/courses/ece5760/FinalProjects/s2024/tjf87_acm289/tjf87_acm289/index.html
代码链接
https://people.ece.cornell.edu/land/courses/ece5760/FinalProjects/s2024/tjf87_acm289/tjf87_acm289/appendices.html
视频链接
https://youtu.be/fnFc0lziW4w?si=9K7jmwvqGWCmXfCm
万花筒模拟器
项目介绍
这个项目通过 DE1-SoC 开发板和 FPGA 硬件加速,将传统万花筒的反射与对称效果实时应用到视频输入中,把普通画面转换为动态的几何图案。项目不仅还原了万花筒独特的视觉效果,也将复杂的实时图像处理算法映射到 FPGA 硬件中,展示了 FPGA 在实时视频处理、几何变换和硬件加速方面的能力。

概述
真正的万花筒利用多面镜子相互反射,形成一系列内部反射,最终到达人眼,从而产生重复结构的幻觉。我们基于FPGA开发的万花筒将模拟真实万花筒的物理原理,通过多次连续的内部反射来决定人眼所见的图像。这些反射将由部署在FPGA架构上的万花筒模块进行计算。本项目最终成果是一个万花筒生成器,它利用实时摄像头数据,通过DE1-SoC将万花筒图像输出到VGA屏幕上。
背景数学
定点表示法
本项目中使用的定点表示法是我们计算反射率方法的主要决定因素。采用了 12.15 表示法,这意味着可以表示的最大值是 2047,最小值是 -2047。


上图展示了初始镜面区域以及万花筒计算后的预期输出。我们的万花筒由三面镜组成,形成一个三角形区域。希望反射的图像将位于该三角形区域内。在上面的例子中,期望反射的是红色三角形和绿色三角形的图像。
下面展示了确定每个像素反射率的过程:
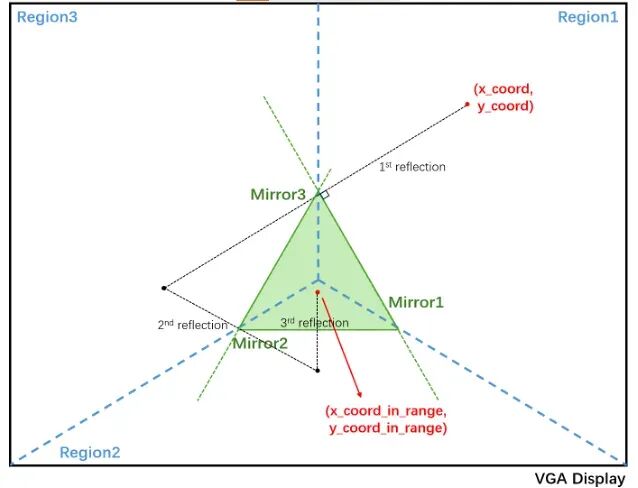
给定一个像素,首先确定该像素所在的区域。该像素所在的区域对应于将要用作对称轴的镜像。在上面的例子中,坐标 (x_coord, y_coord)位于区域 1 内,因此,镜像 1 将用作对称轴。
计算出反射后,检查该点是否位于三角形内。如果该点位于三角形内,则不再进行反射。如上例所示,需要多次反射才能最终使点落在三角形区域内。
一旦反射坐标(x_coord_in_range,y_coord_in_range)位于三角形区域内,就可以确定坐标(x_coord_in_range,y_coord_in_range)处的像素数据应该与坐标(x_coord,y_coord)处的像素数据相同。
完成一个像素的反射后,便开始计算下一个像素。这个过程持续进行,直到到达VGA屏幕的尽头,此时,该过程将从第一个像素坐标重新开始。
计算反思:
利用直线的方程可以很容易地计算出一个点关于直线的反射,因为关于直线的反射是垂直于对称轴的。
万花筒区域最初是用直线方程定义的,形式如下:
y = kx + b
其中 k 和 b 分别为每面镜子对应直线的斜率和 y 轴截距。定义镜子区域的直线也是使用斜截式方程生成的,如上所示。每条直线的原始斜率和 y 轴截距如下表所示:

下面显示的是使用上述斜率和 y 轴截距指定的顶点所确定的默认三角形区域:

如上文定点表示法部分所述,能表示的最大量级为 2047。然而,区域线 3 的 y 轴截距远大于此值。考虑到这些数值还需要相乘,并且会持续增大,因此决定寻找一种新的方法来计算镜像反射。
在镜像边界内检查:
检查一个点是否位于镜像边界内的过程是在计算反射之前进行的。
检查某个点是否存在于三角形边界内时,首先从三角形的一个顶点向该点绘制一个向量,然后计算该向量与三角形镜像边界的一系列叉积。叉积的符号决定了该点是否存在于三角形边界区域内。

参考上图,向量VP由顶点(x2, y2)和采样像素坐标(x_coord, y_coord)绘制而成。然后计算向量VP与 V2的叉积。如果叉积为正,则判定该点不在三角形内。如果叉积为负,则计算向量VP与V1的叉积。如果该叉积为负,则判定该点不在三角形内。如果叉积为正,则绘制一个新的向量,并计算该向量与向量V3的叉积。

如果新绘制的向量VP与向量V3的叉积为正,则判定该点不在三角形内。如果叉积为负,则最终判定该点位于镜像边界区域内。
矢量反射计算:
用向量而不是斜截式来表示镜像边界和区域线,可以避免上面显示的大的 y 轴截距值,并更好地控制我们的计算,以防止定点溢出。

确定区域:
如前所述,给定一个坐标(x_coord, y_coord),首先需要确定该点所在的区域。对于向量,这可以通过叉积运算来实现。根据叉积的符号,可以判断该点位于给定向量的左侧还是右侧。
计算给定坐标的区域时,首先计算区域向量 1 (RV1) 与由坐标(x2, y2)和(x_coord, y_coord)引出的向量的叉积。如果叉积为正,则该点位于区域 2 或区域 3(沿向量RV1逆时针方向)。然后计算RV2与向量 VP 的叉积,以确定该点位于区域 2 还是区域 3。如果RV1与VP的初始叉积为负,则该点位于区域 1 或区域 3(沿向量RV1顺时针方向)。然后计算RV3与VP 的叉积,以确定该点位于区域 1 还是区域 3。
计算反射率:
利用向量投影计算点(x_coord, y_coord)关于对称轴的反射。首先,将向量VP投影到与待测区域对应的镜像边界线上。这样,我们就可以在镜像边界线上找到一个点,该点可以通过一个新向量与点(x_coord, y_coord)相连。这个新向量垂直于镜像边界线。将该向量的长度加倍,即可使向量的端点位于镜像边界线上的对称点处。

将向量 VP投影到向量 V2上的向量投影(Vproj)计算如下:

上述计算方法相比之前的方法的优势在于,向量V2可以根据需要缩放到任意大小,而不会影响最终计算结果。这是因为上述计算中的点积先除以V2的平方 ,然后再乘以V2。需要注意的是,平方的倒数是在其他向量乘法运算之外单独计算的。这个值是一个在 ARM 处理系统上计算的常数,最终被发送到 FPGA 可编程逻辑。除非镜面区域的大小发生变化,否则该值在所有反射计算中都保持不变。
在定点计算中,将所有镜像边界向量(例如向量V2)缩放了 1/256。这样做是为了确保上述公式中计算的点积不会超出我们的定点值。缩放对上述计算的影响如下所示:

上述公式描述了FPGA上的计算过程。按照上述顺序进行计算可以避免定点值溢出。
确定向量 Vproj 后,最后一步是导出正交向量并将其乘以 2,从而得到反射点坐标。
正交向量由以下公式导出:

反射坐标是利用导出的正交向量和该向量所绘制的基点(x_coord,y_coord)计算得出的:

然后检查反射坐标是否位于三角形区域内。如果位于三角形区域内,则将反射坐标存储到内存中。否则,继续计算,直到反射点位于镜像边界内为止。
设计细节
逻辑结构
对于万花筒而言,图中所示的两个并行处理操作可以分别进行反射和视频输入读取,最终构成VGA彩色显示。根据课程网站上的视频显示示例,我们将EBAB模块用于视频输入数据,而提取坐标则用于获取颜色信息。所有模块将在以下章节中详细阐述。

反射模块:
如前所述,创建了一个具有四个状态的反射模块:重置 (RESET)、三角形检查 (TRIANGLE CHECK)、区域检查 (REGION CHECK) 和反射 (REFLECTION)。在重置状态下,完成信号 (done signal) 被重置为 0,接下来状态机将进入三角形检查状态,检查坐标是否在镜面区域内。如果在,则完成信号 (done signal) 被设置为高电平;如果不在,则确定反射区域,并执行反射操作。

M10K 块存储与 SDRAM 读取
由于反射模块需要多个时钟周期才能计算出最终的反射坐标,项目使用 FPGA 内部的 M10K Block RAM 暂存坐标结果。每组 x、y 坐标被打包成 20 位数据,并采用 20×512 的存储结构,以控制片上存储资源的使用。得到反射坐标后,系统根据 M10K 读取的数据生成 video_in_bus_addr,进一步访问 SDRAM 中对应的像素,从而获得最终的图像颜色。
VGA 显示
摄像头输入分辨率为 320×240,而 VGA 输出为 640×480,因此系统需要对图像进行 2 倍放大。项目通过 Verilog 状态机将一个摄像头像素的颜色连续写入相邻的四个 VGA 像素,从而完成分辨率匹配。由于 FPGA 完成一次输入像素处理需要多个时钟周期,因此还通过 SW[9:3] 调节 VGA 更新速度,使显示端能够与图像处理速度保持一致。
用户界面
在 FPGA 端,开发板上的按键和开关主要负责系统复位、视频输入复位、画面暂停以及 VGA 刷新频率控制;在 HPS 端,则通过 C 程序提供更加丰富的参数配置功能。用户可以选择不同的镜面形状和尺寸,包括等边三角形、直角三角形以及自定义顶点模式,还可以设置镜面位置和大小。除此之外,项目还加入了旋转功能,通过旋转矩阵计算新的镜面坐标,再通过 PIO 传回 FPGA,使镜面能够按照设定周期持续旋转。

硬件加速
为了提高万花筒的像素处理速度,项目采用了奇偶像素并行处理的方法,将 x 方向的奇数和偶数像素分别送入两个独立的 Reflection Module,同时使用两个 M10K 模块保存对应的反射坐标。这样可以让两个像素处理路径同时工作,从而提高整体吞吐率。不过,由于 Reflection Module 中包含较多 DSP 乘法运算,项目最终只实现了两个并行模块。在理想情况下,这种并行架构可以将整体仿真处理时间缩短约一半。
结果
在实验过程中,包括最终演示,使用VGA屏幕作为显示介质,效果相当不错;为了更清晰地记录屏幕显示内容以便纳入报告,使用了VGA采集卡。该设备接收VGA信号并通过USB端口将其发送到计算机,从而能够直接在计算机的相机应用程序中读取图像。


项目链接
https://people.ece.cornell.edu/land/courses/ece5760/FinalProjects/s2024/ds2392_kx74_wf223/ds2392_kx74_wf223/index.html
代码链接
https://people.ece.cornell.edu/land/courses/ece5760/FinalProjects/s2024/ds2392_kx74_wf223/ds2392_kx74_wf223/index.html
视频链接
https://youtu.be/tStrc-qmaUo?si=H4rHITRUQMnDk0eQ
总结
本文整理了康奈尔大学 2024 年春季 ECE5760 课程基于 CycloneV DE1-SoC 开发板的 2 个 FPGA 实战项目,全部采用 Verilog 开发,具体项目如下:
Wireworld 模拟器:该项目基于 DE1-SoC,在 FPGA 上实现 Wireworld 元胞自动机,并重点解决大规模网格状态的存储、更新以及多模块同时访问内存的问题。项目将每个单元格用 2 bit 表示四种状态,并通过 M10K 构建最高 1000×1000 的网格,同时设计内存封装和写缓冲机制,让求解器、VGA、鼠标以及 HPS 能够共享 FPGA 内存。用户可以通过 PS2 鼠标直接编辑 Wireworld 网格,通过 VGA 实时观察单元格变化;HPS 则主要负责从文件加载和保存状态,以及控制模拟更新速度。整个设计的重点并不是单纯实现 Wireworld 规则,而是围绕大规模片上存储、多端口访问、实时可视化以及 HPS-FPGA 协同构建完整系统。
万花筒模拟器:该项目利用 DE1-SoC 和 FPGA,将真实万花筒中的多次镜面反射转换为数字几何计算,并通过实时摄像头输入生成动态万花筒图像。系统采用 12.15 定点数进行反射计算,通过三角形检查、区域判断和反射等步骤不断计算新的像素坐标,再利用 M10K 暂存坐标、SDRAM 获取对应颜色,最终输出到 VGA;同时采用两个 Reflection Module 分别处理奇偶像素,实现并行加速。HPS 端则提供镜面形状、尺寸、位置和旋转等参数控制,支持等边三角形、直角三角形、自定义顶点以及动态旋转等模式。项目最终展示了 FPGA 在实时视频处理、几何变换、定点运算、片上存储和硬件并行加速方面的能力。
- -THE END- -
往期精选


FPGA技术江湖广发江湖帖
无广告纯净模式,给技术交流一片净土,从初学小白到行业精英业界大佬等,从军工领域到民用企业等,从通信、图像处理到人工智能等各个方向应有尽有,QQ微信双选,FPGA技术江湖打造最纯净最专业的技术交流学习平台。
FPGA技术江湖微信交流群

加群主微信,备注姓名+学校/公司+专业/岗位进群
FPGA技术江湖QQ交流群

备注姓名+学校/公司+专业/岗位进群