点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
一、单目无人机导航的“预测器悖论”:世界模型在部署时每步都要跑,无人机等不起
导航是具身智能体的基础能力,而空中平台把这个问题推到了最难的形态。无人机的工作空间开阔、纹理稀疏,单个前向相机几乎提供不了可靠的深度和尺度线索。感知因此成为主要瓶颈。人类飞手却能用完全相同的视频流,以第一人称视角高速穿越杂乱场景。问题自然浮现:能否让策略只凭飞手所见的画面,就获得同等的飞行能力?
最近的主流答案来自世界模型。它们不仅监督动作,还监督动作执行后观测如何演化。在飞行中,执行的动作解释了相邻观测之间的大部分变化,因为视点移动的速度远快于场景本身的变化。预测因此很大程度上归结为在已知位移下对场景的重投影。这个重投影由深度决定,而深度恰恰是单目相机无法提供的。学习在动作条件下做预测,就等于学习单目飞行所依赖的几何。地面导航对这种能力的要求要弱得多:地面机器人移动在结构化和纹理丰富的环境中,外观本身已经携带了导航所需的很多信息;它的相机始终保持水平,而多旋翼的每一次加速都会倾斜相机,从而旋转视点、模糊图像;更重要的是,地面机器人可以在计算预测时保持静止。现有的导航世界模型正是为这种设定构建的。

标题:SKYTOPIA: Monocular Drone Navigation via Action-Conditioned Latent World Model
作者:Yuhang Zhang, Rangya Zhang, Yujing Shang, Zhuoyuan Yu, Weiying Wang, Steven Yang, Qingsong Yan, Chao Yan, Mir Feroshkan
机构:Nanyang Technological University,Autel US,XGRIDS,Independent Researcher
项目主页:https://eugshang.github.io/Skytopia/
文章指出,这些世界模型有两个设计选择是飞行无法承受的。
第一,预测对动作的条件约束太弱。 相邻观测高度相关,预测器通过外推过去就能降低损失,只在很小的残差上参考动作。结果生成的未来画面视觉上连贯,却对实际执行的动作不敏感。在地面上这可以容忍,因为外观本身常常足够导航。但在飞行中,动作与图像运动之间的关系是深度唯一可靠的来源。一个忽略动作的预测器编码的是“场景随时间看起来怎样”,而不是“动作如何变换它”。这样的表示缺乏避障所需的深度和尺度。
第二,预测器在部署时被保留。 显式和潜在世界模型都在线产生预测,并将其反馈给动作生成。完整的世界模型因此在每个控制步都要执行。地面机器人可以等待这个计算,无人机不能暂停——推理延迟直接转化为没有新指令情况下飞过的距离。
文章的核心论点由此展开:策略真正需要的不是预测本身,而是产生预测所需的表示。在飞行中,执行的动作几乎解释了观测之间的全部变化,预测退化为在已知位移下重投影一个静态场景。因此,他们提出 SKYTOPIA,一个基于动作条件潜在世界模型的策略,以及训练它的 3D 高斯泼溅平台。前向目标从意图运动预测下一观测的表示,逆向目标从预测的转移中恢复该运动。由于预测永远不会到达动作生成,预测器在部署时被丢弃,一个策略同时服务点目标、图像目标和目标自由三种导航模式。

二、SKYTOPIA 平台:94 个真实场景,3250 万帧,带物理的 3DGS 仿真
演示数据从空中视角获取非常稀缺,物理无人机也无法以可比成本提供。SKYTOPIA 平台重建真实场景为 3D 高斯泼溅(3DGS),并将它们与刚体物理耦合,使照片级渲染和物理交互在同一环境中可用。
文章用手持 LiDAR-相机系统采集每个环境,记录同步点云和 RGB 图像。LiDAR 点云提供度量几何;3DGS 模型针对带位姿的 RGB 图像优化以复现场景外观;从同一重建中提取的三角网格提供碰撞几何,转换为 10 厘米体素的符号距离场(SDF)用于碰撞和间隙查询。模拟器使用 3DGS 渲染、SDF 做物理交互。

平台包含 94 个场景:18 个室内空间、48 个城市户外场地和 28 个植被环境,包括房间、走廊、街道、校园、花园和林地。总可导航面积 75,657 平方米,平均每场景 805 平方米。
数据收集在 Isaac Sim 中以 100 Hz 积分刚体动力学,观测和命令以 50 Hz 记录,前向相机渲染 256×256 RGB 图像。每个动作 指定体坐标系速度和偏航率。记录的 13 维状态包含线速度、角速度、相对目标向量和机体朝向四元数。专家规划器利用重建场景几何生成演示,在网格导出的占据栅格上搜索最短路径,根据障碍间隙和路径曲率调整速度,偏航跟随路径切线,速率限制 1.0 rad/s。采集包含每场景 1000 条轨迹,共 94,000 条,产生 3250 万帧、181 小时飞行。平均规划路径长度 17.2 米,平均回合长度 346 个控制步。
三、动作条件潜在世界模型:前向预测未来表示,逆向恢复动作
SKYTOPIA 的架构如图3所示。共享的视觉-语言骨干编码当前观测、本体状态和可用的目标输入。两组可学习查询在单次骨干前向中产生分离的动作 token。用于预测的动作 token 编码时间窗口上的运动,并支持两个训练目标:前向预测(A)在给定前序状态和这些 token 的条件下估计未来潜在状态;逆向动力学(B)从预测的转移中恢复执行命令。一个冻结的视频编码器从训练片段提供潜在监督。用于动作生成的动作 token 条件化流匹配动作头(C),生成体坐标系速度命令。可用的目标输入定义了点目标、图像目标和目标自由导航(D)。部署时只保留骨干和动作头。

潜在世界状态
动力学预测在潜在空间中监督,不做像素重建。预训练视频编码器 被冻结以提供固定目标:
其中 表示观测流的第 个时间窗口, 是停止梯度算子, 是该窗口的潜在状态。潜在状态的时间分辨率低于观测,这降低了计算量。
前向与逆向动力学
前向头 从动作 token 和前序状态预测下一个潜在状态 。逆向头 从状态对 恢复执行的动作。训练时,前向头使用因果注意力掩码,确保预测 时只能关注当前和之前窗口的 token。前向损失采用 Laplace 似然导出的 目标,对遮挡或新可见区域带来的大残差更鲁棒。冻结目标编码器防止表示坍塌:如果联合优化目标编码器和预测器,常数解会让损失为零,冻结编码器后,任何常数预测都无法同时匹配两个不同目标,损失严格为正。
逆向目标关闭了“外推过去”的捷径。因为预测的转移必须保留命令信息,骨干无法同时满足两个目标而不表示场景在智能体运动下如何重投影。时间对齐上,冻结视频编码器处理 8 帧、tubelet 大小为 2,产生 4 个状态;骨干为 个转移产生动作 token;每个转移对应 2 个命令,因此逆监督覆盖 7 命令块中的前 6 个,动作目标监督全部 7 个命令。
条件流匹配动作头
避障可能允许多条有效轨迹,直接回归会把它们平均成不合适的轨迹。文章使用条件流匹配建模连续动作块上的分布。令 表示 个命令的真值块, 表示学习流生成的块。定义插值:
其中 是高斯噪声, 在 的噪声和 的演示块之间插值。Beta 采样更重视噪声端点附近的插值时间,强调积分早期阶段。动作头参数化向量场 ,条件化动作 token 和本体状态,训练匹配线性插值速度:
推理时,学习到的向量场从噪声积分到数据空间得到 ,命令在执行后才进行下一次骨干查询。超参数见表4。

训练目标与部署
总训练目标为:
其中 和 是可调超参数。与那些在部署时用 rollout 条件化策略的世界模型不同,SKYTOPIA 从不把 或 馈入动作生成,训练完成后动力学目标不再需要。部署模型为:
编码器 、前向头 和逆向头 全部移除。动力学目标因此在不增加推理成本的情况下监督骨干。架构和训练设置见表3和表4。
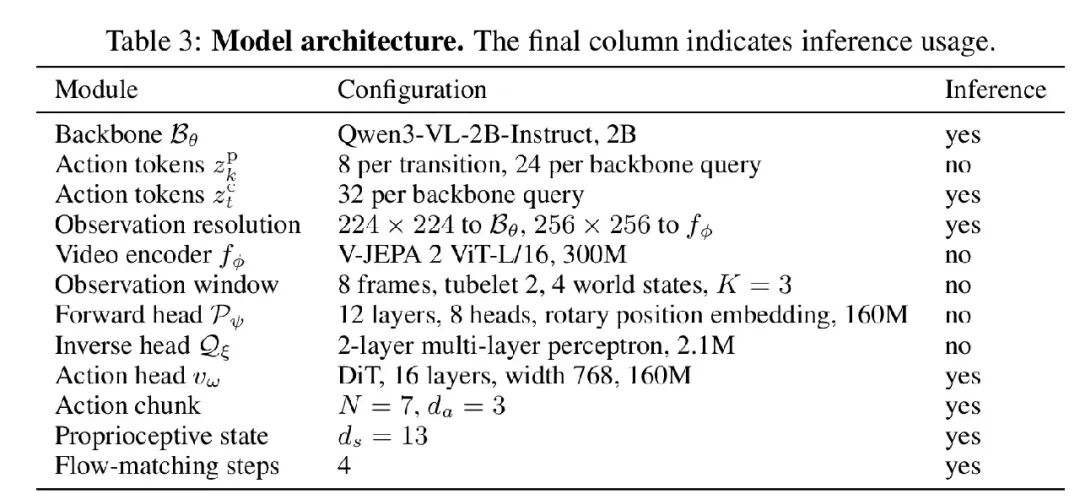
表3列出了模型架构:骨干 Qwen3-VL-2B-Instruct,2B 参数,推理时使用;动作 token 预测用 8 个/转移,生成用 32 个/骨干查询;视频编码器 V-JEPA 2 ViT-L/16,300M,不用于推理;前向头 12 层、8 头、旋转位置编码、160M;逆向头 2 层 MLP、2.1M;动作头 DiT、16 层、宽度 768、160M;动作块 N=7,;本体状态 ;流匹配步数 4。
四、实验:仿真三种模式全面领先,真实飞行零样本部署
所有实验在 SKYTOPIA 平台上运行,包含 94 个场景,分为 18 个室内、48 个城市户外和 28 个植被场景。保留 5 个场景用于 OOD 评估。评估回合使用自由空间中相互可达的起止对,每种配置在每个目标规格下评估 200 个回合、3 个随机种子。
基线覆盖三类:直接映射观测到动作的策略,包括行为克隆(BC)、动作分块 transformer(ACT)、NoMaD 和 ViNT;视觉-语言-动作策略 OmniVLA;世界模型基线 NWM(生成未来观测)和 NavMorph(预测未来潜在状态)。所有基线适配到单目空中导航并在相同数据上重训。
表1 展示了 OOD 场景上的闭环导航结果。SKYTOPIA 在点目标、图像目标和目标自由三种模式下成功率分别达到 57.8%、66.0%、49.0%,比最强基线高出至少 15 个百分点,且使用 2B 骨干、无场景特定适配。丢弃预测器后移除 59.4% 的推理成本。


真实飞行在训练中未见的环境中验证。三种模式分别达到 55%、56.7%、41.7% 成功率。实验使用 DJI Tello,前向 RGB 相机以 30 FPS 流式传输 720p 视频,视场角 82.6°。室内使用 OptiTrack 系统以 120 Hz 位姿更新计算度量目标;室外使用机载 IMU 获取机体朝向,不接收动捕测量。推理管线通过 WebSocket 将视频流传输到配备 RTX 3090 的地面计算机,每帧缩放至 224×224,以约 7 Hz 运行推理。实时分块(real-time chunking)补偿命令执行期间的推理延迟,命令速度限制为 1 m/s。
消融:前向和逆向目标都关键
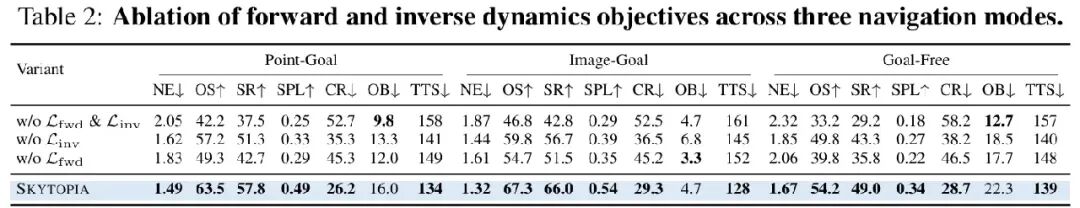
表2 展示了三种导航模式下前向和逆向动力学目标的消融。联合训练两个目标带来最佳性能。

文章在冻结骨干特征上拟合线性探针预测深度和相机位移。联合动力学训练在两个任务上都比消融变体误差更低。几何和运动因此在策略学习期间没有直接监督的情况下,在特征中更易访问。文章将此归因于预测任务的结构:相机运动根据深度改变场景元素的投影位置,在动作条件下预测这些变化鼓励表示编码场景结构和运动。逆向目标进一步要求预测的转移保留命令信息。
推理成本方面,训练后丢弃预测器移除 59.4% 的 FLOPs 和 52% 的延迟。部署模型运行速度快于 NavMorph、OmniVLA 和 NoMaD,同时在三种模式下成功率都更高。NWM 每步需要三个数量级更多的计算和时间。比 SKYTOPIA 运行更快的方法成功率不到它的一半。
五、局限与结论
文章开发了 SKYTOPIA,一个单目无人机导航框架,结合 3DGS 仿真平台和动作条件潜在世界模型训练。使用前向和逆向动力学目标学习支持三种导航模式的策略,部署时不保留预测器。仿真实验展示了相比竞争基线更好的目标到达和路径效率。同一策略零样本部署到物理无人机,在未见过的室内、开放户外和林地环境中展示了避障和成功到达,尽管外观和飞行条件发生变化。
当前策略的局限在于缺乏长期空间记忆,无法支持长视野导航;对动态障碍和时间变化场景的鲁棒性也尚未探索。未来工作将纳入持久记忆用于长视野推理,并将框架扩展到动态环境中的导航。
项目主页:https://eugshang.github.io/Skytopia/提供了更多定性结果和飞行视频,研究者和工程师可以从中了解该系统在真实场景中的表现。
六、从仿真平台到空间智能系统:其域创新与 SKYTOPIA 的产业衔接
SKYTOPIA 的 94 个真实场景重建,背后依托的是其域创新提供的 PortalCam 手持采集系统。通过对真实环境进行快速采集与三维重建,PortalCam 为 SKYTOPIA 将现实空间转化为可用于仿真和训练的数字环境提供了基础。
这一成果背后,连接的是对空间智能的理解。其域创新将空间智能定义为在物理空间中感知、理解并进一步决策和行动的能力。要让 AI 真正进入现实世界执行任务,模型不仅需要“看起来像”,还需要符合真实世界的物理规律,并具备可量测、可计算的空间信息。其域创新选择从真实世界出发,以工程级精度采集和重建物理空间,将真实环境转化为可被专业人士、普通用户以及 AI 共同使用的空间数据。而 SKYTOPIA 则进一步将这些真实空间转化为 AI 可以学习和交互的仿真环境:首先通过手持 LiDAR-相机系统采集真实环境,再利用 3DGS 等技术重建为可渲染、可碰撞的数字空间,随后让无人机策略在仿真环境中进行训练,最终实现向真实无人机的零样本部署。两者的衔接,也体现了空间智能从“理解世界”走向“在世界中行动”的技术路径。