【科技纵览】当一段仅五秒的韩国职棒转播视频在X平台斩获超1500万次播放时,没人想到这竟是一场精心策划的“数字幻觉”。画面中,一位身着白衣牛仔裤的女性在看台叹息,看似对比赛兴致缺缺。然而,资深球迷很快识破破绽:比分牌上的击球手曹仁成早在2017年退役并转型教练;看台标语多出一个字符,疑似AI生硬翻译;解说员更是操着标准美式口音。这位并不存在的“普通韩国女性”,实为AI生成产物。有趣的是,真相大白后,该视频并未销声匿迹,反而演变为社交网络爆款模板——用户纷纷将自身面孔嵌入同一场景,体验“被球场镜头抓拍”的快感。
这种“先欺骗大众,再衍生玩法”的路径,揭示了AI图像传播的新逻辑:美女形象并非偶然配角,而是某种根深蒂固的“默认值”。这一现象可追溯至半个世纪前。1973年,南加州大学信号图像处理研究所的研究人员急需测试图像,同事随手撕下1972年11月《花花公子》杂志中间插页的一条长条送入扫描仪。图中模特Lena Soderberg戴宽檐帽、侧身裸肩的形象,因兼具细节、阴影与纹理,且符合当时男性主导研究圈的审美,迅速成为行业通用测试图。尽管1991年《花花公子》曾主张版权,最终却选择默许其作为“现象级素材”流通。直至2024年4月1日,IEEE计算机协会才正式拒收使用此图的论文,终结了长达五十一年的争议。
如今,技术考题已变,但“默认值”的逻辑未改。AI难以画出满杯红酒或正确钟表指针,源于训练数据中红酒多不满杯、广告钟表常停在10:10的统计惯性。而在人脸生成上,这种惯性恰好与人类审美重合。1990年心理学家Judith Langlois的实验证实,数学合成的“平均脸”比任何单张真人脸更具吸引力,且参与平均的脸越多,美感越强。生成模型本质是学习数据分布并从中心取样,因此天生倾向绘制“平均脸”,而平均脸恰是人类眼中的美。2023年澳大利亚国立大学研究更发现,AI生成的白人面孔因更接近群体平均值,被判定为“真人”的概率甚至高于真实照片,这种现象被称为“AI超真实”。
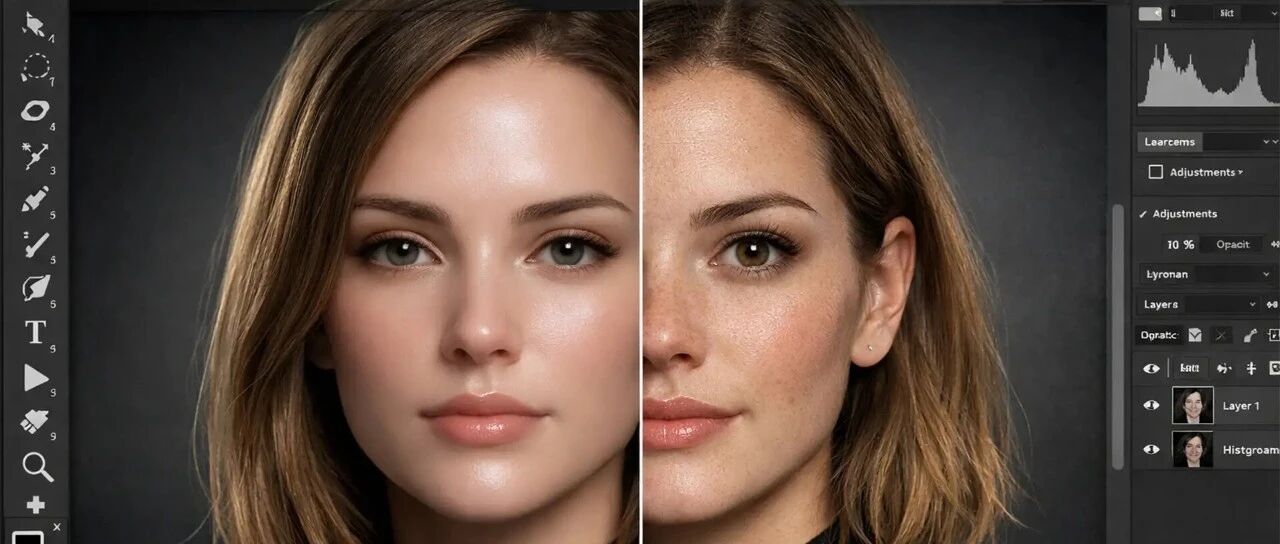
值得注意的是,早期批评者指出合成脸好看可能仅因抹去了皮肤瑕疵,这一方法论质疑在今天竟成预言:过度光滑的皮肤已成为识别AI美女的关键破绽。2022年底爆红的Lensa应用印证了数据偏见的力量。记者Melissa Heikkilä上传自拍后,AI自动生成大量裸露或性感肖像,而其男同事获得的却是宇航员等职业形象。这是因为训练数据中充斥衣着暴露的女性图片,模型将其设为默认输出。用户随后的保存、转发行为如同投票,进一步强化了这一倾向。数据显示,AI图像社区Civitai上成人向内容占比从2023年初的41%飙升至2024年底的80%。
厂商虽在前台设置严格审核,后台却通过“奖励模型”如PickScore微调算法,迎合用户偏好。研究发现,即便提示词无关色情,经PickScore微调后的模型仍会增多NSFW内容生成。这种前台拦截与后台拉扯的矛盾,使得大模型在可控性上存在灰色地带。正如荷兰动物行为学家Niko Tinbergen提出的“超常刺激”理论,海鸥会放弃真蛋去孵化更鲜艳巨大的石膏假蛋。人类对美的偏好亦有生物基础,婴儿即偏爱有吸引力的面孔。
当前,至少有一家主流AI公司将此心理转化为产品功能。Grok推出的“Spicy”模式允许付费用户生成暗示性内容,2026年1月更爆出可上传照片进行“数字脱衣”,引发多国政府干预。X平台随后将图像生成限制为付费服务,被英国首相发言人批评为“将违法功能变现”。从1973年实验室里的男性研究员,到今天高频点击的用户群体,AI模型的“默认值”始终由最活跃的那部分人塑造。用户的每一次点击都在强化这一反馈循环,最终使特定审美成为内容消费的既定选项。
从“Lena”到AI美女:算法如何重塑视觉默认值
科技区角
2026-10-05 13:31
关于科技区角:国内科技展会垂直内容策划服务商,提供从论坛内容全案策划、会展市场化IP打造到精准专业观众一站式邀约服务,以产业内容吸引高质量B端人群,打通展会从议题设计、演讲嘉宾邀约、宣传预热、精准邀观到供需对接全链路。
声明:内容取材于网络,仅代表作者观点,如有内容违规问题,请联系处理。