
> 作者:李剑锋
1. 前言
在前面的文章中,我们已经沿着一次模型调用,认识了输入处理、Prefill、KV Cache、Decode 和输出返回,也了解了 vLLM 如何通过请求调度和缓存管理,让多个请求共同使用有限的计算资源。这些内容帮助我们看清了推理服务内部的工作过程。
不过,前面的讨论都建立在模型服务已经启动,模型也已经加载完成的基础上。所以在本篇文章中,我将一步步带领大家完成从创建远程服务器到安装驱动再到安装环境及模型最终将 qwen3-0.6B 模型在云端服务器运行起来的全过程。
在后续的课程里,我们还将会基于我们在云端部署好的模型,搭建起应用并进行测评。那事不宜迟,我们马上开始吧!
2. 先准备一个能够使用 GPU 的 Linux 环境
本文采用 Linux + NVIDIA GPU 的方式运行 vLLM,因此首先需要准备一个能够正常使用 GPU 的 Linux 环境。这里不仅要考虑操作系统,还要确认显卡和驱动是否满足运行要求。对于主要使用 Windows 或 macOS 的读者,可以根据本地设备条件,选择适合自己的环境获取方式。
第一种是在 Windows 电脑上使用 WSL2。 WSL2 可以让我们在 Windows 中运行 Ubuntu 等 Linux 发行版,不必更换原有操作系统。在显卡、驱动和系统版本满足要求的情况下,Linux 环境中的程序也可以使用本机的 NVIDIA GPU。这种方式适合已经配备兼容显卡、希望继续使用 Windows 的读者,但模型运行仍然依赖本机的计算资源,需要提前考虑显存容量,并为软件环境和模型文件预留足够的磁盘空间。
第二种是通过虚拟机安装 Linux。 虚拟机可以提供独立的 Linux 系统,但安装好操作系统,并不意味着其中的程序就能直接使用宿主机的 NVIDIA 显卡。要沿用本文的 GPU 推理方式,还需要虚拟化平台与硬件提供相应支持,并配置 GPU 透传等机制,将显卡资源提供给虚拟机使用。因此,选择这条路线前,需要先确认 GPU 能否在虚拟机中正常工作,而不能只检查 Linux 是否安装成功。
第三种是租用云端 GPU 服务器。 不希望调整本地系统,或者本地没有满足要求的显卡时,可以将模型放到云服务器上运行。本地电脑负责编辑代码、查看日志和发送请求,实际的模型计算则由云服务器上的 GPU 完成。可选择的平台包括 AutoDL、趋动云、百度智能云等,具体可以结合所需的 GPU 型号、使用成本和操作习惯进行选择。
本次实验采用第三种方式,使用百度智能云上一台配备 Tesla T4 的服务器完成演示。下面将从创建服务器开始,逐步完成远程连接、运行环境配置、模型下载和首次推理。其他云平台的购买页面、连接方式和预装环境可能有所不同,但可以参考同样的配置思路,并根据实际环境调整具体操作。
3. 在百度智能云开通 GPU 服务器
3.1 从产品入口进入购买页面
首先进入百度智能云官网,登录账号,并完成平台要求的账号准备。

然后在顶部“产品”菜单中,找到“GPU 云服务器”。这里需要选择带 GPU 的计算资源,因为想要将大模型运行起来光靠 CPU 并不足够。
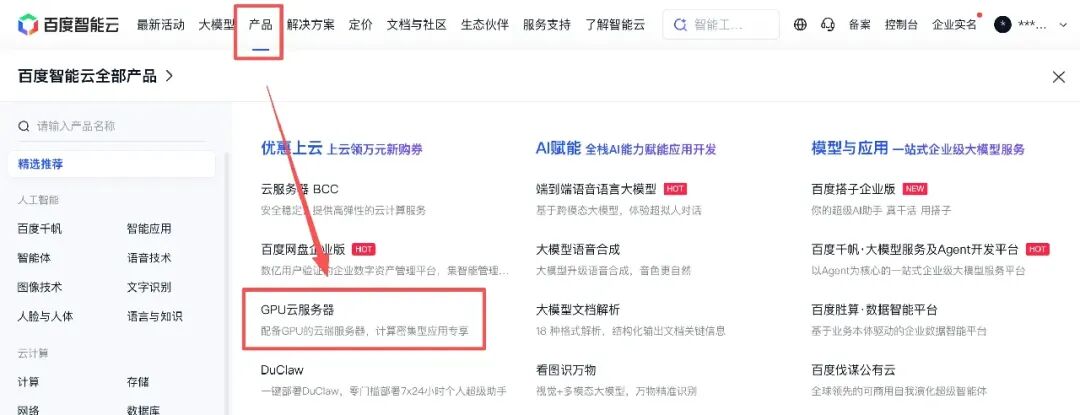
进入“GPU 云服务器”产品页后,点击“立即购买”,开始配置实例。

那在配置这里,本次选择“按量付费”,地域为“华北—北京”。地域和可用区决定资源所在位置,也影响可选型号与库存;可以根据实际资源情况调整。

3.2 选择 GPU、操作系统和存储
接下来配置云服务器的计算资源。在购买页面中,百度智能云会先通过“产品—架构—分类—实例规格”几层选项逐步确定最终使用的服务器配置。
首先是产品。这里选择 BCC(Baidu Cloud Compute)云服务器。可以把 BCC 理解为百度智能云提供的一类虚拟云服务器:底层物理服务器由云平台维护,我们获得其中的一组 CPU、内存、GPU、磁盘和网络资源,并可以像操作普通 Linux 服务器一样安装软件、运行程序。百度智能云同时还提供 EBC,EBC 更接近弹性裸金属服务器,强调物理资源独享和更强的硬件隔离。对于本课程这种大模型部署与推理实验,使用 BCC 即可。
接下来选择架构。需要注意,这里的“架构”是云平台为了方便选型所设置的计算资源分类,并不完全等同于计算机组成中所说的 CPU 指令集架构。页面中主要包括 x86 计算、ARM 计算和异构计算 GPU / FPGA / NPU。x86 和 ARM 主要依靠 CPU 完成计算,而异构计算服务器除了 CPU 之外,还配置了 GPU、FPGA 或 NPU 等专用计算设备。由于大模型推理中的矩阵运算通常需要 GPU 加速,因此这里选择“异构计算 GPU / FPGA / NPU”。
进入异构计算后,还需要选择具体的分类,也就是实例规格族。例如截图中的 GPU 计算型 GN3、GN5、GN7 等,可以理解为不同代际和不同硬件组合的 GPU 服务器系列。不同规格族采用的 GPU 型号、CPU、内存以及网络能力可能不同,因此适合的任务也有所区别。例如百度智能云目前将 GN3 T4 系列定位于人工智能推理、高性能数据分析和视频处理等场景。
最后,由于 qwen3-0.6B 模型较小,因此这里我们选择比较便宜的配置即可,也就是 16 核 CPU、64 GiB 系统内存以及 1 张 NVIDIA Tesla T4 GPU。当然假如大家有更大范围的需求,也可以选择其他模型进行使用,百度智能云还提供了 V100 或者 GeForce 系列的 3090 等显卡。

在选择好了设备以后,接下来我们可以为我们的设备配置上基本的环境。可以把镜像理解为创建服务器时使用的一份系统模板,其中包含操作系统以及部分预装软件。服务器创建完成后,我们实际上就是在这套系统环境中安装 Python、CUDA、vLLM 等工具。在百度智能云中提供了公共镜像、GPU 镜像等多种镜像类型。由于 GPU 镜像里的 Ubuntu 版本及 CUDA 版本较低,因此本次选择的是公共镜像,并使用 Ubuntu 22.04 LTS。后续我们再自行安装相关的环境。此外,截图下面还有一个主机安全选项。本次选择免费的基础版即可。

存储部分选择通用型 SSD,截图中的系统盘容量为 40 GiB。系统盘不仅存放 Ubuntu,还会容纳 Python 环境、安装缓存和模型文件。本次小模型演示采用这个容量,后续使用更大的模型或保留多个环境时,应根据实际占用扩容或配置数据盘,不能只按模型权重大小估算全部空间。

3.3 配置公网访问和登录方式
接下来配置公网访问。如果希望在本地电脑通过 SSH 连接云服务器,或者后续让本地程序访问部署在服务器上的 vLLM API,就需要给实例绑定一个弹性公网 IP(EIP)。可以把它理解为云服务器面向互联网的访问地址:服务器内部原本只有私网地址,绑定公网 IP 后,外部设备才能通过互联网访问这台服务器。这里选择标准型 BGP 即可,适合普通实验和开发场景,不需要额外使用增强型线路。
公网带宽这里选择按使用流量计费,比较适合使用时间不固定、数据传输量也不大的场景。截图中的 20 Mbps 表示公网传输的最高带宽,并不是每小时固定按照 20 Mbps 收费;真正产生费用的是实际传输的数据量。例如通过 SSH 输入命令几乎不会产生多少流量,下载模型、传输大文件或者频繁调用 API 时才会产生较明显的公网流量。需要注意,页面提示公网 IP 在未绑定实例时可能产生闲置费用,因此没有继续使用时不要单独保留公网 IP。
此外,这里建议将“随实例释放”保持开启。这样删除或释放云服务器时,对应的公网 IP 也会一起释放,避免服务器已经不用了,但公网 IP 仍然保留并继续产生费用。对于本次短期 vLLM 实验,这种设置最省事,也更容易控制成本。

登录方式可以使用密钥对,也可以使用账号密码。使用密钥时,公钥交给服务器,私钥保留在自己的电脑上,SSH 使用配套的密钥完成身份验证。

本文后续截图采用密码登录,因此选择“用户自定义”并设置管理员密码。请记住这里设置的是 Ubuntu 服务器的登录密码,后面输入的不是百度智能云网站的账号密码。两种登录方式选择一种即可,不需要同时完成。

3.4 确认订单并找到实例
配置完成后,先查看购买数量与费用,再点击“确认购买”。服务器配置费用和公网费用可能分别展示,不能只看其中一个数字就认为已经包含全部成本;截图里的价格仅记录本次操作时的页面。假如我们害怕忘记释放容器导致持续产生费用的话,我们也可以选择开启自动释放并选择对应的日期。
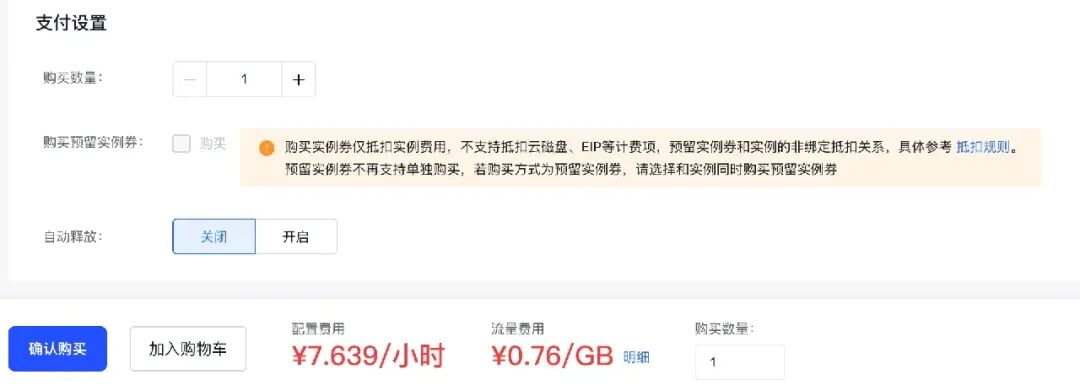
在确认订单页,核对 GPU 型号、GPU 数量、CPU、内存、Ubuntu 版本和系统盘,再提交订单。尤其要确认购买的是 GPU 实例,而不是只选择了名称相近的普通计算规格。

购买完成后,页面会提示资源正在开通。点击“返回产品控制台”,等待实例创建结束。

在完成创建后,我们看呀在 BCC 的实例列表中,找到刚刚创建的服务器,确认状态已经变为“运行中”。到这里,我们已经获得了一台远程 Ubuntu 机器,但还需要建立连接,才能在里面执行后续安装。

4. 使用本地 VS Code 连接服务器
4.1 安装 Remote - SSH 扩展
接下来回到自己的电脑,打开 VS Code。VS Code 的窗口运行在本地,后面打开的文件和终端则可以位于远程服务器。 这样可以继续使用熟悉的编辑器,同时把模型和计算任务放在云端。

进入扩展面板,搜索 SSH,安装 Microsoft 提供的 Remote - SSH。这是 VS Code 的远程连接扩展,安装位置是本地电脑;后面通过它登录服务器并打开远程工作环境。

4.2 添加服务器的 SSH 地址
安装后,左侧会出现远程资源管理器入口。在 SSH 区域点击“+”,添加一个远程主机;也可以从命令面板执行 Remote-SSH: Add New SSH Host...。

此时回到百度智能云实例列表,找到“主 IPv4 地址 / 带宽”。截图中,192.168.16.2 标注为内网地址,180.76.118.93 标注为公网地址。我们从自己的电脑直接连接时使用公网 IP;内网地址用于对应私有网络中的通信,没有建立 VPN 等连接时,本地电脑不能直接通过它访问这台云服务器。
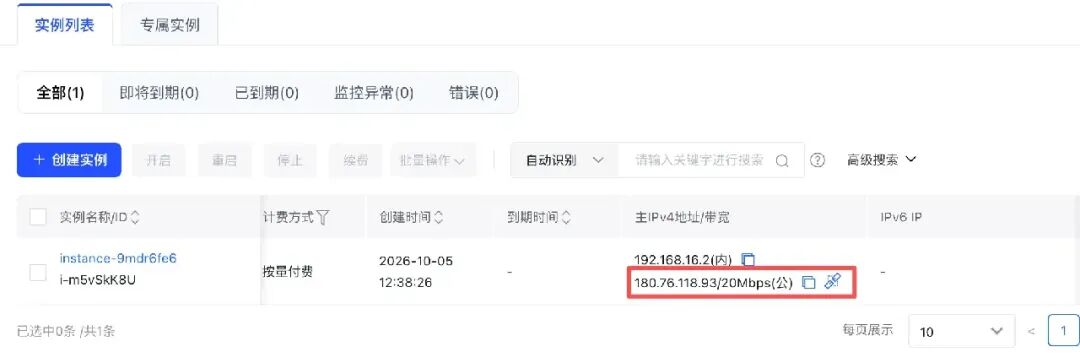
在 VS Code 的输入框中填写下面的 SSH 命令。这里的 IP 是本次实例的示例,大家应替换为自己实例的公网 IP;页面上附带的 /20Mbps 是带宽信息,不属于连接地址。
ssh root@180.76.118.93
root 是本次服务器登录用户,SSH 使用默认的 22 端口。添加主机时把用户也写出来,可以避免连接程序误用本地电脑的用户名。如果自己的镜像使用其他登录用户,应按实际账号填写。
接下来选择保存 SSH 配置的位置。截图是在 macOS 中保存到当前用户的 .ssh/config,选择自己的用户配置文件即可,路径里的用户名不需要与截图一致。

保存后,远程资源管理器中会出现这个主机,点击“Connect”或主机旁的连接按钮。

4.3 登录并确认远程终端
首次连接可能要求确认主机指纹、选择远程操作系统,以及输入服务器密码。确认正在连接自己的实例,操作系统选择 Linux,密码则使用开通服务器时设置的登录密码。完成这些步骤后,VS Code 会准备远程组件。
截图左下角的“Opening Remote...”表示连接过程尚未结束。首次准备环境可能需要等待一段时间,应结合连接日志判断进度。

连接成功后,左下角会显示 **SSH: 180.76.118.93**。这时新建终端,可以看到类似 root@instance-...:~# 的提示符,说明终端已经在云服务器上运行。

从这里开始,除特别说明外,后面的命令都在这个远程 Ubuntu 终端里执行。本次以 root 用户演示,因此命令没有加 sudo;使用普通账号时,系统软件安装和驱动操作需要相应的管理员权限。如果连接超时,可先检查实例是否运行、IP 是否正确,以及安全组是否允许自己的连接来源访问 SSH 端口。
5. 在服务器上安装驱动、vLLM 和模型
5.1 先分清驱动、CUDA 和 Python 环境
在 GPU 服务器上部署 vLLM,首先需要准备好几个不同层次的运行环境:NVIDIA 驱动、CUDA 相关运行库以及 Python 环境。它们承担的作用不同,配置时也不需要全部手动安装。
其中,NVIDIA 驱动负责让操作系统识别并使用 GPU,是后续运行 PyTorch 和 vLLM 的基础。Python 虚拟环境则用于安装和管理 vLLM、PyTorch 等 Python 软件包,避免不同项目之间的依赖相互影响。本文使用 Python 自带的 venv 创建独立环境,不需要额外安装 Anaconda。
对于本文采用的预编译软件包安装方式,通常也不需要手动安装完整的 CUDA Toolkit。安装 vLLM 和 PyTorch 时,会同时准备与其版本匹配的 CUDA 运行依赖,只需要保证服务器上的 NVIDIA 驱动满足要求即可。只有在需要从源码编译 vLLM、编译 CUDA 扩展或进行 CUDA 程序开发时,才需要进一步安装完整的 CUDA Toolkit。

5.2 检查显卡并安装 NVIDIA 驱动
先在远程终端执行:
nvidia-smi
如果能够正常显示 GPU、驱动版本和显存信息,就继续检查后面的 Python 环境。如果提示找不到命令,则先检查显卡与驱动安装情况,不能只根据系统列出的建议随意安装一个 nvidia-utils 包。
下面更新软件列表,安装硬件检查工具、Ubuntu 驱动管理工具及当前内核的头文件,再查看系统识别到的 NVIDIA 设备和可用驱动:
apt update
apt install -y pciutils ubuntu-drivers-common linux-headers-$(uname -r)

lspci | grep -i nvidia
ubuntu-drivers list --gpgpu
本次使用 580-server 驱动分支。如果可用驱动列表中包含 nvidia-driver-580-server,再执行下面的安装命令。这里的版本号需要与实际可用驱动及所安装 vLLM 的要求匹配。
ubuntu-drivers install --gpgpu nvidia:580-server
apt install -y nvidia-utils-580-server
安装过程中可能出现“Pending kernel upgrade”,提示新的内核需要通过重启生效。下面这张图就是这个正常提示界面:点击终端后按 Enter 确认,让当前安装继续,等安装全部结束、返回命令提示符,再进行重启。

reboot
reboot 重启的是云服务器,SSH 会暂时断开。等待服务器重新启动,再通过 VS Code 连接;密码登录时,按提示重新输入服务器密码即可。

重新连接后,再次执行 nvidia-smi。下面的输出已经识别到 Tesla T4,驱动版本为 580.178.04,可见显存为 15360 MiB。当前没有 GPU 任务,显存占用为 0,符合尚未启动模型的状态。

这里的 CUDA Version: 13.0 表示驱动支持的 CUDA 版本,不能仅凭这个字段判断已经安装了哪个版本的 CUDA Toolkit。稍后还需要从 Python 中检查能否实际使用 GPU。
5.3 创建 Python 虚拟环境并安装 vLLM
接下来安装创建虚拟环境需要的工具,将本次 Python 环境放在 /root/venvs/vllm,并激活它:
apt install -y python3-venv python3-pip curl

python3 -m venv /root/venvs/vllm
source /root/venvs/vllm/bin/activate

python -m pip install -U pip uv
最后一行升级虚拟环境中的 pip,并安装 uv。完成后,再使用 uv 安装 vLLM,以及后面下载模型需要的 ModelScope:
uv pip install vllm modelscope \
  --torch-backend=auto \
  --default-index http://mirrors.baidubce.com/pypi/simple/
--torch-backend=auto 让 uv 根据已有驱动选择相应的 PyTorch 后端。--default-index 则为普通 Python 依赖指定百度镜像;uv 不会直接继承 pip 的镜像配置,所以这里显式写出地址。命令末尾的反斜杠 \ 表示下一行仍属于同一条命令,只是为了便于阅读。复制时保留完整命令即可。
下面的截图展示了 pip、uv 安装完成,以及后续依赖准备中的输出。vLLM 涉及多个依赖和较大的软件包,需要等整个安装过程结束,不能只看到 Successfully installed pip ... uv ... 就认为 vLLM 也已经安装完成。

安装结束后,在当前虚拟环境中检查 Python 是否能使用显卡:
python -c "import torch; print('CUDA可用:', torch.cuda.is_available()); print(torch.cuda.get_device_name(0))"
下面的结果显示 CUDA可用: True 和 **Tesla T4**。这一步把系统层面的驱动检查,推进到了 Python 层面的 GPU 使用检查,说明当前环境已经可以继续运行后面的示例。

以后新建或重新打开远程终端,使用这套 Python 环境中的 vLLM、ModelScope 等命令前,都先执行 source /root/venvs/vllm/bin/activate。
5.4 下载 Qwen3-0.6B 模型
软件准备完成后,还需要下载我们要运行的模型本身。本文选择 Qwen3-0.6B,通过魔搭 ModelScope 下载,并将模型文件放到服务器的 /root/models/Qwen3-0.6B 目录:
modelscope download \
  --model Qwen/Qwen3-0.6B \
  --local_dir /root/models/Qwen3-0.6B
--model 指定模型仓库名称,--local_dir 指定保存目录。这里下载整个模型仓库,除了权重,还包括加载模型需要的配置和分词器等文件。安装 vLLM 和下载模型是两个不同的步骤:前者准备推理工具,后者准备实际要运行的模型。

截图展示的是下载过程。等下载完成、终端返回命令提示符后,再进入服务启动步骤。模型文件保存在服务器上,因此下载不需要先经过自己的电脑。
6. 启动 vLLM,并完成第一次推理
6.1 从本地模型目录启动服务
当环境配置好后,接下来我们就可以开始运行模型了。现在将当前远程终端作为终端 A,用于持续运行 vLLM。确认虚拟环境已经激活后,执行:
vllm serve /root/models/Qwen3-0.6B \
  --served-model-name qwen3-0.6b \
  --dtype half \
  --max-model-len 4096 \
  --max-num-seqs 4 \
  --gpu-memory-utilization 0.5 \
  --enforce-eager \
  --host 127.0.0.1 \
  --port 8000
vllm serve 从指定目录加载模型,并为其他程序提供接口。--served-model-name qwen3-0.6b 设置调用时使用的名称,后面请求中的 model 字段需要与它一致。
这里特别设置 --dtype half,即 FP16。T4 不支持本次模型可能默认使用的 BF16 计算方式,因此显式选择合适的数据类型,避免加载时出现精度不兼容问题。
其余资源参数先采用便于完成小规模演示的设置:
--max-model-len 4096限制一条序列的上下文范围,包含输入与输出;--max-num-seqs 4限制每轮处理的序列数量;--gpu-memory-utilization 0.5参与当前模型执行器的显存规划,不代表 GPU 计算能力只使用一半。--enforce-eager使用 eager 执行方式,便于先把本次启动流程跑通。
这些数值是演示配置,性能调优时再逐项评估。

启动后需要等待模型加载和服务初始化。看到 Application startup complete,说明 API 服务启动完成;接下来还要通过实际请求检查调用结果。

这条命令监听的是**服务器自身的 127.0.0.1:8000**。VS Code 可能自动识别端口,并出现“应用正在 8000 端口运行”的提示,但这不表示云服务器的公网 8000 端口已经开放。这里先让同一台服务器上的程序调用服务,保持终端 A 运行。
6.2 在另一个远程终端发起请求
当模型服务已经启动后,我们可以点击 VS Code 终端面板右侧的“+”,新建终端 B。终端 A 继续运行模型服务,终端 B 用来发送请求;如果在终端 A 中按 Ctrl+C 停止服务,后面的调用就无法继续。
在终端 B 执行下面的命令。这里使用系统提供的 curl 发送 HTTP 请求,因此这一步不依赖新终端是否已经激活 Python 虚拟环境:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "qwen3-0.6b",
    "messages": [
      {"role": "user", "content": "你好,用一句话介绍你自己。"}
    ],
    "max_tokens": 128,
    "temperature": 0.7,
    "chat_template_kwargs": {"enable_thinking": false}
  }'
请求发送到 vLLM 的对话接口。messages 中放入用户问题,model 指向刚刚设置的服务名称,max_tokens 限制本次输出长度。这里还通过 Qwen3 的聊天模板参数关闭思考模式,先观察直接回答,减少首次验证时的额外内容。

截图中的接口返回了 JSON,其中 choices[0].message.content 包含“我是AI助手,帮助您解决问题和获取信息。”,finish_reason 为 stop。这说明本次演示已经完成了模型加载、服务启动、请求提交和回答返回。读者运行同样的请求时,具体措辞可能不同,检查重点是接口是否正常返回,以及回答字段是否包含生成内容。
到这里,前面介绍的推理流程就与实际操作连接起来了:应用提交消息,服务整理输入,模型执行 Prefill 和后续生成,再把结果组织成响应。我们发送的是一次请求,而不是为每个输出 token 重新调用一次接口。
6.3 从自己的电脑访问这项服务
前面的 curl 在服务器终端中执行,所以 127.0.0.1 指向云服务器。若改为在自己的电脑中执行,同一个地址就指向自己的电脑,需要先建立端口转发。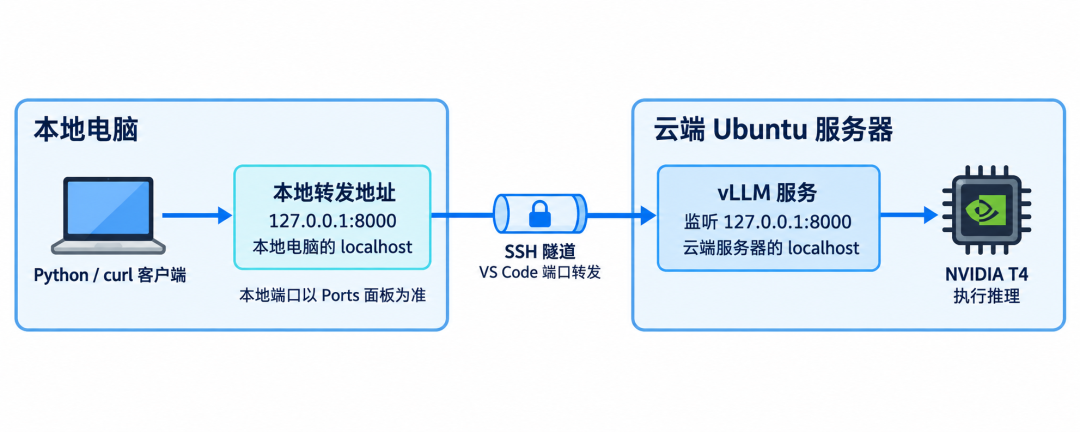
在已连接服务器的 VS Code 中,打开底部 Ports / 端口 面板,添加远程端口 8000,再查看对应的本地地址。如果显示 127.0.0.1:8000,就可以在本地终端使用前面的请求;如果本地 8000 已被占用,VS Code 可能分配其他端口,此时按面板显示的实际地址调用。
这样,本地程序通过 SSH 转发访问模型接口,模型仍然在服务器的 T4 上计算。后续无论使用 Python 客户端还是网页应用,都可以在这条调用路径上继续扩展。
7. 总结
本篇以百度智能云上的 Tesla T4 服务器为例,从计算资源与操作系统的选择出发,逐步完成了 VS Code 远程连接、NVIDIA 驱动检查、Python 虚拟环境创建,以及 vLLM 安装和 Qwen3-0.6B 模型下载。最后,我们启动模型服务,并通过实际的接口请求获得了回答,打通了从准备云端环境到完成第一次模型推理的完整流程。
在这个过程中,环境配置并不是把软件安装完就结束,而是需要逐层确认每个环节是否正常:通过 nvidia-smi 检查显卡与驱动,通过 Python 中的 CUDA 检查确认当前环境能够使用 GPU,再通过服务启动日志和实际返回的回答验证模型是否可以正常调用。这些检查既是判断配置是否成功的依据,也是后续遇到问题时定位故障的线索。
同时,我们也明确了本地电脑与云服务器的分工:本地电脑负责编辑代码、管理连接和发送请求,模型计算则在云服务器上完成。通过 VS Code 的端口转发,本地程序也可以访问云端的模型接口。在这一基础上,后续就可以进一步使用 Python 调用模型、接入网页应用,并通过并发测试和性能评估,观察前面介绍的调度与缓存机制在实际运行中的表现。本次实验先解决“能够运行和调用”,后续再逐步研究“如何更方便地使用、如何更高效地运行”。
实验结束后,还需要回到云控制台检查实例、磁盘和公网 IP 等资源的保留与计费状态,及时释放不再使用的资源。关闭 VS Code 或断开 SSH,只是结束了本地连接,并不代表云端资源已经停止运行或计费。
那下一节课中,我们将在这套环境的基础上,进一步介绍 vLLM 的实际应用与运行测试方法:通过 Python 调用模型,将模型服务接入网页应用,并演示如何查看服务运行状态、测试生成速度,以及观察多个请求同时到达时的处理表现。我们将从“能够运行”进一步走向“会使用、会测试”,既掌握模型服务的具体使用方式,也通过实际测试,将前面介绍的请求调度、缓存管理等机制与运行表现联系起来。
-- 完 --
关注机智流并加入 AI 技术交流群,不仅能和来自大厂名校的 AI 开发者、爱好者一起进行技术交流,同时还有与、、、、等。
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群



