点击下方卡片,关注「3D视觉工坊」公众号
选择星标,干货第一时间送达
作者供稿直发 | 来源:3D视觉工坊
3D视觉硬件汇总,包括结构光3D相机(支持室内外,焊接,机械臂抓取等场景),相位偏折术、散斑、机械臂抓取和焊接软件,手持扫描仪(支持定位、重定位、稠密建图)、四足狗和小车定位和导航,底盘。点击->查看详情:
移动机器人、无人车和人形机器人普遍配备多台同步相机。传统多相机 SLAM 早已利用相机间的标定关系,但近年基于三维基础模型的流式定位方法,大多仍以单张图像为处理单位。
浙江大学的研究团队提出 StreamRig,将流式里程计的基本观测单位由单帧图像扩展为整组同步相机。冻结的三维基础模型对同一时刻的多视图图像及其标定参数进行联合编码;时间维度上仅保留经过压缩的紧凑状态,每台相机 16 个特征。
在 NCLT 数据集一条约 6 公里的校园路线上,单目流式方法 CUT3R 的绝对轨迹误差为 164.7 米;将五台环视相机作为整体进行估计的 StreamRig,将这一误差降至 25.8 米。
在四类平台上,StreamRig 的平移与旋转漂移均低于八种对比方法。在相同输入分辨率下,StreamRig 处理五台相机的单步耗时为 26.2 毫秒,低于 CUT3R 处理单张图像的耗时。
论文:
StreamRig: Exploiting Intra-Rig Geometry for Streaming Multi-Camera Odometry
作者:Yufei Wei, Shuhao Ye, Qi Wang, Xin Zheng, Qing Huang, Rong Xiong, Yue Wang†
单位:浙江大学、华南理工大学
论文:arxiv.org/abs/2609.40244
主页:weiyufei0217.github.io/StreamRig
代码:github.com/WeiYuFei0217/StreamRig
第一作者简介:魏雨飞,浙江大学博士生,研究方向为 3D 视觉感知、世界模型与具身智能。以第一作者在 CoRL、IROS、ICRA、RA-L、T-ASE 等机器人顶会顶刊发表/在投论文 6 篇,拥有 5 项全国竞赛冠军及 6 项国家发明专利授权,并担任机器人领域多个顶会顶刊审稿人;实习于头部自动驾驶/具身公司从事世界模型研究。目前积极寻求新的职业发展与合作机会,欢迎交流。
个人主页:weiyufei0217.github.io
联系邮箱:wyf00@zju.edu.cn
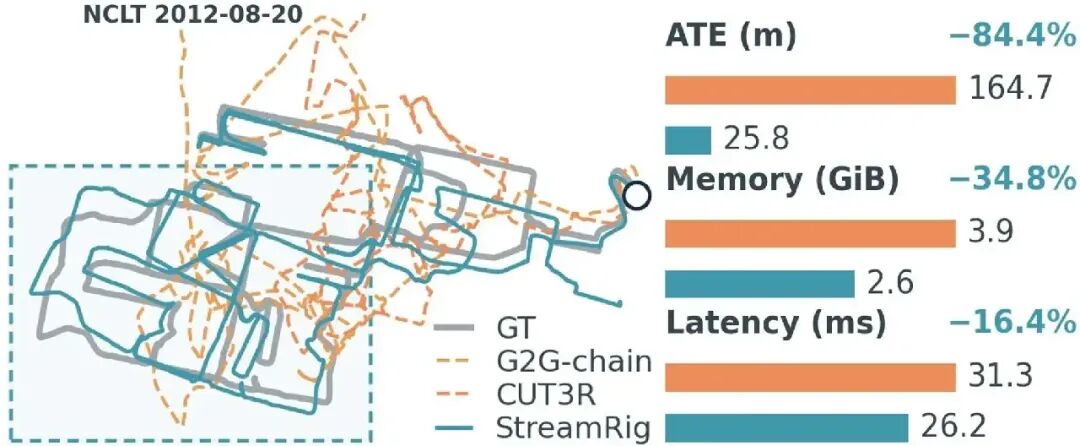 图 1 左图:NCLT 2012-08-20 路线,青色实线为 StreamRig,两种橙色虚线为 G2G 逐对串接和 CUT3R,灰色为真值;左下虚线框为图 2 点云的范围。右图:与 CUT3R 的轨迹误差、显存和延迟对比;精度对比采用九帧窗口微调的 CUT3R,开销对比采用其循环版本,二者分别测量。
01 研究动机:多视图几何与时序信息难以兼得
视觉里程计(visual odometry)仅依靠相机图像,连续估计平台的位置与朝向。由于误差随行驶距离累积,通常以相对漂移衡量精度,即每行驶 100 米产生的位置偏差百分比。
多相机系统为这一任务提供了更丰富的信息。当前方视野被遮挡时,侧向相机仍可提供有效观测;平台转向时,原本位于前方的场景仍保留在其他相机的视野中。此外,这些相机刚性安装在同一平台上,彼此的相对位姿已通过标定获得。论文将这样一组相机称为 rig,将相机间已知的几何关系称为 rig 内几何(intra-rig geometry)。
然而,在基于三维基础模型的技术路线中,现有方法尚不能同时利用 rig 内几何与时序信息。
单目流式模型具备时序状态,但无法利用 rig 内几何。 CUT3R、STream3R 等方法逐帧处理视频并累积历史信息,但每次仅接收单张图像,且需自行估计相机参数。若将多目图像分别输入,同一时刻各视图之间的几何约束将被丢弃;若将其依次排列为视频帧,模型会将不同相机之间的视角差异误解为平台运动,每一步需要处理和缓存的特征量也会随相机数量成倍增加。
多视图模型能够利用 rig 内几何,但不保留时序状态。 另一类方法能够联合处理一组相机,例如团队前期工作 G2G,但每次仅估计两组观测之间的相对位姿。将其用于连续定位时,只能逐对串接,单步误差会沿轨迹不断累积。
StreamRig 旨在将二者统一于同一框架,需要解决三个问题:
计算开销:五台相机的特征量为单目的五倍,若全部写入历史缓存,长序列下的计算与显存开销难以承受; 因果约束:相对位姿估计受益于参考帧与当前帧的双向交互,而在线推理只能使用已获取的观测,参考帧无法访问其后的图像; 训练数据:真实多相机数据集通常只提供稀疏的激光雷达深度,且各数据集内的相机布局基本固定,难以从零训练专用模型。
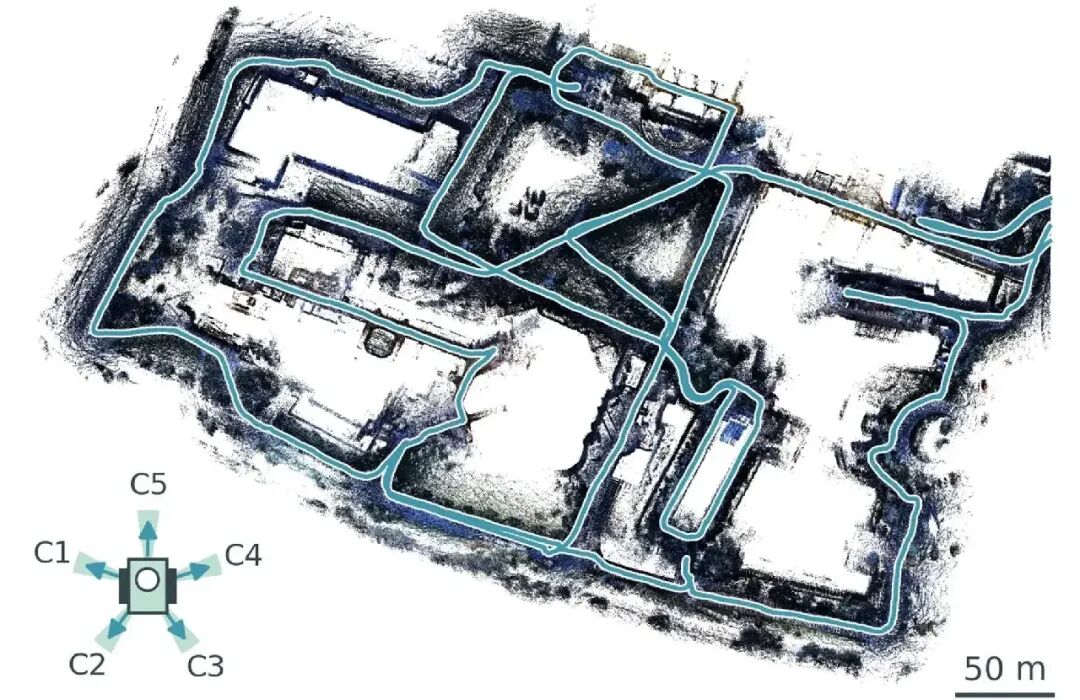 图 2 以 StreamRig 估计的位姿拼接激光雷达点云得到的校园局部地图,仅用于可视化;左下角为五台相机的朝向。
02 方法:冻结前端与轻量时序后端
 图 3 StreamRig 总体框架。冻结前端联合编码当前时刻的多视图观测,Rig-Resampler 压缩特征,CausalBridge 读取历史状态,位姿头输出位姿;图中另示两阶段训练与带周期重锚的流式推理。
StreamRig 采用 Freeze-and-Stream 框架:三维基础模型 MapAnything 保持冻结,其后接入三个可训练模块,共 7460 万参数,占系统总参数量的 11.7%。
多视图联合感知
每组同步图像到达时,冻结的 MapAnything 同时接收各视图图像、相机内参(焦距、主点等,换算为逐像素的射线方向)以及相机间外参(相对位置与朝向),并在网络内部进行跨视图信息交互。
标定信息仅在这一环节进入系统。后续可训练模块不再接收外参,也不对相机布局作任何假设,其输入特征已包含相机之间的几何关系。
特征压缩:Rig-Resampler
里程计所需的是约束平台运动的几何线索,而非逐像素的稠密重建。Rig-Resampler 将每台相机的 256 个图像 token(即图像分块后得到的特征向量)压缩为 16 个。五台相机的 token 数由 1280 降至 80,少于单张图像的原始 token 数。
各相机共享同一组可学习查询向量,因此每增加一台相机只增加 16 个 token,参数量不变。压缩后,历史中每组观测仅占 80 个 token,时序模块的注意力计算与缓存规模随之下降。
因果时序推理:CausalBridge
压缩后的特征输入 CausalBridge。该模块采用因果注意力,只读取当前及过去的观测,并将各层的键值(key-value)缓存下来,新观测到达时直接复用,无需重新计算历史。
StreamRig 并非估计相邻两帧之间的运动,而是将较早的一组观测固定为锚点,直接估计当前观测相对锚点的位姿。锚点与当前观测之间的历史观测保留在缓存中,为二者建立几何联系提供中间约束。
锚快照
这一设计需要处理因果约束与双向交互之间的矛盾。相对位姿估计中,参考帧与当前帧进行双向注意力交互,双方都能在对方的观测中寻找对应,估计精度更高;但锚点属于较早的观测,在因果约束下不能访问之后的图像。若允许锚点直接读取后续观测,缓存的历史状态将混入未来信息,缓存也需要反复重算。
StreamRig 的做法是:每组新观测到达时,复制一份锚点特征,称为锚快照(anchor snapshot)。锚快照仅与当前观测配对,二者在各层进行双向注意力交互。位姿输出后,锚快照即被丢弃,不写入缓存;锚点本身保持不变,已缓存的历史状态也不受影响。
由于锚快照只读取当前时刻已经获取的观测,这一过程并不违反因果性;各时间步使用各自独立的快照,彼此互不可见。
 图 4 锚快照示意:锚点保持固定,每一步复制一份与当前观测进行双向交互;历史缓存只读,未来观测不可见,快照用后即弃。
实验中,将锚快照替换为静态锚点后,NCLT、TartanGround 和 ZJH 上的平移漂移上升 9% 至 38%。此外,这一设计还带来两点结构上的便利。其一,引入双向交互后,整窗并行训练与逐组增量推理在数学上仍然等价。其二,当窗口内只有一组当前观测时,网络结构退化为两组观测的双向配对,与第一阶段预训练的形式一致,无需修改网络即可衔接训练。
周期重锚
若锚点始终不变,缓存将随序列持续增长。StreamRig 以 N 组观测为一个区段,每段末尾的观测作为下一段的锚点,清空缓存后重新开始,并将各段位姿依次复合得到完整轨迹。因此,无论序列多长,缓存中至多保存 N 组压缩特征,显存上界由此保证。
这一过程与 G2G 的逐对串接形式相近,区别在于每个区段内部保留了时序状态。在 NCLT 上,N 取 24 附近时精度最高,所需的串接次数远少于逐对串接。由于网络未使用时间位置编码,时序顺序仅由因果掩码表达,N 可在部署时调整,不必与训练窗口长度一致。
两阶段训练
对于训练数据不足的问题,由于前端保持冻结,三维感知能力直接继承自基础模型的预训练,无需用稀疏的激光雷达深度重新学习。需要解决的是使新增后端从冻结特征中回归平台运动。
第一阶段为组间重定位预训练,即估计两组图像之间的相对位姿。具体而言,沿单台相机的轨迹截取一段连续帧,构成一个虚拟 rig:每帧相当于组内的一台相机,帧间相对位姿作为外参。两组图像只要存在共视即可配对,并可跨时段、跨轨迹组合。由此,后端在接触真实 rig 之前,已学习过多样的相机布局与位移范围。
第二阶段以第一阶段权重初始化,在目标 rig 的连续序列上进行因果训练。两个阶段均仅使用相对位姿作为监督。
若跳过第一阶段直接训练,后端难以学到有效的运动估计:三个平台上的平移漂移增至完整方案的 4.6 至 14.9 倍,NCLT 上由 2.77% 升至 41.37%。
方法小结:冻结的基础模型联合编码同一时刻的多视图观测;每台相机压缩为 16 个 token,因果时序模块基于历史状态估计当前观测相对锚点的位姿;锚快照在满足因果约束的前提下实现锚点与当前观测的双向交互;周期重锚使缓存规模有界。
03 实验结果
实验涵盖四种构型差异较大的 rig:
NCLT:校园移动平台,五台环视相机,两条完整路线共 12.3 公里; TartanGround:仿真地面机器人,四台相机分别朝向四个方向,10 个未参与训练的场景; KITTI-360:城市自动驾驶,前向双目加两侧鱼眼相机; ZJH:团队自采的人形机器人数据,前向双目加两台斜向相机。
对比方法共 8 种:4 种单目流式方法(CUT3R、STream3R、LingBot-Map、HorizonStream)和 4 种多视图离线方法(Reloc3R、Rig3R、MapAnything、G2G 逐对串接),其中 CUT3R 与 STream3R 均在目标数据上进行了微调。下表为平移漂移(越低越好):
| 2.77% | |||
| 12.70% | |||
| 2.59% | |||
| 3.48% |
不输出公制尺度的方法(如 STream3R)已对整条轨迹进行尺度对齐;ZJH 上所有方法均进行尺度对齐。MapAnything 采用不提供真值的设定;论文另设直接输入真值相对位姿的参照,不参与排名。
在四个数据集上,StreamRig 的平移漂移与旋转漂移均为最低;绝对轨迹误差(ATE)在 NCLT、TartanGround 和 ZJH 上同样最低,仅在 KITTI-360 上高于经尺度对齐的 STream3R。
多相机联合感知的作用
在 KITTI-360 上,采用相同训练配置分别训练,仅改变输入前端的相机子集:
| 2.59% | 0.98 |
仅使用单目时,StreamRig 的精度低于 CUT3R;加入第二台前向相机后,平移漂移为 3.59%,与 CUT3R 相同。第二台相机几乎没有扩大视场,但两个已标定视图的联合感知能够直接提供深度信息,而单目只能依靠推断。进一步加入两台侧向相机、扩大视场后,各项指标均达到最优。
时序状态的作用
NCLT 是四个数据集中难度最高的,包含室内外切换、光照变化、运动模糊和行人干扰。G2G 逐对串接与 StreamRig 使用相同的图像、标定和冻结特征,但每一步只比较相邻两组观测。StreamRig 则直接估计当前观测相对于锚点(最多二十余组之前)的位姿,并以缓存的中间观测作为约束,所需的串接次数大幅减少。平移漂移由 6.08% 降至 2.77%,旋转漂移由 3.54 降至 1.39°/100 m,两条路线平均的 ATE 由 106.3 米降至 28.4 米。与缓存上一组特征的逐对串接相比,每步计算开销基本相当,因为时序模块本身的开销很小。
仿真到真机的零样本迁移
人形机器人步行时相机随步态持续晃动,单位行驶距离内的转向幅度也是四个平台中最大的。ZJH 的训练数据全部来自仿真:团队利用 3D Gaussian Splatting 重建了 25 个真实扫描的室内场景,并在其中生成 131 条行走轨迹。测试采用 3 个未见场景中的真机采集序列,总长约 360 米;需要训练的对比方法同样仅使用上述仿真数据。
真机的参考轨迹由 COLMAP 离线重建获得,其尺度无法事先与仿真对齐,因此每条序列对所有方法各进行一次尺度对齐。在此设置下,StreamRig 的平移漂移为 3.48%,次优的 CUT3R 为 4.61%;旋转漂移的差距更为明显,分别为 14.88 与 39.85°/100 m,降低约 63%。
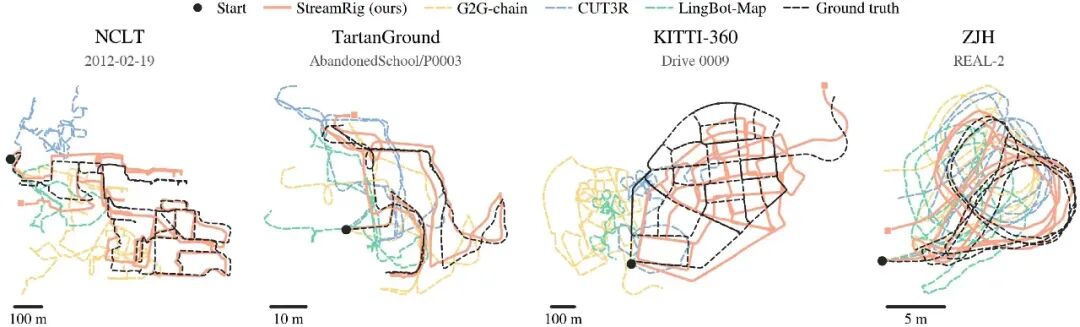 图 5 四个平台的代表性轨迹。为便于比较轨迹形状,各轨迹已对齐至同一起点与尺度。
推理效率
在同一张 RTX 4090 上,测量从输入图像到输出位姿的完整开销:
| 26.2 ms | 2.6 GiB |
BF16,batch size 为 1,连续 512 步。测速时 StreamRig 每组观测均重锚(N=2),前文 NCLT 精度结果对应 N=24;在长历史模式下保留 512 组历史(8 组以外每台相机仅保留 4 个特征),单步耗时为 26.4 ms。
26.2 毫秒中,冻结前端与特征压缩占 24.9 毫秒,时序模块与位姿头合计约 1.3 毫秒。计算开销主要来自图像感知,时序推理的额外开销约占 5%。
04 应用前景
StreamRig 可作为视觉里程计模块,为导航与建图提供连续位姿:
园区巡检、配送平台与无人车:适用于环视或双目加侧向相机等常见布局,推理阶段不依赖 IMU 或激光雷达,可直接输出公制尺度轨迹; 人形机器人:真机数据采集成本高,可先在重建的仿真场景中训练,再迁移到真机使用,但真机上的公制尺度仍需校准。
更换 rig 时,网络结构与前端均无需修改,只需在对应 rig 的数据上重新训练后端。若预先缓存前端特征,NCLT 模型的训练开销约为 48 GPU 小时(按 24 GB 显存的 RTX 4090 估算)。
目前的局限包括:每种 rig 需要单独训练;需要事先完成相机标定;ZJH 真机测试规模较小;推理开销仅在桌面级 GPU 上测量,尚未在机载平台上验证。
05 进一步分析:重锚间隔与训练跨度
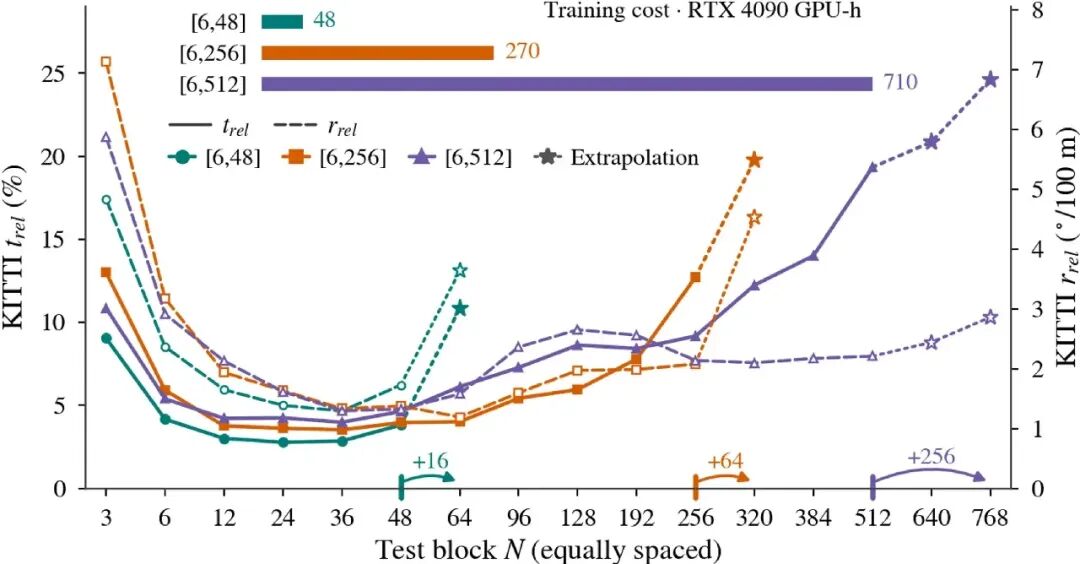 图 6 NCLT 上重锚间隔 N 与漂移的关系(纵轴 KITTI t_rel 为 KITTI 式相对平移漂移)。三种颜色对应三种训练窗口长度,星号为超出训练长度的测试点,顶部为估算的训练成本。
在 NCLT 上扫描重锚间隔 N,平移误差呈 U 形曲线。
间隔过短时,轨迹由大量短区段复合而成,每段都带有单次估计的误差;间隔过长时,锚点与当前观测可能已无共视区域,位移也超出训练时覆盖的范围,模型输出的位移会在训练最大位移附近饱和。标准配置下,N 取 24 左右时精度最高。
进一步将训练窗口由最长 48 组扩展至 256 组和 512 组,曲线右侧的上升点随之后移,可用的锚点距离增大,但最低误差并未降低,估算训练成本则由约 48 GPU 小时增至 270 和 710 GPU 小时。
此外,论文还有两点发现。
公制尺度监督的作用不限于确定尺度。 MapAnything 本身输出公制几何,StreamRig 因而直接采用公制位姿监督。若改用 STream3R 式的相对尺度损失,即便评测时再进行尺度对齐,NCLT 上的漂移仍由 2.77% 升至 6.87%,TartanGround 由 12.70% 升至 27.51%。
前端可替换。 将 MapAnything 替换为 Depth Anything 3 或 π³X,同一后端均能正常训练,重锚曲线也呈现相同的 U 形。三者中 MapAnything 效果最好;论文认为,这是由于它以逐像素射线的形式输入相机几何,最直接地向后端提供了 rig 内几何信息。
06 总结与启发
StreamRig 的实验结果给出了以下几点认识:
空间与时间可以分而治之。 同一时刻多视图之间的几何由冻结的基础模型一次性解算,时间维度只保留压缩后的状态。多视图提供深度与视场,时序状态减少串接误差,而时序推理每步仅需约 1 毫秒。 冻结基础模型时,后端需先经组间重定位预训练,再适配因果流式推理。 仅训练 11.7% 的参数、仅使用位姿监督即可取得上述结果,但若省略组间重定位预训练,漂移将增至 4.6 至 14.9 倍。 重锚间隔存在最优区间。 锚点过近时串接误差累积;过远时锚点与当前观测缺乏共视,位移也超出训练覆盖范围。延长训练窗口能扩大可用的锚点距离,但不能降低最低误差。
后续,团队计划利用压缩后的 rig 特征识别重访位置,将回环信息引入流式状态;并联合优化位姿与稠密几何,使累积的地图反过来约束后续定位。
本文仅做学术分享,如有侵权,请联系删文。
。


扫码添加微信,备注:姓名+方向+单位,邀请入群。