随着大语言模型应用从通用聊天向智能体场景快速渗透,推理服务的算力消耗增速已经远超训练阶段,成为AI基础设施成本的核心组成部分。行业预测显示,到2028年单智能体工作流的推理计算成本将提升5倍以上,2030年总词元处理量更是会达到当前的24倍,服务效率的提升直接决定了基础设施的投入规模。当前主流的大语言模型服务架构普遍采用Prefill-Decode(P/D)分离的设计,通过两个阶段的专业化配置和性能隔离提升资源利用率,但静态的算力分区机制已经难以适配动态波动的业务需求。

论文标题:Crossflow: Prefill–Decode Elasticity for Agentic LLM Serving
论文链接:https://arxiv.org/pdf/2609.27085
研究背景
Prefill阶段负责处理用户输入的提示词,属于计算密集型任务;Decode阶段负责逐词元生成输出,通常受限于内存带宽和KV缓存容量。把两个阶段分开部署到不同的资源池,可以分别为两个阶段定制适配的配置,同时避免长耗时的Prefill内核干扰Decode阶段的词元生成稳定性,进而提升整个集群的服务效率。
但是这种效率提升的前提是静态的算力分配,运营方需要提前确定Prefill和Decode节点的数量比例。但实际业务中两个阶段的需求波动非常频繁,完全无法和静态分区的节奏匹配。

静态P/D架构的效率困境
Meta团队通过大规模集群实测和公开智能体trace分析发现,静态P/D分区的架构存在显著的资源浪费问题。首先是分钟级的需求波动,某聊天场景下未缓存输入词元和输出词元的比值峰均比最高达到4.7倍,波动系数在0.14到0.34之间。即便把统计粒度放大到小时级,公开智能体trace的统计显示,单日之内的小时级需求比波动中位数达到24.5倍,90分位甚至接近100倍,且没有明显的昼夜规律,无法通过提前规划分区比例适配需求变化。

如果运营方按照95分位的需求为两个阶段分配算力,会导致最多17%的集群算力被闲置;如果降低配置比例,又会导致其中一个阶段出现请求排队,无法发挥集群的实际吞吐能力。而调整算力分区的成本非常高,重新分配一个节点的角色需要完成模型初始化、通信组搭建、缓存迁移、服务预热等步骤,单节点就需要数分钟到十数分钟不等,整个集群完成重分区甚至需要几十分钟,完全跟不上分钟级甚至秒级的需求波动。
即便解码节点有空闲算力,也不能直接把Prefill请求调度过去,因为可安全借出的算力并非线性值,和当前解码负载的形状、待调度Prefill请求的特征直接相关。实测显示,解码批次大小提升2.5倍时,算力争用率仅提升1.44倍,内存流量提升1.3倍,解码吞吐量提升1.74倍;而同批次下上下文长度从1K提升到82K时,内存流量几乎翻倍,算力利用率仅提升1.24倍,解码吞吐量反而下降10%。仅靠GPU利用率或者批次大小无法准确判断可借出的算力额度,甚至相同总负载下,不同的任务分布会导致SLO安全的Prefill吞吐量**差异达到11%-34%**。

Crossflow的核心设计
Crossflow的核心设计思路是在不改变P/D节点角色、保留两个阶段专业化配置和隔离优势的前提下,让两个阶段的算力边界变得弹性可调。解码节点仍然以Decode任务为第一优先级,仅在当前解码负载有足够SLO余量的时候,临时借出有限的算力处理Prefill请求,一旦解码负载上升就立即停止借出,不需要调整节点的角色和配置。

整个系统的运行逻辑分为四个核心模块:首先是Prefill压力检测模块,集群调度器不会仅通过排队请求数判断压力,而是会统计Prefill池的未完成未缓存词元总量,结合近期的处理速率计算预估等待时间,当等待时间超过阈值就触发算力借出机制,还会通过虚拟队列提前感知突发流量,避免调度滞后。
其次是解码节点的多资源租约机制,每个解码节点会根据当前运行的解码批次状态、剩余输出预估、KV缓存余量、待处理传输任务等信息,生成一个短期有效的多资源租约,包含可借出的算力、KV容量、传输带宽、溢出请求槽位等信息,租约有明确的版本号和过期时间,不会累积未使用的额度。节点还会通过在线反馈动态调整租约额度,如果借出Prefill后解码延迟仍然稳定在基线附近,就逐步提升借出额度,一旦解码延迟接近SLO阈值就立刻降低额度,出现SLO违约则直接将下一周期的租约设为0。
第三是形状感知的集群准入机制,调度器会为每个新会话分配固定的Prefill和Decode归属节点,分配时不仅会平衡负载,还会尽量把上下文长度相似的请求调度到同一个解码节点,让解码批次更加均质,提升可借出的算力空间。当Prefill出现压力时,调度器会为每个待处理请求比较默认路径和溢出路径的预估耗时,只有溢出路径的耗时更短才会调度,还会根据请求对解码批次的干扰程度排序,优先选择干扰最小的请求借出算力,同时设置集群层面的总借出上限,避免过度借出影响解码服务的整体稳定性。
最后是解码端的执行和故障恢复模块,解码节点执行Prefill任务前会重新校验本地资源状态,如果资源不足就暂停未执行的Prefill任务,出现故障时会自动将请求回退到默认的Prefill池处理,已经开始生成输出的请求则会保留在解码节点直到生成结束,避免出现重复输出或者缓存所有权冲突。
实测性能表现
Meta团队基于SGLang实现了Crossflow,并在GPT-OSS-120B和GLM-5.2两个模型上,使用公开TraceLab编码智能体trace和内部业务trace进行了全面测试。
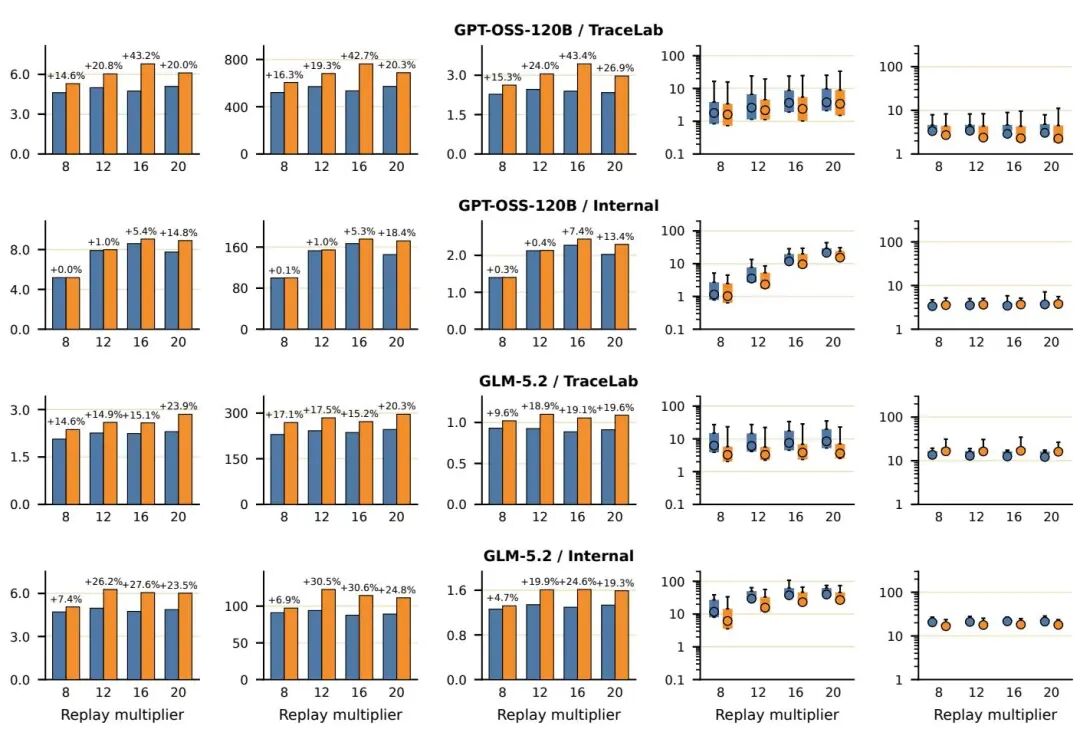
测试结果显示,在相同的硬件配置下,Crossflow相比静态P/D架构的几何平均词元吞吐量提升16.2%-17.4%,高负载场景下最高提升43.4%,而且所有测试点的平均首词元时间(TTFT)都出现了下降,下降幅度在10%到57.4%之间。词元间隔(ITL)的变化则和业务场景相关,部分场景下因为Prefill借出的轻微干扰会有小幅上升,最高上升34.3%,但也有场景因为排队压力缓解,词元间隔反而下降最多30.3%。
Crossflow的性能提升对不同的静态P/D分区比例都有很好的鲁棒性,测试覆盖了1P5D到4P2D的多种分区比例,除了解码资源极少的4P2D场景,其他场景下的吞吐量都有明显提升,其中2P4D配置下的Crossflow吞吐量甚至超过了3P3D配置的静态P/D架构,还不需要承担重分区带来的服务空闲期。
和现有同类方案相比,Crossflow的综合优势也非常明显。和动态路由Prefill的PPD方案相比,Crossflow的词元吞吐量提升最多43.4%,词元间隔仅为PPD的1/2到1/3,不会为了降低首词元时间牺牲解码的稳定性。和其他基于缓存亲和性、负载均衡的方案相比,Crossflow的吞吐量也有10%以上的领先。

硬件成本的对比更加直观,6台服务器部署的Crossflow的性能,静态P/D架构需要9台服务器才能接近,相当于节省了50%的硬件投入,即便用上9台服务器,静态P/D的输入和输出词元吞吐量仍然比Crossflow低2.7%和8.3%,词元间隔的表现也更差。
消融实验的结果显示,Crossflow的性能提升来自多个模块的协同作用,仅靠形状感知的路由只能带来最多4.6%的吞吐量提升,加上无差别的Prefill借出之后仍然比完整的Crossflow低8.6%-26%,形状感知的请求选择加上压力自适应的借出并发控制,才是性能提升的核心来源。
总结
Crossflow在保留P/D分离架构的专业化配置、性能隔离优势的基础上,通过弹性的算力租约机制解决了静态分区的资源浪费问题,不需要修改模型内核,也不需要调整集群的物理拓扑,就能显著提升大语言模型服务的吞吐量,降低首词元时间,尤其适合需求波动大、词元消耗高的智能体服务场景。该方案已经在Meta的内部集群进行了验证,相关实现也已经开源,可为大语言模型服务架构的优化提供新的思路。
> 本文由 AI 生成,机智流编辑部校对
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群