【内容目录】
1.AMD收购World Labs,买的是什么?
2.世界模型和今天的AI有何不同?
3.为什么说算力先落在云端?
4.中国玩家进展到哪一步?
5.云端和端侧的芯片生意分别怎么做?
6.价值链上谁在兑现、谁在验证?
摘要
82亿美元全股票收购World Labs,AMD买的是"下一代AI负载长什么样"的定义权——世界模型的训练与仿真几乎全部在云端,谁定义负载,谁就先写下一代芯片的规格。这笔交易的直接受益在云端,物理仿真和数据工厂推高GPU和整柜采购;端侧的机器人芯片不在收购的直接链条上,要等模型压缩和量产导入,是远期期权。
1. AMD收购World Labs,买的是什么?
2026年9月,AMD宣布以约82亿美元全股票收购李飞飞联合创办的World Labs,交易预计年底前完成。这家公司做的"世界模型",是让AI理解三维世界、预测"一个动作会带来什么结果"——这正是机器人和自动驾驶缺少的能力。
AMD买它的原因在算力上:训练和运行世界模型的计算量远大于今天的大语言模型,而且绝大部分发生在云端数据中心。谁提前知道这类负载长什么样,谁就能先把下一代GPU、显存和机架系统对准它——英伟达已经用CUDA、Cosmos(世界模型)、Isaac(仿真与机器人开发平台)搭好了这个平台,AMD买World Labs,买的就是这个"定义下一代负载"的入口。
沿着这个入口往下看,钱的兑现顺序是清楚的:先在云端——物理仿真和数据工厂直接推高GPU和整柜采购;后到端侧——机器人的"大脑"和"小脑"芯片要等模型压缩、量产导入才放量,今天全球人形机器人出货刚进入万台级,且科研、展示和数据采集仍占较高比例。所以这笔交易的直接受益在云端,端侧只是远期期权。

AMD买的是什么:定义下一代负载的入口
2. 世界模型和今天的AI有何不同?
四类世界模型对应不同算力位置
按任务链看:重建器生成世界状态,模拟器推进状态变化,规划器选择动作,VLA(视觉—语言—动作模型,看懂画面、听懂指令、直接输出机器动作)把动作落到设备。四类负载对应不同的算力位置和芯片需求。

四类世界模型,对应四个算力位置
3. 为什么说算力先落在云端?
这些负载的第一落点是云端:预训练、大规模仿真、数据工厂都发生在数据中心,采购重点从单卡峰值转向有效轨迹吞吐(单位时间产出多少条可用于训练的仿真轨迹)。这也是AMD收购World Labs的直接关联——World Labs的模型跑在哪里,下一代GPU、HBM和机架系统的需求定义就写在哪里。
平台之争:NVIDIA已连通,AMD补研究入口
掌握数据生成、仿真、训练、评估和部署入口的厂商,更容易影响模型格式、内核、编译器和芯片规格的走向。NVIDIA已把CUDA、Cosmos、Omniverse/Isaac(底层仿真与数字孪生)、GR00T(机器人基础模型)和Jetson(端侧部署)串成平台;AMD希望借World Labs把研究入口接入Instinct GPU、ROCm 开源软件栈和Helios机架。两家押注同一个预期:物理AI会把训练、仿真、评估和部署变成持续发生的基础设施支出。
4. 中国玩家进展到哪一步?
这条赛道上,国内玩家也在加速布局,从云端世界引擎、数据工厂、仿真适配和车型/设备导入切入,芯片绑定程度和商业阶段各有差异。数据工厂用仿真批量生成训练数据;真机回流是把真机数据送回云端再训练,形成越用越强的循环。
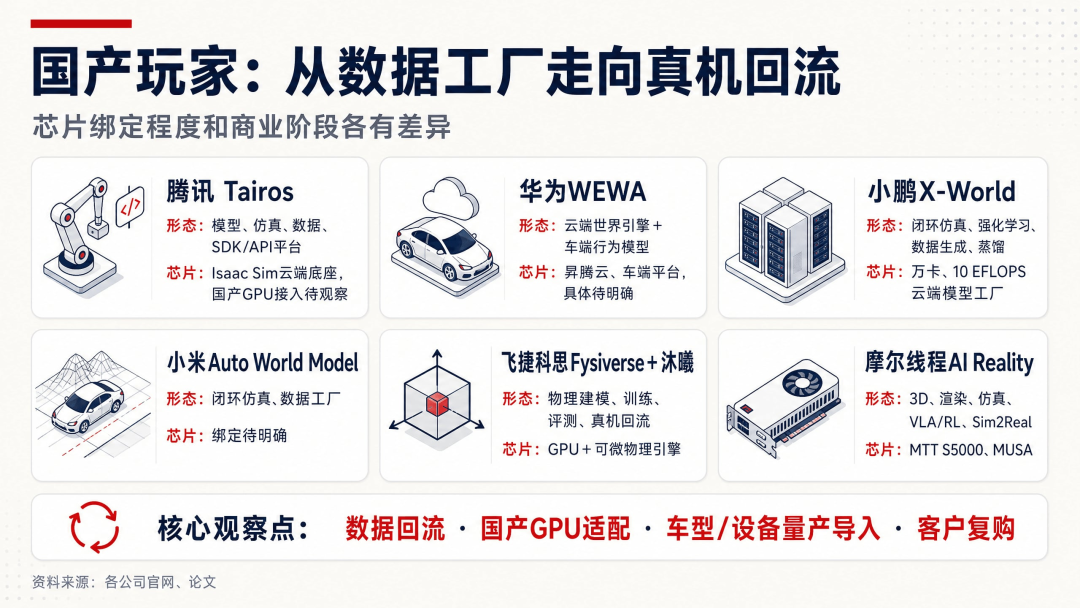
中国玩家:从数据工厂走向真机回流
5. 云端和端侧的芯片生意分别怎么做?
云端:尾延迟决定整机有效吞吐
3D场景、长视频和多步轨迹会保留大量中间状态,HBM之外还要看GPU、CPU、仿真引擎之间的数据复用效率。状态跨卡交换后,整机有效吞吐由机柜内GPU互连、拥塞和尾延迟决定——并行任务中最慢的一个拖住整体。开放互连方案还要经过整柜bring-up、通信库和真实负载验证,才能进入采购清单。
典型链路是:云端预训练和大规模仿真→集群策略搜索、评估和蒸馏(把大模型能力"浓缩"进小模型)→边缘更新与协同→车辆/机器人端短时规划和安全控制→真实轨迹回传。云端芯片看显存、集群吞吐和互连,端侧看延迟、功耗、传感器接口、安全和供货。
端侧:三层竞争格局与三条技术路线
端侧主控芯片可按算力档分层(本文为分析框架,非行业统一分档):小于50 TOPS档瑞芯微等AIoT厂较为活跃;50–200 TOPS档呈"智驾平移"混战,地平线系地瓜机器人、黑芝麻等车载芯片公司复用IP和客户平移过来;200 TOPS以上的高算力档目前由NVIDIA明显先发,Jetson Thor的2070 FP4 TFLOPS暂无同级对手。三条技术路线——GPU通用(英伟达)、NPU专用SoC(中国厂商)、Chiplet定制(北极雄芯)——3–5年内都不会出局。
价格带跨度是两个数量级:入门的瑞芯微RK3588单片数十美元,高端的Jetson Thor量产模组2,999–4,999美元(T4000/T5000,1KU+建议价)。进入车辆和机器人后,低延迟、功耗、传感器I/O、实时系统和安全降级比TOPS更接近design-in的真实门槛——芯片在设计阶段就被车企或设备商选定,一旦选定通常数年不换。客户采购对象因此从单张GPU,变成显存、互连、仿真后端、软件工具链和端侧迁移能力组成的整体平台。

端侧芯片:三层格局,三条路线
6. 价值链上谁在兑现、谁在验证?
价值链四层,利润池在运控与高端"大脑"
价值链自上而下是整机、模型与软件、"大脑"硬件、运控与执行件四层。从已披露上市公司样本看,部分电机驱动、控制和执行器企业毛利率较高,运控与执行件环节大致处于30–50%区间;但这不能推成整个环节的统一利润率;整机层头部放量但多数亏损;"大脑"硬件呈英伟达守高端、中国SoC抢中低端的二元结构。
有机构测算,人形机器人半导体成本占BOM约20%,其中SoC与存储合计占67%;按2030年整机均价10–15万元、半导体占比15–20%推算,单机半导体价值量约1.5–3万元。

价值链四层:利润池在运控与高端"大脑"
出货是真实的,但商业化闭环没走完
2026H1全球人形机器人出货1.9–2.5万台(IDC口径接近2.5万台、同比+432.1%;Counterpoint口径突破2.2万台;SAG口径约1.9万台),中国厂商占77.9%以上,智元与宇树合计份额约75%。但IDC的场景结构显示,科研教育、表演展示和政府数采中心合计占69%,出货增长仍有较大部分处于验证、展示和数据基础设施阶段;当前订单以试点与基建类项目为主,首批项目尚未走完"试点—续约"周期,头部本体厂的续约率与复购订单占比均无公开披露,这是需求侧最大的证据缺口。
兑现顺序:云端先行,运控随后,高端"大脑"最后
云端训练算力已在兑现(Figure等头部玩家的大额GPU采购已在发生);运控与性价比主控的公司整体收入已进入报表——瑞芯微2026H1收入28.77亿元(+40.6%)、峰岹科技收入5.61亿元(+49.6%);高端"大脑"和端侧VLA仍在量产验证期。"云端算力增长不自动转化为端侧芯片收入"在具身智能链上同样成立。
市场速览:规模阶梯与三条产业曲线
现金流曲线——控制、连接、视觉、电源和成熟主控(全志MR536、瑞芯微RK3588/RK3576、兆易创新MCU等),依托清洁、割草、服务和工业设备已经出货;升级曲线——主控+AI协处理器和车规平台(瑞芯微RK182X、地瓜S100/S600、黑芝麻A2000/C1200等),正从"具备计算能力"走向在具体机器人中形成供货关系;期权曲线——专用人形大脑、3D DRAM、Chiplet和高端模组(Jetson Thor、Tesla AI5/AI6等),价值弹性最高但商业证据待补。成熟度最高的未必是最像"大脑"的芯片,而是已经在真实设备中稳定供货、能被第二个客户复用、并在财务或采购文件中找到收入位置的芯片。
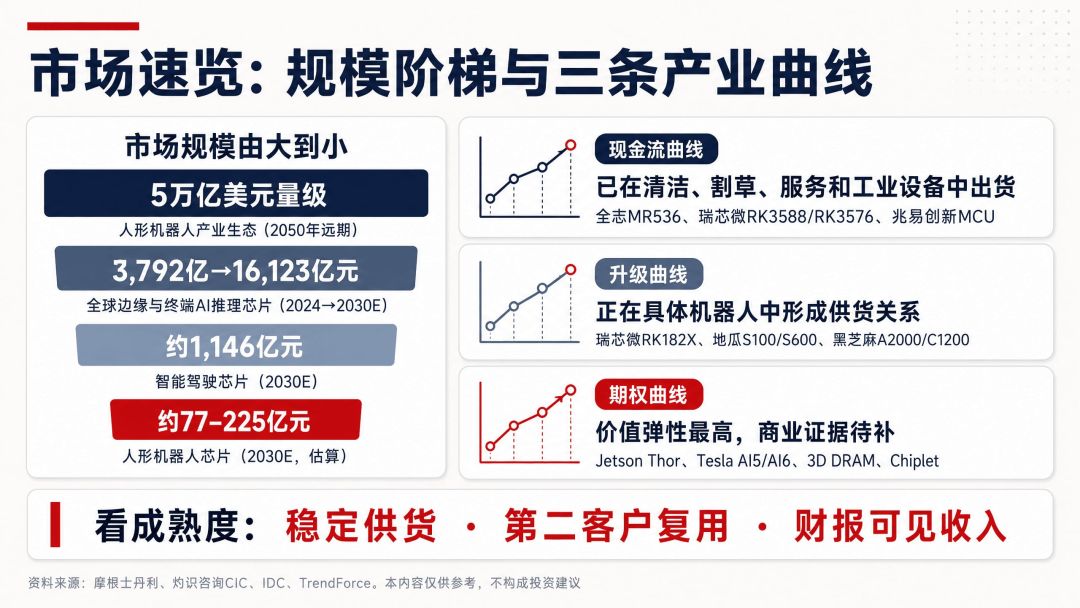
市场速览:规模阶梯与三条产业曲线
附录:来源表:(上下滑动可查看):