新智元报道
新智元报道

OpenAI公开722篇由AI撰写的数学与理论计算机稿件之后,丹麦奥尔堡大学AI安全实验室Qiongxiu Li发起的开源项目On Whose Shoulders 《巨人之肩》,对这批AI稿件的全部相关文献开展了逐条核对与系统性溯源分析。
结果是:跨越5个多世纪,11,067部人类著作,约9,600位数学家,其中114位是菲尔兹奖、阿贝尔奖或沃尔夫奖得主。
这类工作常被写成「AI解决了某某难题」。
这句话其实只说了一半,另一半是:AI是基于什么工作解决的。
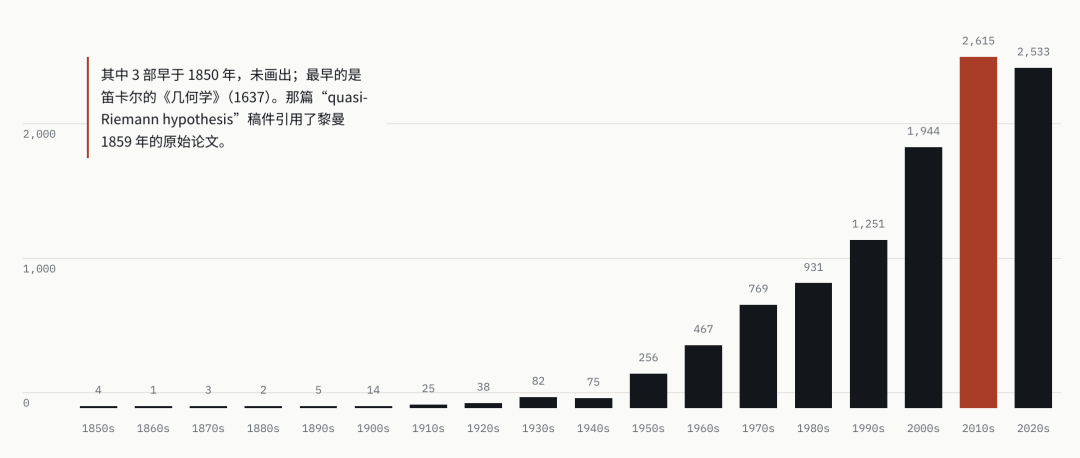
大多数作者不是历史书里的名字,而是今天仍活跃的数学与理论计算机科学家。
从原句看,AI稿件是把这些科学家成果当作工具来用的:
在算术几何里,一篇稿件「由[Fargues–Scholze 2024]」把某些向量丛与p进局部系统对应起来,这是Laurent Fargues与舒尔茨的工作。
在双有理几何里,有的稿件沿用Caucher Birkar与一位合作者近期的策略,有的应用Birkar关于有界补的定理;还有的建立在Osamu Fujino的归纳法,以及Omprokash Das、Christopher Hacon与Mihai Păun的工作之上。
在概率论里,稿件依靠Hugo Duminil-Copin等人对随机簇模型的临界穿越估计,以及Bertrand Duplantier、Jason Miller与Scott Sheffield的「树的配对」(mating of trees)定理。
一个图论反例用了洛瓦斯与Balázs Szegedy的图极限采样构造;一个组合反例沿用了布尔甘、Nets Katz与陶哲轩的和积方法。
一篇关于自旋玻璃的稿件,用的是Michel Talagrand的空腔方法。
一个Ricci流论证用了佩雷尔曼2002年的熵单调性;一个Hodge理论论证用了德利涅的半单性论证。
AI的每个领域成果,各自站在了一群人身上:
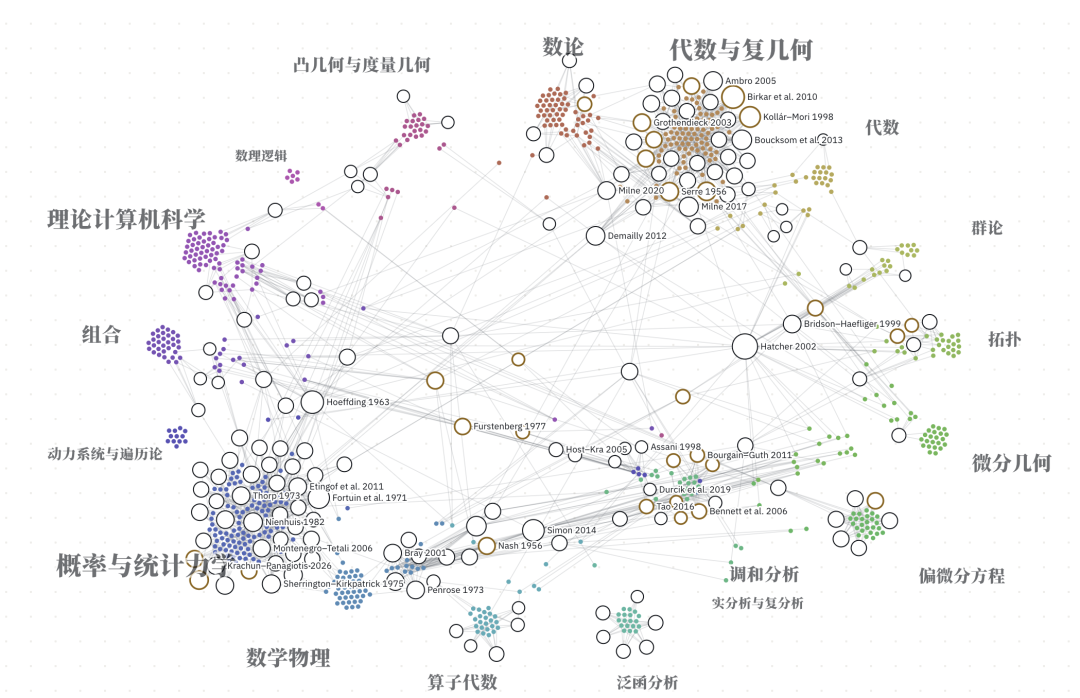
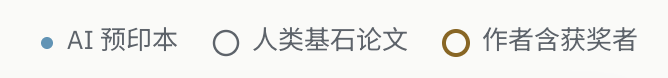
每个小点是一篇AI预印本,按学科聚成「大陆」;带圈的大点是被多篇预印本共同引用的人类论文,大小表示被引篇数,位置落在引用它的论文之间。
巨人之肩项目:seafill.info/Shoulders
数据来源:github.com/openai/math

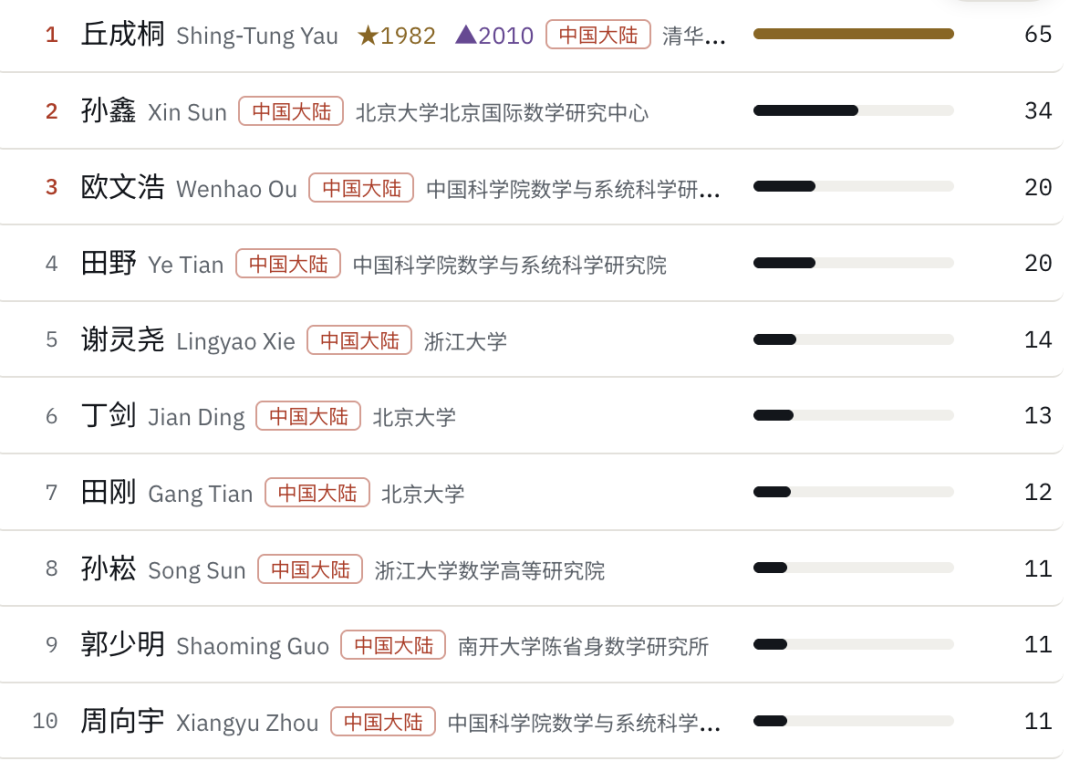
部分在中国大陆活跃的数学家被引用工作数目
如丘成桐,孙鑫,欧文浩,田野,谢灵尧,丁剑,田刚,孙崧,郭少明,周向宇等人工作被OpenAI反复使用
华人数学家在这场接力里:
丘成桐1976年证明卡拉比猜想的工作,被10多篇稿件引用。
陈省身1944年对高斯–博内公式的内蕴证明,以及他与James Simons 1974年提出的陈–西蒙斯形式,各被三篇工作用到;其中一篇写道「我们使用陈–西蒙斯超渡泛函」。还有两篇工作研究的仿射极大曲面问题,正是陈省身1979年提出的。
在最近大热的调和分析里,OpenAI的四维Kakeya稿件正是建立在王虹与Joshua Zahl 2025年的三维Kakeya挂谷猜想的证明之上,证明中的Bourgain条件还引用了王虹、郭少明、张瑞祥2024年工作。在与之紧密相连的Bochner–Riesz问题上,用到了郭少明、Changkeun Oh、王虹、Shukun Wu、张瑞祥人2025年的工作和陶哲轩2003年的双线性限制估计,并列作为波包方法的出处。
一篇关于丰度猜想的稿件,沿用了许晨阳与Lei Zhang的叶状结构判据。一篇关于硬球气体的稿件,引入了邓煜、Zaher Hani与Xiao Ma从粒子动力学推导Boltzmann方程的估计。
田刚与John Morgan关于Ricci流与庞加莱猜想的专著,丁剑与Allan Sly、Nike Sun对可满足性猜想的证明,以及杨振宁与李政道、黄克孙1957年关于硬球玻色气体的论文,也都在参考文献之中...
上述情况也适用于其它科学发现。OpenAI的纳维-斯托克斯方程论文从欧拉于1757年提出的方程出发,然后回顾了Leray于1934年提出的弱解以及Caffarelli、Kohn和Nirenberg的部分正则性定理。谷歌AlphaFold基于结构生物学家数十年来逐一解析的蛋白质结构进行训练;其前提可以追溯到Anfinsen于1973年的发表,即蛋白质的序列决定了其形状。

对于一个做出科学突破的模型(GPT, Claude等)来说,工程师造出机器:架构、训练代码、数据管线、算力。科学家提供它可学习的高质量内容,也决定它朝哪里去。预训练。模型学的是根据前文预测下一个词。
有一篇AI稿件里写着:「由射影直线上向量丛的分裂定理,E是线丛的直和」。这个事实不是模型发现的。
1957年格罗滕迪克给出了它的经典形式,此后数学家在论文、教材和讲义里一遍遍写下这一步。
科学家的直觉,是知道下一步该用哪个引理;模型的直觉,是从人类写下的千千万万个「下一步」里估计出来的概率。监督微调。模型在一批精选的推理链上学习「怎样一步步解题」。这些推理链有的由人写成,有的由模型合成;但合成的也从人出的题目和指令出发,由人设计的检验决定去留。

最后强化学习和推理时采样,只能强化或找到模型本来就能采样到的东西
强化学习与推理时采样。模型对一道题尝试许多次,验证器留下做对的。这靠的是采样:如果模型几乎从不写出正确的证明,奖励全是零,就无从学起。
让「做对」从几乎没有变成偶尔出现的,很大程度上是此前训练数据的质量。简单地说:工程师让学习成为可能,而可学的内容,很大一部分来自不同领域科学家。
预训练和监督微调,给了模型直觉和推理的方式,但前沿的新结果,靠的是大规模的采样:训练时的强化学习,推理时的搜索和agent。它们的共同点是,让模型对一个问题做许多次尝试(rollout),再由验证器决定哪些算数。
成功的轨迹,又可以成为下一轮的训练数据。但要让这种「尝试-验证」的循环真正转化为模型能力的提升,关键在于信号的质量。梯度决定模型从一个样本中学到什么,而它的好坏取决于背后的信号。
很大一部分强信号来自科学家:严谨的证明,让训练有清晰的下一步可学;挑选得当的题目,让奖励不至于全是零或全是一;精确的验证器,保证信号指向正确的方向。无论采样发生在训练时还是推理时,科学家都可以处在这个循环的三个位置上。
(1)挑选问题。训练在「刚好够得着」的问题上学得效率最高,推理时的算力也最值得花在这样的问题上。好的问题为下一轮模型训练留下好的种子,平庸的题目只留下平庸的种子。挑出这样的问题,则需要科学家所说的taste。比如,埃尔德什、丘成桐、希尔伯特的问题清单,做的正是这件事。
(2)定义什么算正确。训练时,验证器决定奖励;推理时,它决定许多次尝试里留下哪一个。验证标准写得松,模型训练就会钻空子。数学之所以最先能成为试验场,是因为数学家早已把「证明」定义得极为精确。
(3)评判结果。10月7日,OpenAI在发现一处符号错误后撤回了3篇稿件,并修订了另外14篇。他们的仓库说明也写道,部分未经形式化的结果「可能有问题」。哪些结果成立,哪些重要,哪些方向值得投入下一轮算力,这些判断仍是科学共同体的工作。
所以,AI再强大,也需要驾驶员。这好比开采石油:钻机再强,也要有地质学家决定在哪里下钻,判断打上来的是不是油。在下面这个循环里,科学家挑选问题、定义正确、评判结果;AI则以人无法企及的规模去尝试。

科学家挑选问题、定义正确、评判结果;AI以人无法企及的规模去尝试。

假设科学家真的退后一步,会发生什么?
模型仍然会采样,仍然会尝试。但它会被指向越来越窄的问题,用越来越松的验证器筛选答案,用越来越单一的数据塑造自己的采样。没有好的仪器,采样就碰不到新的知识。更麻烦的是,在缺少外部检验的情况下,一个主要靠自己的输出喂养的模型会逐渐退化。
已有研究发现,模型如果反复用模型生成的数据训练,会丢失分布中稀少的部分,逐渐退化。新的问题、新的想法、新的实验数据,以及检验它们的仪器,今天仍然需要科学家的参与:提出问题,设计实验,判断结果。未来,一部分新数据可能来自AI与物理世界之间的闭环,比如自动化实验室;但做什么实验、测得准不准、结果意味着什么,仍然需要领域科学家参与。
所以,「AI都能解决,科学家不再被需要」这句话,不只是关于科学家的。它会影响社会的激励流向哪里,也会影响年轻人是否还愿意投身科学之中。这两件事最终都会回到模型身上:这样的人少了,新的问题就少了,验证器也少了,梯度信号自然就弱了。

数千年来,人类是唯一从事科学研究的智慧生命,许多发现,都是科学家们毕生的努力的结果。
如今,超级智能正触及科学的前沿,它能证明的、能发现的、能预测的,只会越来越多。
但每一次突破,都建立在那些光芒之上:人类最高的智慧、最深的孤独、最漫长的努力。
科学家是连接人类知识与AI的桥梁。谨以此向人工智能时代的科学家们致敬——他们的名字,应当与建立在他们工作之上的成果连在一起。
SeaFill人工智能小组《巨人之肩》研究项目,由丹麦奥尔堡大学AI安全实验室助理教授Qiongxiu Li发起。
参考资料:
seafill.info/Shoulders
编辑:LRST