10月12日,成立三年多的蓝芯算力披露完成B轮系列融资,合计接近20亿元,老股东深创投、华控基金、隆湫资本继续追加,兆易创新、苏创投、同创伟业、建银国际等新机构入局。
公司2026年2月流片点亮48核RISC-V芯片LX500,7月搭载该芯片的联想问天WR5219 G5服务器进入量产,并声称拿到联想、中国移动、腾讯云超过20万片订单。一家年轻芯片公司,直接选了服务器CPU这个最难的市场。
一家成立刚三年、芯片才流片点亮没多久的RISC-V公司,拿了接近20亿融资,还挂着联想20万片订单。

Part 1
RISC-V企业大部分先从微控制器、嵌入式芯片做起,软件栈简单,指令扩展好调。蓝芯算力反过来,成立就奔着服务器去。

这步棋能下,靠的是人。创始人卢山,清华自动化本科,波士顿大学电气与计算机工程博士,干过英特尔、高通,2019年进字节跳动圣迭戈芯片团队做RISC-V和服务器芯片,2023年5月出来创业。
CTO贾新霞之前在海思、高通。这支队伍有高性能CPU和服务器SoC的底子,所以敢直接碰服务器。

LX500这颗芯片,48核RISC-V,片内集成75 TOPS INT8的AI引擎,支持DDR5、PCIe 5.0、CXL 2.0。它有两个动作:
◎ 一是直接进服务器,没走MCU到高性能计算的弯路;
◎ 二是把通用CPU核和专用AI引擎塞进一颗芯片,想让企业跑一部分AI推理时少买独立加速卡。
说白了,它赌的是CPU加AI在一颗里能省客户的钱和电。
服务器客户买的是一整套能部署的系统。主板、固件、内存兼容、散热、故障诊断、售后,哪一样都影响采购。蓝芯算力自己从头做这些,周期太长。
联想进来,把这件事接了一大半过去。2026年5月,蓝芯算力和中国移动云能力中心完成RISC-V处理器和BC-LINUX的适配。
7月,搭载LX500的联想问天WR5219 G5在世界人工智能大会上亮相,联想随后和它成立RISC-V加AI智通融合CPU联合创新实验室,服务器进入量产阶段。
借联想的整机开发和交付体系,蓝芯算力少走了从芯片到完整服务器那一段最重的路。这一点的分量,比流片成功四个字重得多。
公司披露已经从联想、中国移动、腾讯云拿到超过20万片订单,和世纪互联也建了合作。20亿融资、联想量产、20万片订单,凑成了目前最硬的商业进展。
订单的实际交付数量、收入金额、履约节奏,还没完整公开。联想服务器进入量产,和蓝芯算力已经交付几十万片,是两件事。20万片到底交了多少、多少钱、分几年确认收入,直接决定未来几年的收入预测。
本轮投资方里的兆易创新也有意思。它2019年就出了基于RISC-V的GD32VF103微控制器,是国内较早做RISC-V商业产品的。
这次砸钱进蓝芯算力,等于用资本去碰服务器级RISC-V。双方会不会在存储、控制器上进一步合作,现在还没有足够明确的公开信息。
Part 2
过去几年AI服务器的钱都砸在GPU上。大模型训练要海量矩阵乘法,GPU的并行和带宽扛得住。CPU负责系统、数据准备、调度、通信这些通用活。

智能体起来之后,CPU的活变重了。
一个企业智能体接了任务,可能要查数据库、读文档、跑Python、调外部工具,再反复请大模型。
GPU算神经网络,但查库、跑码、管容器还是CPU的事。模型推理很快、别的环节慢,加GPU也救不了整体延迟。
英伟达2026年推Vera CPU,88个自研Olympus核,配LPDDR5X,带宽1.2TB/s,强调单线程、分支、数据访问和并发,就是冲着代码执行、任务编排、数据处理去的。
蓝芯算力走另一条:32个高性能核加16个高能效核,再塞75 TOPS AI引擎,做成融合SoC。
传统做法是CPU配独立GPU或加速卡,两张卡之间要搬数据、调驱动。LX500把AI引擎放进CPU芯片,能少搬一点、少调度一点。
对推理规模小、请求频繁、CPU预处理占比高的应用,集成方案有便宜可占。
比如金融实时风控:收交易、查账户、读特征、再调模型,模型适中、片内引擎跑得动,CPU和AI贴着配合,单次延迟能压低,还省了额外加速卡的采购。
75 TOPS跑万亿参数
LX500最抓眼球的宣传,是片内AI引擎跑通了Kimi K2.6万亿参数模型的128K长上下文量化推理,还适配了Qwen3.6-35B。一颗只有75 TOPS峰值的服务器CPU,模型规模看着很大。
1万亿参数模型,只算权重:FP16约2TB,INT8约1TB,INT4约500GB,这还没算量化元数据、KV Cache、运行缓冲和操作系统。即使用4bit,权重理论规模也到500GB。
LX500支持DDR5加CXL 2.0,最大寻址能力号称2TB,给了装大模型的容量条件。

自回归模型逐Token生成,内存带宽经常卡脖子。假设生成时反复读约500GB权重,有效带宽跟不上,计算单元闲着也出不了速度。
真实模型会用专家激活、缓存、分层加载优化访存,不能直接拿500GB除带宽算速度,但这个量级已经能解释:大容量内存不等于高性能推理。GPU和专用加速器堆HBM,就是为了持续给计算单元喂高带宽数据。
128K长上下文还会给KV Cache和注意力计算加额外内存。 真要比,至少得给定模型版本、量化精度、输入输出长度、并发数和整机配置,再亮首Token延迟、输出速度、功耗和单位Token成本。
单位Token成本最实在,一台机器便宜,每秒只出几个Token,摊下来服务成本可能反而高。

很多金融、工业、能源、政企客户跑的是固定任务小模型,要的是稳、采购价低、耗电少、好维护,日常推理量未必大。LX500若能在这些活上给够延迟和吞吐,又少买加速卡,就有机会。
RISC-V进服务器,对手不轻松,20亿要算TCO
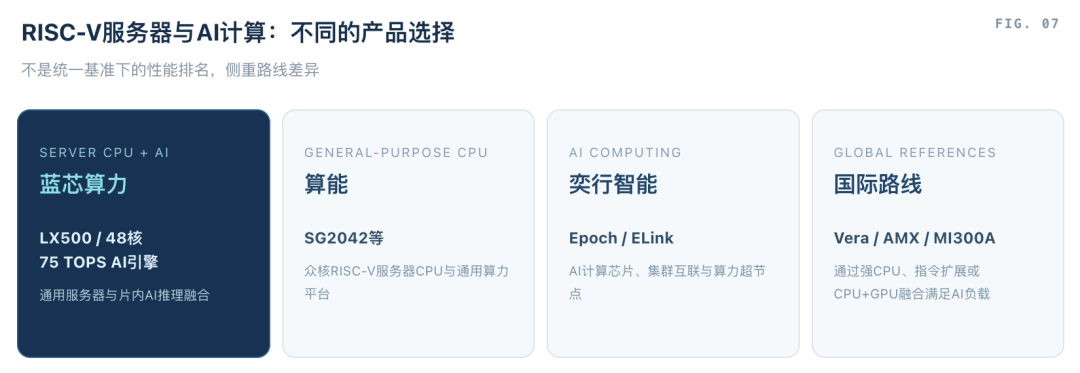
中国RISC-V早越过MCU阶段。算能2023年推64核SG2042服务器处理器,2026年奕行智能发基于Epoch和ELink的RISC-V AI超节点。算能走众核通用,蓝芯算力走CPU加AI融合,奕行智能冲AI集群互联。

RISC-V开放指令集给了设计空间,但也加了软件兼容的麻烦。
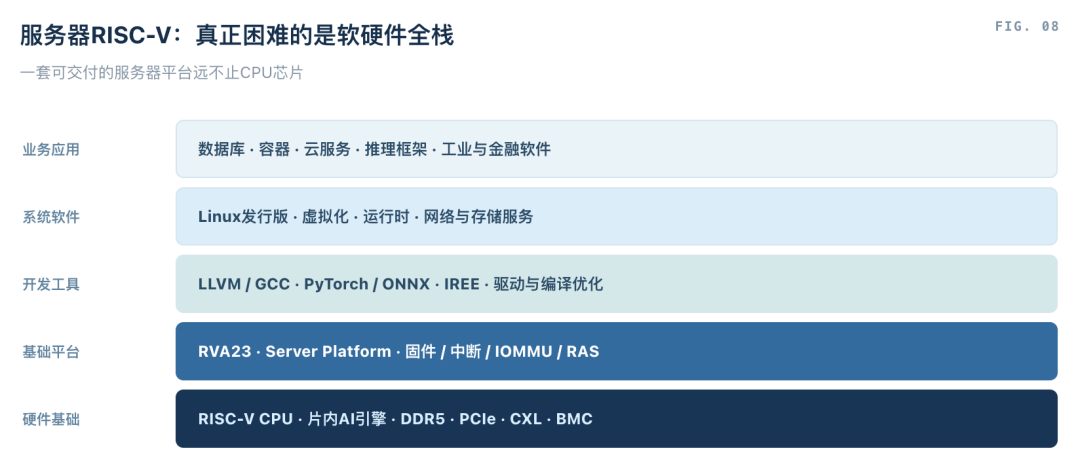
2024年10月RVA23规范、2026年5月RISC-V服务器平台规范1.0,都是为了压不同实现的差异。但规范发布只是起点。
企业客户的数据库、存储、商业软件、安全组件,很多是针对x86或Arm优化过的,没有RISC-V版本就得改代码、重测性能。
蓝芯算力披露支持PyTorch、TensorFlow、ONNX、LLVM、IREE,解决的是模型和编译基础适配,AI引擎的算子覆盖、量化、内存调度、推理运行时才是硬仗。
BIOS、BMC、OS、驱动、虚拟化、RAS可靠性,每代芯片都要接着维护,投入以年计。
近20亿B轮,给研发、软件生态和规模交付提供了子弹。
客户算的是TCO,总体拥有成本。采购价只是一部分,功耗、散热、机房、软件迁移、维护、升级,都进三到五年账本。
AI应用还要算完成同样推理的总费用。融合服务器初始价低、耗电少,但推理性能不够、得铺更多台,成本优势就缩了。反过来,企业AI量不大、独立GPU长期空转,用集成引擎的服务器反而对口。
蓝芯算力这轮融资,踩在RISC-V服务器开始出实际产品的节点上。算能出了众核处理器,奕行智能从AI超节点切入,蓝芯算力用48核融合CPU加联想整机站稳一块。
英伟达Vera、英特尔至强AMX、AMD的CPU加GPU融合,也在顺着AI新负载改服务器架构。
AI负责算,智能体还要执行工具、访数据、管任务,CPU性能、专用加速和内存系统的配比,一起决定AI基础设施的效率。蓝芯算力想用LX500在其中找个新位置,工程进展和产业支持都拿到了。