过去两年,世界模型几乎被视频生成模型牵着走。我们默认了一个等式:视频模型越强,世界模型越强,机器人越会规划。但这个等式隐含了一个危险的偷换:把“预测未来观测”等同于“理解世界”。视频模型的目标,是在像素空间里生成视觉上合理的未来帧;机器人却必须在三维空间里回答:如果我这样动,物体会怎样移动、旋转、接触、受力。前者是观测拟合,后者是干预预测。视频越真,不等于动作后果越对。
问题在于,机器人交互发生在三维物理空间,图像只是视角相关的二维投影。像素误差与物理误差不是线性、稳定映射,因此视频 WAM 很容易错位:未来视频逼真,物理位移却可能错误。比如,机械臂看到杯柄在图像中偏了 6 个像素,若杯柄在 0.6 米处,这可能只是 3 毫米;若在 1.8 米处,却可能是 9 毫米。模型觉得画面几乎没变,夹爪却可能从杯柄边缘擦过。

要解决这种错位,不能只在视频生成模型上打补丁,而要把建模重心从二维画面转向三维物理空间。跨维智能联合香港中文大学(深圳)、佛山大学、中山大学与华南理工大学提出了 3D 原生世界动作模型 UNITAS。据团队介绍,UNITAS 是全球首个机器人任务原生 3D 世界模型,它不再把未来视频当作核心中间表示,而是直接在统一的三维坐标系中建模机器人动作与环境变化。目前,UNITAS 已开源,相关代码与使用说明已在 GitHub 项目仓库公开(Github:DexForce/UNITAS)。
UNITAS 要回答两个问题:机器人该怎么动?动作会让周围物体发生怎样的变化?它把这两个问题放进同一个三维坐标系:一方面,直接生成机器人可执行的动作;另一方面,根据给定动作预测周围物体的运动。这样,世界模型的预测不再停留在“下一帧像什么”,而是落到具体的位置、方向与距离上。
那么,这套面向机器人操作的三维建模方式,具体是如何实现的?UNITAS 的选择很明确:不做视频生成模型的附属,而是做 3D 原生。这既是它的技术路线,也是它的破局点。
一、不做视频附属:UNITAS 的 3D 原生破局
所谓“不做视频附属模型”,是指不再把未来视频作为核心中间表示;所谓“3D 原生”,是指直接在统一的度量三维坐标系中建模机器人动作与环境变化。当前大量 VLA 与视频世界动作模型共享同一个隐含假设:机器人可以在二维像素空间里完成决策。但像素距离不等于物理距离,像素变化也不等于物理位移。UNITAS 的破局点,正是从这一错位出发。其核心思想可以浓缩成一句话:把观测、动作和场景变化,统一建模在同一个度量 3D 坐标系。

为此,UNITAS 重新定义了世界动作建模问题:不再将未来视频作为核心中间表示,而是直接在统一的度量三维坐标系中建模机器人动作与环境变化。给定语言指令和当前观测,模型预测三类输出:动作流(Action Flow),描述机器人夹爪或人类手部关键点的三维运动轨迹;动作块(Action Chunk),表示机器人可直接执行的末端动作命令;场景流(Scene Flow),描述环境中三维点在机器人动作影响下的位移轨迹。三者并非依次生成:动作流与动作块可以并行预测,场景流则以生成或外部提供的动作流为条件,预测环境接下来如何变化。
在实际运行中,UNITAS 支持两种模式。策略模式(Policy Mode)直接根据观测、指令及机器人当前状态生成可执行动作块,跳过未来动作流和场景流的生成,以降低推理延迟;模拟器模式(Simulator Mode)则在给定动作流的条件下预测场景变化,用于建模动作可能产生的物理后果。两种模式共享统一的三维空间表示,但可以采用不同的推理路径,从而兼顾机器人实时控制与环境动态预测。
因此,UNITAS 更像一套“空间操作系统”,而不是更强的视频生成器。核心变化是:把决策变量从“未来像素”改成“世界坐标系中的物理位移”。这样做让策略和模拟器共享同一个度量 3D 表示:相机视角被归一化,坐标系混乱被统一,不同机器人本体开始共享策略入口。
二、空间、本体、时间:统一三维世界的三把钥匙
但共享同一个度量 3D 表示不会自动发生,它需要同时在空间、本体和时间三个层面落地:空间上,视觉 token 必须知道自己对应世界中的哪个点;本体上,人类手和机器人夹爪必须落到同一套动作表示;时间上,不同频率和延迟的信号必须对齐到统一的物理时间。为此,UNITAS 引入三个关键技术:世界对齐的 3D 位置嵌入、动作流和物理时间分词器。
第一,世界对齐的 3D 位置嵌入。
每个视觉 token 都加上世界坐标位置嵌入。有深度时,利用相机内参和外参,把像素反投影到世界坐标;没有深度时,沿相机射线从 0.1 到 2.0 米采样 64 个候选深度,用 patch 特征给它们打分,再加权组合成位置嵌入。
论文在 LIBERO-Plus 上做了测试:无深度输入的路由 PE 达到 84.43%,真值深度 PE 是 84.68%,只差 0.25 个百分点。这说明,深度信息可以被蒸馏进 RGB 条件位置特征里。
第二,动作流:让人类手和机器人夹爪说同一种语言。
跨本体学习的核心困难之一,是不同机器人采用不同的动作表示方式。UNITAS 通过 Action Flow 将这些不同本体的运动转换为三维点轨迹。
对于机器人夹爪,论文从 URDF 定义的夹爪几何中采样 20 个点,并通过正向运动学计算这些点在未来时刻的位置。对于人类手部,则使用 21 个 MANO 手部关键点表示动作。这样,机器人夹爪和人类手部不必具有相同关节结构,也可以通过空间点的运动建立统一的动作表示。

这张原图展示了仿真机器人、真实机器人与人类手部数据在点轨迹表示上的统一方式。其中,紫色轨迹对应夹爪或手部运动,黄色至蓝色轨迹表示场景中三维点的变化。这种表示的重要性在于:模型学习的不再只是某种机器人专属的关节控制序列,而是不同交互体在空间中如何运动。
不过,统一的点轨迹并不意味着所有机器人都能直接共用相同的底层控制指令。将跨本体运动表示转换为可执行动作,仍然需要结合机器人状态、运动学结构及控制接口。
第三,物理时间轨迹分词器:一条轨迹一个 token。
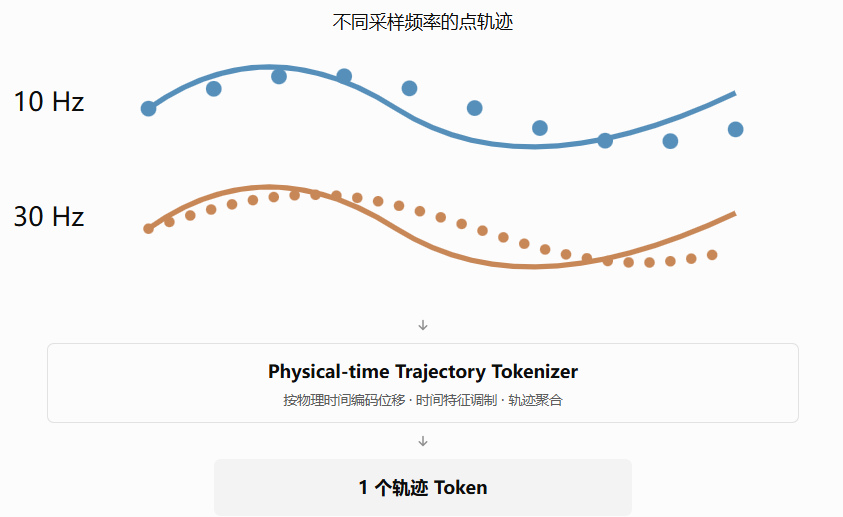
不同数据集帧率不同、持续时间不同。如果每个时间步都占一个 token,主干网络容量会被不等长的物理时间切碎。UNITAS 以秒为单位编码时间;共享 Tmax=3Tmax=3 秒;每条点轨迹编码成一个 token,并以当前 3D 位置为空间锚点。动作流、场景流、历史轨迹共享同一个分词器。这意味着,不同数据源、不同帧率、不同持续时间,第一次有了共同的时间尺度和空间锚点。
三、策略要快,模拟器要准:UNITAS 的双专家架构
在统一空间与时间表示之后,UNITAS 采用 Mixture-of-Transformers(MoT)架构,把模型划分为两个相互耦合的专家:Point Dynamics DiT 和 Action DiT。两者共享同一套观测与语言 KV,以及同一套 3D 位置表示,但承担不同职责。

Point Dynamics DiT 是点动力学专家,负责处理经过空间对齐的视觉特征、语言信息、历史动作流,以及未来动作流和场景流的轨迹 Token,建模智能体运动与环境变化之间的关系。它更偏向“世界动态/模拟器”分支。
Action DiT 是动作专家,读取点动力学专家提供的观测与语言相关 KV 信息,并结合当前末端状态及带噪声的动作 Token,预测机器人可执行的动作块,包括末端平移、旋转和夹爪开合。两个专家通过共享上下文建立联系,但动作专家不需要依赖未来动作流或场景流 Token 来完成控制推理。
这种设计使 UNITAS 在机器人执行策略时可以跳过未来动作流和场景流生成,仅保留直接动作预测路径,从而降低延迟;在需要模拟动作后果时,模型则可根据动作流预测场景流,并通过 KV Cache 减少重复计算。
从整体看,MoT 把策略与模拟器拆成两个专家:点动态专家处理动作流和场景流,负责几何动态;动作专家处理末端执行器动作块,负责可执行控制。动作专家读取动态专家的观测和语言 KV,以及自身状态和噪声命令 token。训练目标包括动作流损失、场景流损失、动作块控制损失和位置嵌入路由损失。
这种解耦的关键在于:策略要快,模拟器要准;两者共享表示,但不共享全部计算路径。否则,视频生成式慢路径会污染真实控制回路。
四、17 亿参数跑赢 80 亿:几何一致性如何变成成功率
前面的三维表示与双专家架构,最终带来了怎样的实际表现?
UNITAS 只有 17 亿参数,约为 80 亿参数模型 Motus 的五分之一,却在论文报告的 LIBERO 和 RoboTwin 2.0 评测中,取得了高于 Motus 和 60 亿参数模型 Fast-WAM 的操作成功率。
在 LIBERO 上,UNITAS 的平均成功率达到 99.8%,超过 Fast-WAM 的 97.6% 和 Motus 的 97.7%。
在双臂操作基准 RoboTwin 2.0 上,这一优势同样得到体现。UNITAS 在 Clean 和 Randomized 两种设置下,分别取得 92.94% 和 93.04% 的成功率。其中,在随机化设置下,Fast-WAM 和 Motus 的成功率分别为 91.78% 和 87.02%。参数量约为 Motus 的五分之一,成功率高出 6.02 个百分点,让 UNITAS“以小胜大”的特点有了具体体现。
面对环境与任务条件的变化,UNITAS 也保持了较好的表现:在包含七类扰动的 LIBERO-Plus 上,总体成功率达到 89.1%;在考察物体与指令泛化能力的 VLABench 上,成功率达到 56.2%,高于 π₀.₅ 的 48.1%。这些仿真成绩,能否延续到真实机器人上?
论文选择了两个任务进行验证:Organize Books 要求机器人将书籍对齐并放入书架对应位置;Pack the Ball 则要求机器人把球放进袋中,再闭合拉链。每个模型在每项任务中进行 20 次试验,UNITAS 分别取得 90% 和 80% 的成功率,两个任务平均为 85%。相比之下,π₀.₅ 和 Fast-WAM 的两任务平均成功率分别为 65% 和 62.5%。

操作成功率检验的是机器人能否完成任务,场景预测则检验模型能否预判动作带来的变化。
给定夹爪运动轨迹,UNITAS 会预测场景中三维点的位移及最终位置。论文图 5 展示了取书、开抽屉、双臂举升等案例,可以直观看到机器人运动与物体变化之间的对应关系。

在 RoboTwin 的动作条件场景预测实验中,相比 PointWorld,UNITAS 将运动点的平均位移误差(Moving ADE)从 0.656 厘米降至 0.427 厘米,降低约 35%;静态点的平均位移误差(Static ADE)从 0.084 厘米降至 0.043 厘米,降低约 49%。运动点预测误差在 1 厘米以内的比例,则从 88.22% 提升至 92.31%。
这些结果为前文的三维建模思路提供了实验支持:机器人完成任务的成功率提高了,对物体运动的预测也更加准确。以 17 亿参数同时支撑动作执行与场景预测,是 UNITAS 在这组实验中展现出的竞争力。
五、世界模型分水岭上的 UNITAS:从视频生成器到空间操作系统
UNITAS 没有在视频模型上修修补补,而是换了四个底层选择:
公共表示:从像素 token 到度量 3D 点轨迹。 视觉 token 带世界坐标,动作流与场景流都是三维点轨迹。模型学的不是“画面怎么变”,而是“空间中的点怎么动”。
跨本体接口:从关节控制序列到动作流。 夹爪采样 20 点,人手用 21 个 MANO 关键点。不必共享关节结构,却共享空间运动表示,策略入口因此跨本体共享。
时间表示:从每帧一个 token 到物理时间轨迹分词。 以秒编码,共享 Tmax=3 秒,一条点轨迹一个 token,以当前 3D 位置为锚点。不同帧率、不同时长,终于有了共同时间尺度。
策略与模拟器:从同一条生成链路到双专家。 Point Dynamics DiT 管动作流与场景流,负责几何动态;Action DiT 管动作块,负责可执行控制。策略要快,模拟器要准;共享表示,不共享慢路径。
这四个选择合起来,就是“动作中心的世界模型”:以度量 3D 为公共表示,以动作流为跨本体接口,以物理时间为对齐尺度,策略与模拟器双专家解耦。它更像空间操作系统,而不是视频生成器。
空间坐标统一之外,长时程还有“任务阶段错位”。跨维智能近期的另一项研究 TaskAnchor,关注的正是这一问题。TaskAnchor 让 VLA 用历史记忆生成任务状态坐标 p,判断当前处在长任务哪一步,在 RMBench 上把 π₀.₅ 任务特定成功率从 0.14 提到 0.79,每 chunk 仅增约 2 ms。UNITAS 统一“空间坐标系”,TaskAnchor 补“任务阶段坐标系”,两者互补。
世界模型不是视频生成器。对机器人而言,更重要的是动作在世界坐标系中改变了什么。UNITAS 把决策变量从未来像素改为物理位移,也把世界模型从观看工具变成了行动基础设施。
-END-
点击下方卡片,关注【Xbotics具身智能实验室】公众号
你想要的这里都有~~
Ask Me Anything|提问箱
对文章有疑惑,或想聊更深?欢迎把你的问题丢给我们:技术方案、实操踩坑、课程与资料、项目合作、职业发展,都可以问。
怎么问:在评论区留言,或私信公众号
我们会做什么:每周集中整理高质量问题并公开回复,重点问题邀请作者或嘉宾深度解答;典型问题会加入知识库并持续更新。
提问小提示:尽量说明「你的目标—当前做法—期望产出」,附上必要信息(硬件/软件版本、数据规模等),能更快获得有用答案。
一起把问题变成知识,推动社区进步 🚀