> 本文来自社区投稿
引言:从视觉骨干到车端部署
将视觉模型部署到车载平台,要同时考虑图像细节、推理速度和显存占用。远处的小目标需要足够的分辨率,分割与深度预测需要保留空间结构,而这些计算最终都要在有限的硬件资源内完成。
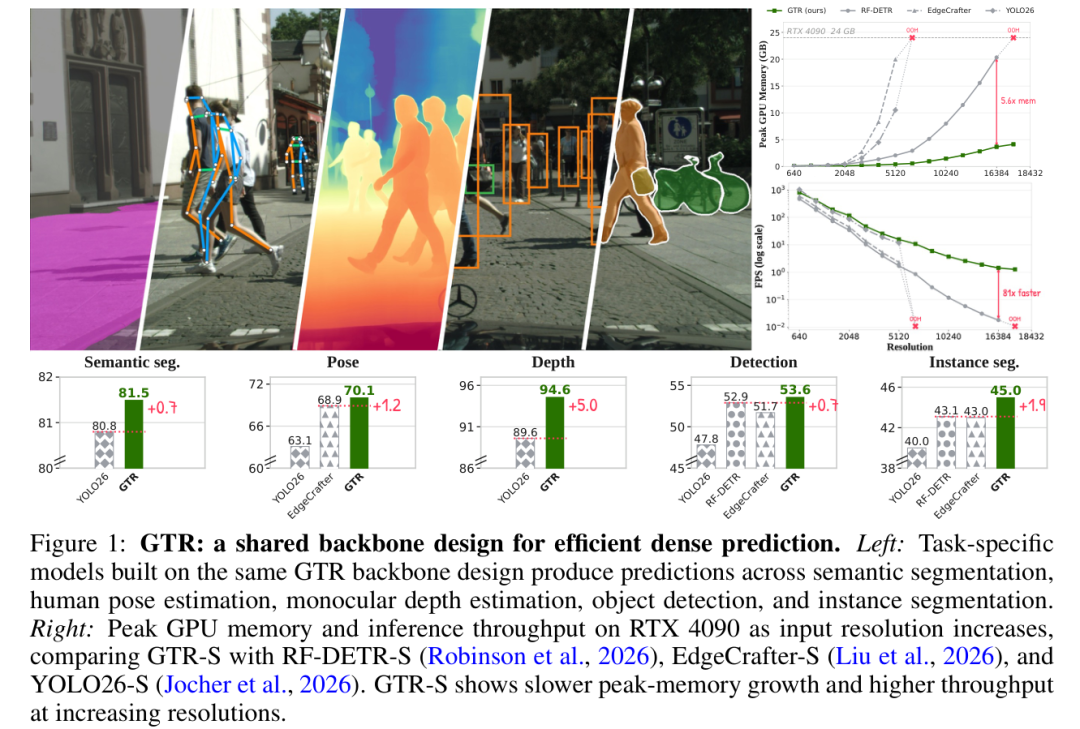
GTR 从视觉循环网络出发,给出了从模型设计到车端推理的一套实现。 它以门控线性注意力构建视觉 backbone,并在 NVIDIA DRIVE AGX Thor 上完成六类密集预测任务的部署测试。论文报告的单图推理延迟中位数覆盖 2.282 至 8.769 ms,具体数值取决于任务、模型规模和输入尺寸。


论文标题:GTR: Gated Token Recurrence for Efficient Dense Prediction
作者:Zhe Feng 等
作者单位:滴滴国际化业务群与滴滴研究院、Intellindust AI Lab、中科院自动化所、香港科技大学(广州)
论文链接:https://arxiv.org/abs/2609.26590v2
项目主页:https://intellindust-ai-lab.github.io/projects/GTR/
代码仓库:https://github.com/Intellindust-AI-Lab/GTR
部署:车端表现先看具体任务
GTR 有 S、M、L、X 四种规模。Thor 上的部署使用 TensorRT 和 FP16 精度,下面摘取 S、X 两端的单图延迟,展示不同任务的开销:
数据据论文附录 E 整理,均为 Batch Size 1 的延迟中位数;每项任务分别训练模型。
实现上的优化重点是减少中间张量读写和 Kernel 启动。研究把标准 TensorRT 算子与 GLA、Spatial SwiGLU 的融合实现结合起来,保持原有计算逻辑,并在全部 48 组任务、规模与 Batch 配置中检查数值一致性。TensorRT FP16 输出与 PyTorch FP32 参考输出的余弦相似度最低为 0.9989。
Batch Size 8 时,GTR-S 检测的吞吐量达到 571 图像/秒。不过,对于输入为 1024 × 1024 的旋转检测和语义分割,论文测得 Batch Size 1 的吞吐量更高。部署时,Batch 大小仍需结合任务和内存访问开销选择。
分辨率:多付出的计算是否值得
在全局 Softmax 注意力中,每个 Token 都与其余 Token 计算关联,注意力计算量随序列长度二次增长。图像长、宽各翻一倍,Token 数量就会变成四倍,注意力部分的开销随之快速上升。
GTR 用循环状态传递上下文。在模型宽度和头数固定时,backbone 的计算量随 Token 数量线性增长。更关键的是,增加的图像细节确实转化成了检测收益。
论文对经过 Objects365 预训练的 GTR-S 做了分辨率实验,以下是其中三个设置:
数据据论文表 6 整理,延迟在 RTX 4090 上测量,采用 FP16、Batch Size 1、编译与 CUDA Graph 执行。
从首行到末行,Token 数增加至四倍,小目标 AP 提升 6.0,延迟约为原来的 2.06 倍;峰值显存则由 0.096 GB 增至 0.249 GB。这为需要识别小目标的场景提供了一种选择:用较高分辨率换取精度,同时控制延迟增长。具体收益仍取决于输入规模与硬件执行效率。
架构:循环网络怎样保留二维空间信息
GTR 将图像按步长 16 转成 Patch Token,在固定网格上连续计算 12 层。每层承担两类交互:GLA 传递长距离上下文,Spatial SwiGLU 处理邻近位置。

GLA 维护一个状态矩阵。扫描到新位置时,它先按输入生成的门控保留一部分历史状态,再写入当前位置的 Key、Value 信息。其核心更新可以写成:
其中, 控制各个 Key 维度上的信息保留比例,当前位置的 Query 再从更新后的状态中读取输出。GTR 使用 Key-only 门控,Value 侧的状态衰减固定为 1。状态矩阵的大小不随图像 Token 数增加,激活和中间工作区仍需要相应内存。
图像有二维邻接关系,单一顺序的扫描无法在一层内提供各个方向的上下文。GTR 把扫描方向分配给连续的层:左至右、右至左、上至下、下至上,四层为一轮。每层完成一次扫描后恢复网格排列,后续层继续汇集其他方向的信息。
局部细节则由 Spatial SwiGLU 补充。它在 Value 分支中加入 3 × 3 逐通道卷积,让相邻 Patch 直接交换信息。配合交替扫描,GTR backbone 不需要显式位置嵌入。
消融实验提供了对应证据:在 GTR-L 上,单向扫描搭配学习式位置嵌入得到 45.6 AP;替换为 Spatial SwiGLU 后达到 54.4 AP;进一步采用四向交替扫描,达到 55.5 AP。局部混合带来了主要提升,多方向扫描继续补充收益。
研究也尝试在 12 层中插入三层 Softmax 注意力,结果为 55.4 至 55.6 AP,延迟却由 1.908 ms 升至 2.094 至 2.117 ms。就这些实验配置而言,保留纯 GLA backbone 更合算。
算子:从循环公式到高效实现
有顺序依赖,并不意味着所有计算都必须逐个 Token 串行执行。GTR 的 CUDA 实现把序列按 64 个 Token 分块,让各块先并行计算自身对状态的贡献;随后传递块边界状态,再并行生成各块输出。
这样安排后,顺序依赖集中在较轻的边界状态扫描上。实现还通过共享内存和算子融合,减少临时注意力得分写入全局显存的次数。

在 RTX 4090 的独立 GLA 算子测试中,相比 FLA v0.5.0,GTR 在 1,600 个 Token 时取得 4.0 倍加速,在 16,384 个 Token 时取得 6.4 倍加速。测试采用 FP16 与 CUDA Graph,不包含输出尾部融合;这些比值描述的是算子加速,整网延迟另行测量。训练阶段仍沿用参考 FLA Kernel。
蒸馏:教师表征通过最后一层传给学生
为训练这个循环 backbone,研究采用经过检测任务适配的 DINOv3 作为教师。师生读取相同图像,只在最终 Patch 特征上建立监督:学生输出经线性映射后,与教师特征计算平方 L2 损失。

教师参数保持冻结,学生内部可以采用不同的计算过程。蒸馏目标集中在最后一层,得到的权重再用于检测预训练和各项下游任务。
在相同教师、GTR-S 学生和 COCO 训练安排下,最终层对齐取得 50.7 AP,适配后的 ViT-AdaLA、ViT-Linearizer 分别为 48.2、50.0 AP。这组比较跳过了 Objects365 预训练;其中随机初始化后直接训练的基线只有 31.1 AP,说明蒸馏初始化对结果影响很大。
迁移:检测之外哪些任务也能用
经过蒸馏、Objects365 检测预训练和 COCO 训练后,GTR-L 达到 58.9 AP、1.908 ms;GTR-X 为 59.4 AP、2.115 ms。作为参照,RF-DETR-X 是 58.6 AP、3.243 ms,参数量为 126M,GTR-X 为 46.5M。
这些延迟来自 RTX 4090 上的 FP16、Batch Size 1、torch.compile 与 CUDA Graph 测量。GTR 检测输入为 640 × 640,RF-DETR 使用各规模的官方原生分辨率;DETR 类模型仅计网络前向,需要 NMS 的对照模型额外计入 CUDA NMS。基线精度引用各自来源,延迟由论文复测。
小模型也有清楚的取舍。GTR-S 为 53.6 AP、1.225 ms,YOLO26-S 为 47.8 AP、0.962 ms:前者提高了精度,后者延迟更低。

在其余任务中,研究复用 backbone 结构,分别训练对应模型:
实例分割: GTR-X 在 COCO 上达到 49.8 Mask AP,前向延迟 2.472 ms,训练未使用 SAM2 伪掩码。 人体姿态: S、X 两种规模分别达到 70.1、75.5 Keypoint AP;X 的延迟为 2.590 ms。 语义分割: 使用轻量 FCN 头,GTR-X 在 Cityscapes 上取得 83.6 mIoU,与 YOLO26x-sem 持平,延迟低约 19.5%。 旋转检测: GTR-X 在 DOTA-v1.0 上为 81.3 AP50、3.960 ms;YOLO26x-obb 为 81.7 AP50、5.085 ms,体现了精度与速度的另一种取舍。 单目深度: GTR-X 在 NYU Depth V2 上为 δ₁ = 0.954、AbsRel = 0.067。模型经过八个来源的混合数据训练,没有针对 NYU 单独微调;评测采用多尺度、翻转增强,以及逐图对真实深度的对数仿射对齐。


从这些实验看,GTR 的适用价值集中在需要空间细节、同时关心部署成本的密集预测任务。实际选型时,可以先确定输入分辨率与延迟预算,再比较对应规模的精度。论文和仓库提供了进一步核对训练、评测与部署设置的入口。
阅读论文:https://arxiv.org/abs/2609.26590v2
查看项目介绍与实验结果页:https://intellindust-ai-lab.github.io/projects/GTR/
获取代码:https://github.com/Intellindust-AI-Lab/GTR
-- 完 --
机智流推荐阅读:
1.
2.
3.
4.
cc | 大模型技术交流群 hf | HuggingFace 高赞论文分享群 lc|LangChain 技术交流群 code | AI Coding 交流群 具身 | 具身智能交流群 硬件 | AI 硬件交流群 推理 | AI 推理框架交流群 智能体 | Agent 技术交流群