每隔几个月,就会出现一个能力更强的新人工智能模型,半导体制造商也被要求把它们用到生产里。去问那些已经在晶圆厂或测试车间部署过机器学习的工程师,时间究竟花在哪里,很少有人会回答是挑选算法。大部分时间用在寻找、清洗和拼接数据,还要说服同事:这个结果可以信赖。由此得出的结论并不让人舒服。行业从人工智能获得的下一轮较大收益,不会来自运行更复杂的模型,而来自把制造数据做得可靠、带上上下文,并接到工程师每天要做的决策上。
数据很多,却连不到一起
半导体晶圆厂并不缺数据。设备会保存每个腔体、每道工序的传感器数据;配方、维护事件和耗材更换都有日志;量测与检测设备测量膜厚、关键尺寸和缺陷;晶圆验收测试、晶圆探针测试和最终测试,又加上数以百万计的参数数据,以及测试内容的通过或失效。客户退货则要到数月之后,才把这条回路闭合。
这些数据源由不同团队、出于不同目的、建在不同系统上,标识符、时间基准和细节层级都不一样。工艺工程师看的是批次和晶圆,测试工程师看的是工位、良率、测试时间和分档(bin),可靠性工程师看的是已经封装的器件。把一颗失效器件追溯到产生它的晶圆、腔体和配方,中间的链接往往会断掉。断掉之后,各团队仍能分析自己手里的数据,问题本身却已经跨过好几道工序。
没有上下文,模型学到的常常是假象
即便来自同一个数据源,一次测量有没有用,也取决于附在上面的上下文。一次漏电流测量,如果没有测量时的电压和温度、测试程序版本以及探针卡,含义就很有限。一个膜厚数值,如果没有设备工序、腔体工序和配方工序,同样说明不了什么。缺少上下文时,模型还是会找出规律。在没有上下文的制造数据里,最强的规律常常是人为痕迹,而不是物理机理:两台测试机之间的偏移、批次做到一半更换了探针卡,或者同一批器件被复测了两次。学到这些规律的模型,在验证时可以看起来很准,却仍会把工程师引去追查一个错误的原因。
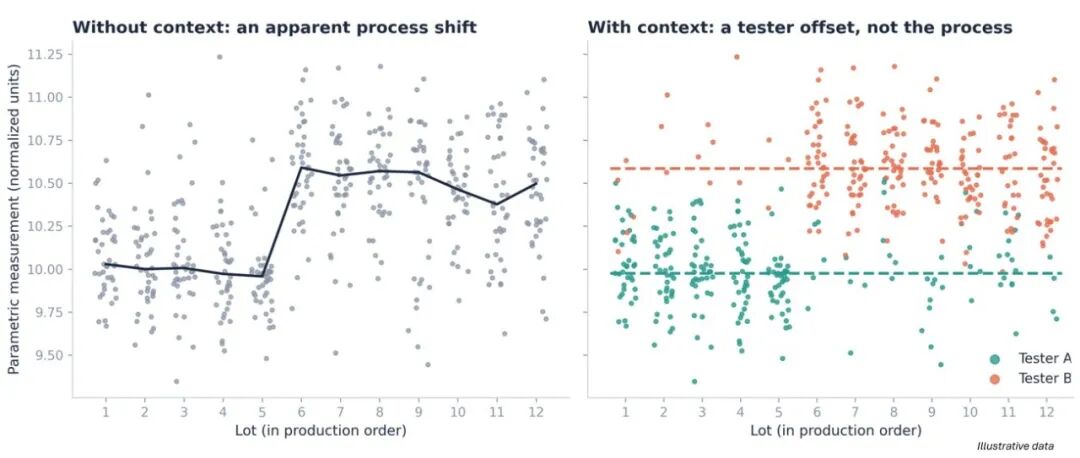
图 1:没有上下文时,模型会把第 6 批看成一次工艺偏移;记下每颗器件由哪台测试机测量之后,看到的是测试机之间的偏移,测试机 A 与测试机 B 各自随时间保持稳定。数据为示意。图片来源:斯里拉姆·尼廷·戈帕尔·兰卡。
数据所描述的对象还会随时间改变。一项测试被停用、一道配方被调整,或者一条限值被移动之后,变更前后的数据就不再描述同一件事。这些变更如果没有随数据明确记下来,训练出来的任何模型,都是在把两种不同的工艺混在一起。
能解释,才能落到动作上
人工智能可以找出跨工序的相关关系。某个刻蚀腔体的缓慢漂移,可能要到数周之后,才在晶圆探针测试上表现为参数分布发生偏移,再往后才在最终测试上表现为失效突然增多。要把这些点连起来,就得把可能散落在许多部门、许多工具里的数据接上。
人工智能也能用来清洗数据。机器学习擅长把不一致的标识符连起来,识别物理上不可能的测量值,对晶圆图谱做分类,并从非结构化的维护记录和失效分析笔记中提取信息。在许多团队里,第一项最有成效的人工智能工作并不是良率模型,而是先把数据做到足够可信,让良率模型真正有价值。
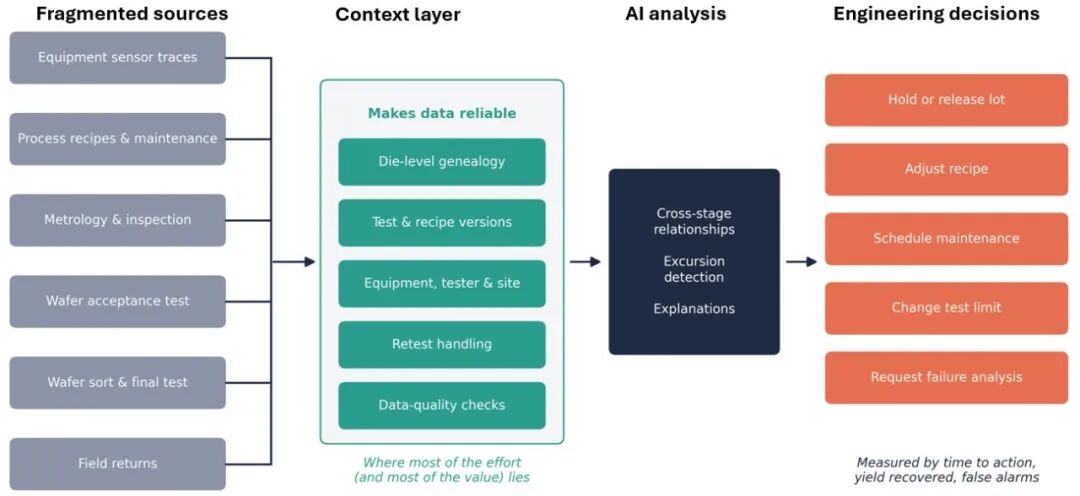
图 2:分散的晶圆厂与测试数据,要先经过上下文层变得可靠,人工智能分析才能对应到具体的工程决策。图中上下文层包括裸片级谱系、测试与配方版本、设备、测试机与工位、复测处理以及数据质量检查,并标明大部分工作和大部分价值都在这一层。右侧的决策包括暂停或放行批次、调整配方、安排维护、修改测试限值、送交失效分析。效果按采取行动的时间、挽回的良率以及误报来衡量。图片来源:斯里拉姆·尼廷·戈帕尔·兰卡。
最后一道缺口,在洞察和行动之间。数据看板可以指出相关关系,相关关系本身并不会把良率做回来。总得有人去做一件具体的事,比如修改配方、确认维护已经完成、核对测试限值,或者送去失效分析。人们也要准备好根据这些证据采取行动。这里有两点。
其一,模型必须说明它为什么把某件事标出来。用工程语言来说,就是用了哪台仪器、涉及哪道工序、哪个参数超出了范围。说明必须清楚、具体。
其二,衡量成败应当看工程结果,而不是只看模型有多准。真正要问的是:模型多快能发现一次异常?采取行动之后能挽回多少良率?告警有多经常是错的?这些才是成败指标。
先接上数据,再谈算法
对刚刚开始、或重新启动人工智能工作的团队来说,有几件事比挑选算法更重要。其一,把从晶圆探针测试到后续测试各阶段的数据接起来,可能的话把现场退货也纳入,使数据能够追溯到来源。其二,每一次测量都带上上下文,包括测试条件、设备、程序与配方版本,以及复测状态。其三,把数据质量当成一项工程职责来管,指定负责人,而不是在每个项目开始前临时清理一次。其四,让工程师留在回路里,给出他们能够用自身经验核对的解释。
真正难以复制的,是数据本身
算法如今对谁都开放,模型与商业工具也是如此。竞争对手复制不走的,是一套连接紧密、又被理解清楚的制造数据,以及一个清楚知道拿这些数据做什么的组织。能靠人工智能取得优势的半导体公司,未必是模型最复杂的那些,而是工程师信任自己数据的那些。
作者斯里拉姆·尼廷·戈帕尔·兰卡是 AMD 位于得克萨斯州奥斯汀的高级产品开发工程师,工作覆盖可测试性设计(DFT)扫描测试、存储器内建自测试(BIST)、诊断、漏电流测试、阵列修复、位图、新产品特性分析、良率提升,以及晶圆探针测试和最终测试阶段的测试程序负责与测试时间缩减。加入 AMD 之前,他在恩智浦半导体(NXP Semiconductors)奥斯汀的研发部门担任失效分析实习生,为新产品导入、质量认证、良率提升和客户质量投诉做电学故障定位。他还曾在加利福尼亚州尔湾的思佳讯(Skyworks Solutions)担任设计与验证实习生,从事射频功率放大器的设计与测量。
原文:
https://semiwiki.com/semiconductor-manufacturers/374900-why-semiconductor-ai-starts-with-data-not-algorithms/
今日推荐:
直播报名