论文标题:SPADER:Step-wise Peer Advantage with Diversity-Aware Exploration Rewards for Multi-Answer Question Answering
录用信息:EMNLP 2026 Main Conference
论文链接:https://arxiv.org/abs/2606.00593
代码开源:https://github.com/KhanCold/spader
模型开源:https://huggingface.co/KhanCold/qwen3-8b-spader
一句话概括:多答案问答要求智能体找全整个答案集合,而不是只搜到一个就停止。现有 RL 方法在此场景下存在两处错位:优势计算停留在轨迹级,信用分配粗糙;F1 奖励对头部与长尾实体一视同仁,智能体缺乏探索长尾的动力。SPADER 将 GRPO 的轨迹级优势细化到步骤级,并用双向奖励机制激励长尾发现,在四个基准、两种基座模型上全面提升了召回与 F1。
问题:多答案问答,找全比找到一个更难
大语言模型正在从「问一句、答一句」走向「边搜边答」:智能体迭代地发出搜索查询、阅读检索证据、判断何时收手并给出最终答案。但现有这类工作大多只关注「只有一个正确答案」的任务。真实世界中的大量信息需求是覆盖导向的,即要求系统找全一个完整的有效答案集合,这就是多答案问答(Multi-Answer QA)。
以一个真实问题为例:「列出 2021 年有成功轨道发射的全球发射场。」它的正确答案是一组实体,而且分布很不均匀:Kennedy、Vandenberg、Jiuquan 这类高频「头部」实体一搜就有,而 PSCA、Spaceport 等长尾答案藏在知识空间的偏僻角落,需要持续多轮挖掘。

图 1:同一问题下普通智能体(上)与 SPADER 智能体(下)的搜索轨迹对比。普通智能体重复检索头部实体后提前作答;SPADER 从观察中捕捉线索、持续改写查询向长尾扩展,答案覆盖显著更全。
上方是普通智能体:第一步搜「2021 年全球轨道发射汇总」,拿到 Kennedy、Vandenberg、Jiuquan 三个头部实体;第二步换了个说法「著名的卫星发射中心」再搜一遍,返回的还是这三个实体,没有任何新发现;于是第三步就直接作答,答案停留在头部。
下方是 SPADER 训练出的智能体:第一步搜索相同,但从观察中捕捉到「商业发射」这条未被覆盖的线索,第二步主动改查「2021 年的商业发射」,新挖出 PSCA、Spaceport;随后沿「低纬度发射场」「海上发射」等线索继续改写查询、挖掘长尾(第 3–5 步),直到第 6 步才作答,答案集明显更全。
要实现这种持续探索,智能体必须学会做多步决策:何时改写查询、采纳哪些证据、何时终止作答。这类决策很难靠提示工程「教」出来,于是近期工作越来越多地把工具增强问答建模为策略学习问题,用强化学习来优化。但在多答案问答场景下,现有 RL 方法仍然卡在两处。
用 RL 训练时,两个问题浮出水面
问题一:长程搜索轨迹上,信用分配困难重重
长程搜索轨迹让信用分配(credit assignment)变得困难:智能体在连续几十步中交织执行有效、冗余和无关的搜索,要识别出哪一步真正扩大了答案覆盖,并不容易。现有几类方法各有短板:
PPO(actor-critic):依赖价值网络估计每一步的长期回报,而价值估计误差会在长程上不断累积,信用分配不可靠,训练昂贵且不稳定。
GRPO(critic-free):去掉了 critic,稳定性有所改善,但 Advantage 仍停留在轨迹级:整条轨迹赢了,无法说明中间到底是哪一步搜得好。
R3-RAG、StepSearch 等中间步骤奖励方法:类似 PRM 的思路给中间步骤打分,但依赖外部评估器或过程标注,且仍基于 GRPO 的轨迹级 Advantage 做优化,本质上没有提供步骤级的信用信号。
GiGPO、SALT 等状态匹配路线:通过严格的状态匹配实现步骤级信用分配,但多答案问答中搜索观测天然噪声大、差异大,「精确状态匹配」这个前提本身就很难成立。
问题二:常用奖励形式与「答案覆盖」目标错位
以 F1 为基础的奖励对每一个实体一视同仁,对检索困难的「长尾答案」没有任何额外激励;且搜索过程中没有任何信号告诉智能体「该继续搜还是该收手」。结果就是:智能体只满足于容易检索的高频头部实体,找到几个显眼答案就提前终止。
方法:SPADER
针对这两处错位,作者提出 SPADER(Step-wise Peer Advantage with Diversity-Aware Exploration Rewards),一个面向多答案问答长程工具使用的强化学习框架。它包含两个互补的组件:用于细粒度信用分配的逐步同伴优势(SPA),和防止过早收敛到头部实体的多样性感知探索奖励。
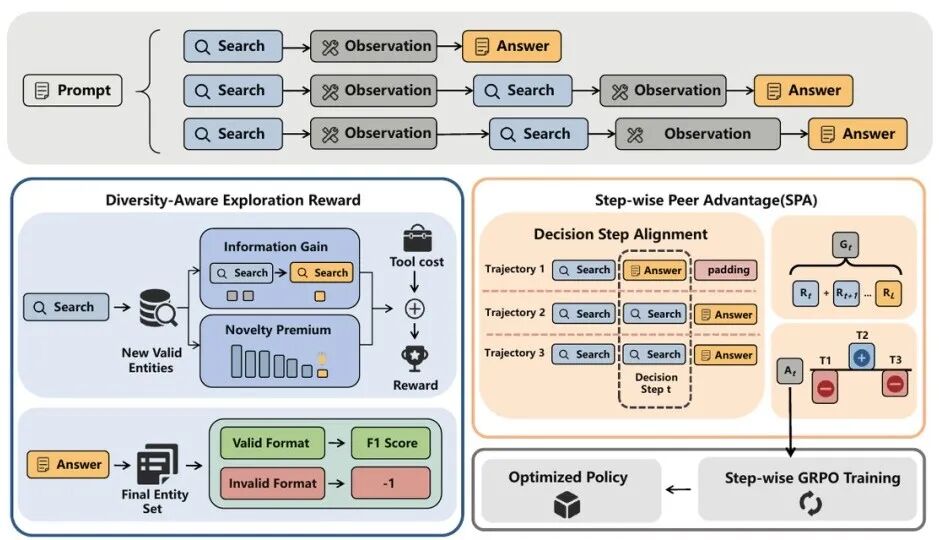
图 2:SPADER 框架总览。采样并行轨迹后,框架用多样性感知探索奖励评估每一步 Search 与 Answer 动作;随后 SPA 按决策步对齐轨迹,计算未来回报与步骤级优势,通过 step-wise GRPO 共同优化策略。
组件一:SPA(Step-wise Peer Advantage),按决策步对齐、用同伴回报做基线
SPADER 构建在 GRPO 的分组机制之上:对同一提示词并行采样 G 条轨迹,组内互相比较得出相对优势。GRPO 只提供轨迹级的 Advantage,SPA 则把优势估计从轨迹级细化到步骤级,具体分四步。
1、决策步对齐。搜索过程建模为 MDP:智能体在状态 St 下发出动作 at∈{Search, Answer}。在第 t 个决策步上,组内采样得到的轨迹集合构成了以同一提示词、同一交互轮次为条件的基线,且无需假设轨迹间的语义或状态等价。对提前终止的轨迹,补齐到组内最大长度 Lmax、以未来回报 0 参与组基线,并用有效性掩码 Mt 屏蔽终止后的梯度(t≤Li 取 1,否则取 0)。
2、未来回报。用蒙特卡洛法估计轨迹 i 在决策步 t 的未来累积折扣回报:
3、组基线与步骤级优势。以同一决策步上全组 Gt 的均值 μt 和标准差 σt 为基线,得到步骤级相对优势:
。
其中 μt 是同一提示词、同一决策步 t 下由蒙特卡洛采样得到的未来期望,跑赢该期望的步骤得正优势,跑输的步骤得负优势。
4、训练目标。把 GRPO 目标中的轨迹级 Advantage 替换为 At(i),按决策步逐步做重要性采样与 clip,照常加入 KL 正则,即 step-wise GRPO。全程不需要参数化价值网络,也不需要外部评估器。
组件二:双轴探索奖励,让「稀有发现」更值钱
仅做好信用分配还不够:如果奖励本身不奖励长尾,智能体依然没有动力走远。SPADER 把奖励拆成两个阶段:搜索阶段的双轴探索奖励,和最终作答阶段的全局评估奖励。
对每一步搜索动作新发现的每个有效实体 e,其奖励由两个正交维度加权组成:
横向信息增益 Ugain(e):检索到一个有效新实体的基础效用,定义为常数 1。
纵向新颖度溢价 Unovelty(e):一种奖励稀释机制:设 N(e,T) 为组内检索到 e 的轨迹数,则 Unovelty(e)=1/N(e,T),与组级检索频率成反比。
这一设计直接对齐多答案问答的覆盖目标:容易被大多数并行轨迹发现的「头部」实体(N≈G)受到严重的新颖度稀释,边际收益只剩基础增益 α;而独有的长尾发现(N=1)拿到最高奖励 α+β。
与此同时,每一步搜索都要扣除固定工具成本,并按标准答案集大小 |EGT| 归一化以稳定梯度。工具成本让「继续搜」不再是免费动作:当预期新颖奖励抵不过累计搜索成本时,智能体自然应该收手。再配合终端作答奖励(格式非法记 −1,否则按最终 F1 结算),「何时继续搜、何时终止作答」由奖励结构自己涌现,不需要人为规定搜索轮数上限。
实验结果
主实验:四个基准、两种基座全面领先
论文在 Llama3.1-8B 与 Qwen3-8B 两种基座上,与三类基线对比:提示类方法(RAG、ReAct)、结果监督 RL(PPO、GRPO)、步骤级监督(R3-RAG、StepSearch)。

表 1:SPADER 与各类基线在四个多答案 QA 基准上的 Precision/Recall/F1 对比,含 Llama3.1-8B 与 Qwen3-8B 两种基座。
SPADER 在两种基座、四个数据集上的 F1 全部第一,在 QAMPARI 上相对 PPO、GRPO 最高提升 86.1%,对步骤级基线 R3-RAG、StepSearch 也一致领先。
消融:两个组件缺一不可
SPADER 的提升究竟来自这两个组件本身,还是其他训练细节?作者逐一移除单个组件,在 Qwen3-8B 上重新训练:
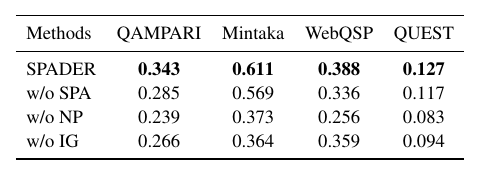
表 2:Qwen3-8B 上的消融实验(F1)。「w/o」表示从 SPADER 中移除某一组件;NP、IG 分别指新颖度溢价与信息增益。
结果表明三者缺一不可:去掉 SPA,性能稳步下降,验证了步骤级信用分配的作用;去掉新颖度溢价,性能大面积退化,说明它是防止早塌缩到高频实体的关键;去掉信息增益,策略会被新颖度带偏到「稀有但无用」的实体。横向与纵向两个奖励轴必须保持平衡。
搜索效率:没有为覆盖付出过量探索
覆盖更全,会不会只是因为搜得更多?论文统计了每检索到一个有效实体所需的平均搜索次数:

图 3:各方法检索一个有效实体所需的平均搜索次数(Qwen3-8B)。
SPADER 的效率仍然具有竞争力:比它更省的方法召回更低,「高效率」部分来自抓住头部实体就提前终止;而搜索次数最多的 GRPO 反而召回最差,陷入了冗余搜索。SPADER 没有靠堆搜索次数换来覆盖,而是用差不多的搜索挖到了更多的有效实体。
时间动态:把探索持续到目标耗尽为止
智能体是否真的学会了何时继续搜、何时停手?论文跟踪了 QAMPARI 上每个交互轮次累积发现的有效实体数:

图 4:QAMPARI 上每个交互轮次的累积不同有效实体数。
GRPO 和 ReAct 在第一轮后就过早收敛;StepSearch 把搜索延续到后续轮次;SPADER 则在整条轨迹上保持最高的累积产出,直到有效目标耗尽才进入平台期:只要还有新实体可挖就继续,挖完了才停,而不是搜到几个答案就收工。这正是「何时继续、何时终止」被直接学到的证据。
总结
针对多答案问答「找全」的目标,现有 RL 工具增强智能体存在两处错位:信用分配停留在轨迹级,奖励不与覆盖对齐。SPADER 用两个组件分别回应:SPA 按决策步对齐并行轨迹,将 GRPO 从轨迹级细化到步骤级,以同提示词、同交互轮次下的同伴回报为基线,实现无 critic、无外部评估器的步骤级信用分配;多样性感知探索奖励以横向信息增益保底、纵向新颖度溢价稀释头部实体,配合工具成本与终端结算,让「何时继续、何时终止」从奖励结构中涌现。主实验、消融、效率与时间动态分析一致表明:提升来自更细的训练信号,而非更多的搜索。

© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com