封面:TorchTPU 官方头图(图源 PyTorch 博客)
北京时间 10 月 21 日 01:45,正在开 PyTorch 大会的 PyTorch 官方账号发帖:谷歌和 Meta 推出 TorchTPU,让 PyTorch 原生跑在谷歌 TPU 上,代码开源。说白了:原来写 .to('cuda') 把模型放到英伟达显卡上,现在写 .to('tpu'),同一份 PyTorch 代码就能上谷歌的芯片。
昨天我们刚写过亚马逊的 TorchNeuron(把 Trainium 变成 PyTorch 设备),今天轮到谷歌。两家大厂的自研芯片,前后脚都成了 PyTorch 里和 cuda 平起平坐的设备。我们把仓库克隆下来读了源码,下面一层层拆开。
GitHub 仓库
https://github.com/google-pytorch/torch_tpu
PyTorch 官方博客
https://pytorch.org/blog/introducing-torchtpu/

PyTorch 官方发帖原文(发帖时间为北京时间)
先说背景:TPU 以前为什么离 PyTorch 那么远
• TPU:谷歌自研的 AI 专用芯片,只在谷歌云上租用。
• 以前绑着 JAX/XLA:TPU 的底层编译器叫 XLA。官方博客直说,TPU 历来属于 TensorFlow 和 JAX 生态。
• 老方案的毛病:2020 年谷歌推过 PyTorch/XLA,基于「惰性张量」。博客自己总结它的问题:要侵入式改代码标出可编译区域、编译慢、不支持 PyTorch 默认的即时执行(eager)模式、分布式新功能跟不上。博客的原话是,之前的方案是把 PyTorch「硬塞进 JAX 的做事方式」。
TorchTPU 是 2025 年年中在谷歌内部启动、和 Meta 的 PyTorch 团队合作的新项目。它给自己定的规矩很明确:运行时不依赖 JAX;eager 模式要扎实;torch.compile 走 PyTorch 自己的 Dynamo;DDP、FSDP、DTensor 这些分布式写法都要能用。
用起来:一个真实例子

这是仓库 examples/simple_pytorch 里的官方示例,注释写得很直白:「Change from cuda to tpu」。注意这里连 import torch_tpu 都没写,下面会讲为什么。博客里还给了另一种写法:用 PyTorch 推荐的 torch.accelerator.current_accelerator() 自动选设备,同一份代码 GPU、TPU 都能跑。分布式只要把 init_process_group 的后端从 nccl 换成 tpu_dist。
编译模式也一样:torch.compile(model, backend="tpu")。官方提醒,一行改动能「跑起来」,但不等于跑到 TPU 的峰值,模型的形状、切分方式可能是照着 GPU 设计的,要压榨性能还得调。
源码第一层:import torch 时自动挂载

打包配置里只有一个入口点,挂在 torch.backends 这个组下面。PyTorch 有一个「自动加载」机制:import torch 时会扫描这个组,把装好的硬件插件一起加载。所以只要装了 torch_tpu 这个包,用户代码一行 import 都不用加。
源码第二层:把预留设备改名叫 tpu

PyTorch 早就给外部硬件留了一个官方空位,叫 PrivateUse1:谁接进来,谁就能给它起名、实现它的算子。TorchTPU 加载时第一件事就是 rename_privateuse1_backend("tpu"),把空位改名叫 tpu;接着自动生成 tensor.is_tpu、model.tpu() 这类便捷方法,让 TPU 的写法和 cuda 一模一样。同一个函数后面还会把 torch.tpu 模块挂上去。
这和昨天写的 TorchNeuron 用的是同一套官方接口。区别在于,亚马逊那边设备叫 neuron,谷歌这边叫 tpu。
源码第三层:每个算子怎么翻译给 TPU
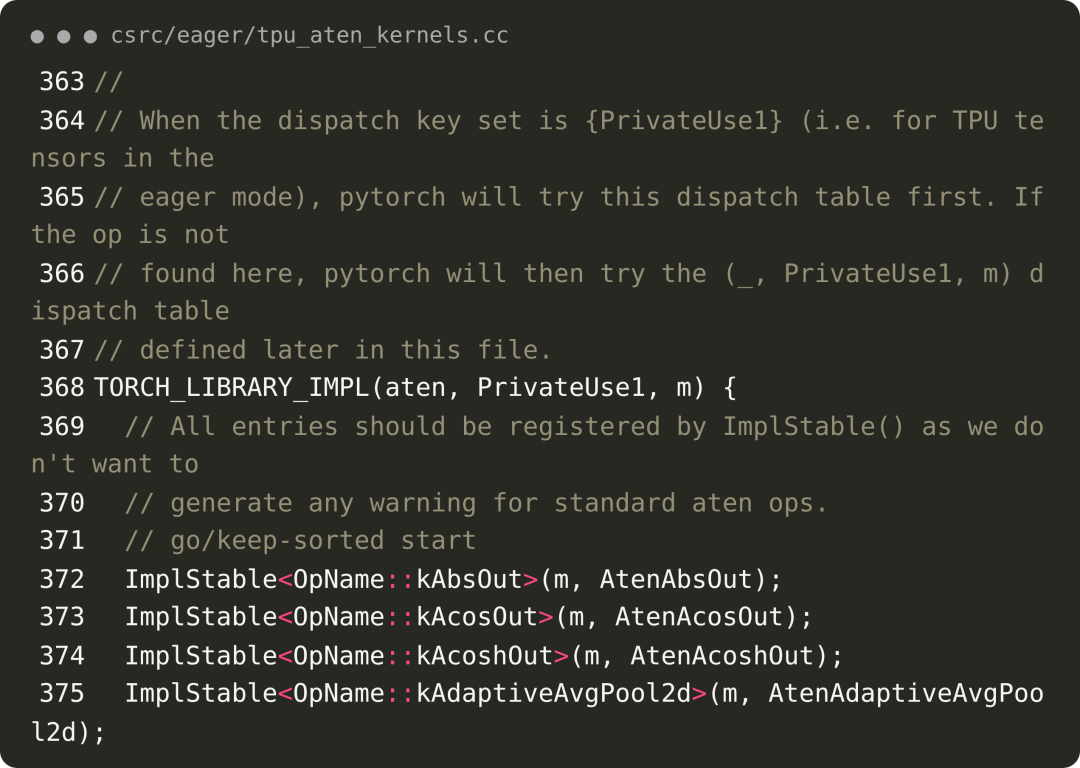
PyTorch 的每个基础运算(加法、矩阵乘、池化……)叫 ATen 算子。C++ 里这一大段 TORCH_LIBRARY_IMPL(aten, PrivateUse1, m) 就是一张「登记表」,告诉 PyTorch:张量在 TPU 上时,abs、acos 等算子该调哪个函数。博客说目前支持了约 450 个 ATen 算子。仓库的 csrc/ops 目录下按算子分了上百个子目录。
每个算子并不是直接驱动芯片,而是生成一小段 StableHLO(XLA 能看懂的中间语言),交给 XLA 编译成 TPU 程序。这带来一个 TorchTPU 独有的设计,eager 模式有三档:
• Strict(默认):一个算子一个算子地发,和 GPU 上的 eager 一样。
• Debug:同步执行,方便查错,相当于 GPU 上的 CUDA_LAUNCH_BLOCKING。
• DeferAndFuse:先攒着不执行,等到真需要结果(比如 .to('cpu'))时,把攒下的一串算子合并成一个程序编译。博客说这比 Strict 快 50% 以上,还更省显存。
编译出来的程序放进三级缓存:进程内、同一台机器的多个进程之间、远程存储(比如谷歌云存储)跨机器共享,避免反复编译。
源码第四层:torch.compile 后端


第一张图:向 Dynamo 注册一个叫 "tpu" 的后端,这就是 backend="tpu" 的来历。第二张图是后端的核心:它调用 PyTorch 自带的 aot_autograd,前向图、反向图分别交给 TPU 编译器。注意外面那层 set_eager_mode(..._INTERNAL_COMPILE_FX_GRAPH):编译模式其实复用了 eager 的「攒着不执行」机制,把 Dynamo 抓到的整张图当成 eager 跑一遍、全部延迟,最后合成一个大的 StableHLO 程序。eager 和 compile 共用一套算子实现,这是很省事的设计。
源码第五层:分布式

在 torch.distributed 里注册 tpu_dist 和 tpu 两个通信后端。TPU 没有 NCCL 那样单独的通信库,集合通信直接写成 StableHLO 算子。因为接在 PyTorch 的 Process Group 这一层,DTensor、FSDP2、SimpleFSDP 这些上层框架不用知道底下是什么芯片。
官方给的数
• 模型覆盖:测了 4,917 个 Hugging Face 热门模型,98%(4,821 个)能跑通不崩;657 个架构代表模型里,97%(638 个)数值和 GPU 对得上。
• Llama 3 405B:在 1,024 块 TPU v7x 上用 TorchTitan 训练,8K 上下文、BF16,每块芯片每秒 500 个 token,MFU(算力利用率)50% 以上。
• 和 JAX 比:Qwen3 MoE 235B 在 64 块 TPU v7 上,TorchTitan + TorchTPU 每秒 1,828 个 token,JAX + MaxText 是 1,937,差距约 6%。

Qwen3 MoE 235B 从 1,024 块扩到 8,192 块 TPU v7,总吞吐近似线性增长(图源 PyTorch 博客)
这就是发帖里说的「近线性扩展」:从 1 个切片(1,024 块芯片)扩到 8 个切片(8,192 块),每个计算核心每秒处理的 token 从 2,236 降到 2,104,MFU 从 28.8% 到 27.1%,基本持平。

性能追踪图:第 t+1 层的梯度同步和第 t 层的计算重叠进行(图源 PyTorch 博客)
能保持住的一个关键原因是通信和计算重叠:跨切片同步上一层梯度的同时,芯片已经在算下一层。
推理方面,博客说 vLLM-TorchTPU 已经验证了多机推理,并引用第三方 SemiAnalysis 的 InferenceX 测评:TPU v7 跑 Qwen3.5,8K 输入 / 1K 输出场景下每百万 token 成本 2.01 美分。vLLM、SGLang、TorchTitan 的 TPU 版本和 TorchTPU 一起,在这次大会上开源。
还有哪些坑
• 动态形状还不行:XLA 默认要求形状固定。目前在 TPU 上用 torch.compile 会自动设成 dynamic=False,「有界动态形状」还在开发。
• 部分功能缺位:博客提到 FlexAttention 还不支持,移植 TorchTitan 模型时换成了普通的 scaled_dot_product_attention。
• 分布式默认有代价:为避免死锁,默认每个集合通信单独编译,博客说这会带来 30% 到 40% 的端到端性能损失,要靠 @spmd_safe 标注等手段找回。
• 一个 TPU 只能被一个进程用:所以强化学习里「训练和采样放一起」的玩法暂时不支持。
• 只在谷歌云上:和 Trainium 只在 AWS 一样,TPU 只能在谷歌云上租。
从 TorchNeuron 到 TorchTPU,路线惊人地一致:都不魔改 PyTorch,都走 PrivateUse1、Dynamo 后端、Process Group 这几个官方插口。对开发者来说,「换芯片要重写代码」正在变成「换个设备名先试试」。云厂商之间比的,越来越是芯片本身的性价比。
相关链接
• TorchTPU GitHub 仓库
https://github.com/google-pytorch/torch_tpu
• PyTorch 官方博客
https://pytorch.org/blog/introducing-torchtpu/
• TorchTPU 文档
https://torchtpu.readthedocs.io/
• TorchTitan(TPU 版)
https://github.com/google-pytorch/torchtitan
• PyTorch 官方发帖
https://x.com/PyTorch/status/2112601000670322787
• 对照阅读:AWS TorchNeuron 仓库
https://github.com/aws-neuron/torch-neuronx