1.2.6.3 动态路由的cuFile配置验证
一旦为动态路由启用了cuFile配置并完成了所需的IP地址配置,用户可以使用gdscheck进行验证。
```
$ ./gdscheck -p
...properties.rdma_dynamic_routing : 1
properties.rdma_dynamic_routing_order : GPU_MEM_NVLINKS GPU_MEM SYS_MEM P2P
fs.lustre.mount_table :
/lustre/ai200/client1 dev_id 64768 : 172.172.1.40
/lustre/ai200/client2 dev_id 64769 : 172.172.2.40
fs.weka.rdma_write_support: 0
fs.nfs.mount_table :
/mnt/nfs/ib0/data/0 dev_id 58 : 192.168.0.12
/mnt/nfs/ib1/data/0 dev_id 59 : 192.168.1.12
/mnt/nfs/ib2/data/0 dev_id 60 : 192.168.2.12
```
1.3 软件架构
GDS使存储附近的DMA引擎(NVMe或NIC)能够将数据直接推入(或拉出)GPU内存。cuFile API传递的参数包括一个文件、一个文件偏移量、一个传输大小以及一个GPU虚拟地址,参数可以向该地址读取或写入。虽然结果聚合传输是一个连续的虚拟地址范围,但在实现中可能会发生多个较小的传输。文件系统将连续的虚拟地址范围分解为可能跨越多个设备的多个传输。例如RAID-0以及可能具有非连续物理地址范围的多个页面。结果物理地址范围集合称为分散-聚集列表。
现有操作系统在尝试编程DMA引擎时,没有帮助无法处理GPU虚拟地址。GDS启用的内核驱动使用回调到GDS内核模块nvidia-fs.ko,适用于CUDA 12.8之前的所有接口,以及CUDA 12.8及以后的非NVMe挂载。这些回调提供最终分散-聚集列表中所需的GPU虚拟地址,用于编程DMA引擎。
1.3.1 软件组件
GDS软件栈中存在以下层:
- 应用程序,包含cufile.h并从CPU进行cuFile API调用。
- GDS用户级库libcufile.so。
- Linux虚拟文件系统VFS。
- Linux或供应商内核存储驱动。
- GDS内核级库nvidia-fs.ko(参见以下条件)。
1.3.2 主要组件
GDS软件架构中的主要组件包括:
(来自NVIDIA)libcufile.so,用户级cuFile库:
- 实现cuFile API,这是GDS面向应用程序的API。cuFileRead在部署软件组件的架构概览图中显示。
- 实现cuFile API有两种替代方案:
- 使用nvidia-fs.ko内核驱动。所有使用VFS的文件系统都使用此路径,但nvidia-fs.ko下列出的情况除外。
- cuFile用户库实现了一种替代实现,它:
- 在CPU系统内存中使用其非页缓存缓冲。
- 使用标准POSIX调用实现。
- 不需要使用NVFS内核驱动。
- 这是一种兼容模式,不享受GDS优势。
(非NVIDIA)非块或分布式文件系统:
- 这些文件系统可能是标准Linux虚拟文件系统(VFS),例如NFS驱动或第三方专有系统。
- 控制路径的选择基于文件系统的挂载方式:`<文件路径> → <挂载点> → <文件系统选择>`
- 在某些情况下,NVIDIA为这些或替代实现提供补丁,例如NVMe和NVMe-oF的内核模块。
(来自NVIDIA)内核级nvidia-fs.ko驱动:
- 处理来自cuFile用户库的IOCTL。
- 实现DMA回调以检查和转换GPU虚拟地址到物理地址。这些回调从存储驱动调用。
- 管理启用从设备DMA的机制和缓冲。
- 从CUDA 12.8开始,GDS支持使用上游内核PCI P2PDMA基础设施为x86_64平台(本地或使用SNAP远程)的NVMe设备提供额外的对等DMA。此功能将不再依赖nvidia-fs.ko或对nvme.ko的自定义补丁。此功能依赖于支持PCI P2PDMA的操作系统发行版,例如Ubuntu发行版上的Linux内核版本6.2及以上。此外,必须安装OpenRM驱动版本570.x或以上,并具有特定的注册密钥,以允许OpenRM驱动启用PCI P2PDMA支持。RAID0、NVMe多路径目前在上游内核中未启用PCI P2PDMA,没有专门的补丁将无法工作。有关配置详细信息,见4.2.2节。
OS对P2PDMA功能的支持可以如下检查:
```
$ cat /proc/kallsyms | grep -i p2pdma_pgmap_ops
0000000000000000 d p2pdma_pgmap_ops
```
注意
**Linux内核核心完全未经修改。**
1.3.2.1 GDS功能的工作流程
与GDS功能相关的两个工作流程如下图所示:
有关这些工作流程的更多信息,请参见工作流程(1.3.2.2)和工作流程2(1.3.2.3)。
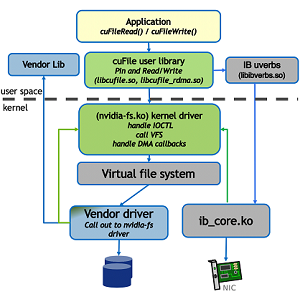
图1.2:GDS功能的工作流程
1.3.2.2 工作流程1
使用以下步骤完成工作流程1。
第一个工作流程涉及cuFileRead和cuFileWrite的使用。GPU虚拟地址由代理CPU系统内存地址表示。代理CPU系统内存地址通过Linux IO栈传递,并转换为设备特定的DMA总线地址。
注意
**以下步骤均不用于标准pread或write POSIX调用。**
1. 应用程序到libcufile.so
a. GPU应用程序或GPU启用的框架链接到cuFile库。
b. 应用程序或框架调用cuFile驱动和IO API,如cuFileRead和cuFileWrite。
- 对齐在此级别处理,可能会有一些性能影响,因此缓冲区不需要对齐,例如4KB页或512KB存储偏移量和块大小。
2. libcufile.so
- libcufile根据文件系统、配置和硬件支持决定使用哪种模式,在兼容模式和GDS之间选择,以及是否使用内部GPU缓冲区以提高效率。
3. libcufile.so到nvidia-fs.ko
a. cuFile库libcufile.so服务这些调用并向nvidia-fs.ko驱动发出适当的IOCTL调用。
b. 库与CUDA用户模式驱动库libcuda.so交互,如cuFile API的流子集所需。
4. nvidia-fs.ko到VFS
a. 内核驱动遍历必要的IO操作集,并传入IO完成回调,在kioob-common.kio-complete中,回调函数值为nvfs_io_complete,将在步骤7中使用。这些调用到VFS,VFS调用适当的底层,如标准Linux块系统(ext4/XFS和NVMe)或其他供应商分发的文件系统如EXAScaler。
5. 存储内核驱动到nvidia-fs.ko:回调API通过cuFileDriverOpen初始化注册,如GDS外部架构规范中的文件系统互操作性所述。
通过此设计,驱动只需通过以下子步骤处理GPU地址。GPU内存地址在Linux页映射之外的单独映射中可用,因此使用nvidia-fs.ko API完成以下任务:
- 检查DMA目标地址是否在GPU上(nvfs_is_gpu_page),需要不同处理。
- 使用nvfs_dma_map_sg*查询GPU DMA目标地址列表,这些地址用于替代通过VFS传递的CPU系统内存地址。
6. 存储内核驱动到DMA/RDMA引擎:在获得适当的GPU内存地址后,底层DMA引擎(例如NVMe驱动)或存储附近(例如NIC)可以被编程为直接在存储(例如NVMe或存储控制器或NIC)与GPU内存之间移动数据。CPU系统内存中的特殊代理地址不被DMA引擎访问。
7. DMA/RDMA引擎到存储内核驱动:每个块传输的完成信号被发回存储驱动层。
每次迭代的完成通过步骤4中注册的回调发回nvidia-fs.ko驱动。
1.3.2.3 工作流程2
本节提供有关第二个工作流程的信息,涉及使用ib_verbs的用户空间RDMA读写。
1. 应用程序到'libcufile.so':GPU应用程序或GPU启用的框架链接到cuFile库并调用cuFile驱动和IO API。对齐在此级别处理,虽然可能有一些性能影响,因此缓冲区不需要对齐,例如4KB页或512KB存储偏移量和块大小。
2. 'libcufile_rdma.so':获取RDMA信息(密钥、GID、LID等)到libcufile。
3. 'libcufile.so'到供应商库:libcufile调用适当的供应商库回调函数,直接在用户空间或通过nvidia-fs内核回调通信Rkeys,取决于供应商驱动实现。
1.3.3 与其他Linux倡议保持一致
Linux社区一直在努力增加对等设备之间DMA的原生支持,其中可能包括NIC和GPU。随着此支持被上游化,所有用户通过发行版采用新的Linux版本需要时间。与此同时,NVIDIA与各种第三方供应商合作启用GDS。
具体来说,Linux在Linux内核版本6.2及以上内核中增加了对PCI P2PDMA的支持,使GPU内存的ZONE_DEVICE地址指针可以通过VFS传递而不会引发缺页,在NVMe的情况下,nvidia-fs.ko
cuFile API及其实现是CUDA增加对文件IO支持的机制。cuFile API涵盖CPU和GPU存储与内存之间的显式传输。这些API还增加了对异步性和批处理的支持,这些在POSIX IO中不可用。在早先提到的功能添加到Linux之后,cuFile API仍将保持相关性。只有底层实现会改变,但现有的cuFile API不会改变。
NVIDIA对cuFile的初始实现专注于分布式文件系统和已安装适当驱动以启用存储与GPU内存之间直接传输而不使用CPU中转缓冲的系统。为了兼容性和更广泛的适用性,后续实现可能支持本地存储和隐式传输的扩展。
1.4 部署
有效使用GDS需要很好地理解GDS的部署方式、依赖关系以及限制和约束。
1.4.1 部署的软件组件
以下是部署GDS所需的软件组件的一些信息。
cuFile API是CUDA驱动和运行时API的补充,随CUDA工具包分发和安装。
应用程序通过包含cuFile.h并链接libcufile.so库来访问cuFile功能。cuFile API的流子集需要CUDA流参数,对于运行时和驱动API采取不同形式。这两种情况分别使用cuDaFile和cuFile前缀。从运行时到驱动API的转换可以在头文件中完成。
除了libcufile.so之外,使用cuFile API不需要其他链接器依赖,但存在对libcuda.so的运行时动态依赖。目前不存在对其他CUDA工具包库、CUDA运行时库或显示驱动任何其他组件的链接依赖。但是,对于使用cudaFile* API的应用程序,在它们被添加到CUDA运行时之后,应该预期最终对CUDA运行时库的运行时依赖。此步骤与应用程序使用任何其他cuda* API一致,部署中CUDA运行时的使用在NVIDIA开发者文档的CUDA部署文档中有所涵盖。
除了libcuda.so,cuFile还依赖外部第三方库。
下表提供有关第三方库和CUDA库级别的信息:
表1.3:第三方库和CUDA库级别
级别 | API、类型和枚举风格 | 依赖关系 | 打包方式 |
cuFile用户库 | 匹配以下CUDA驱动约定: cuFile API cuFile_enum vals and defines CU_FILE_errors | 提供libcufile.so,直到可能合并到libcuda中。 提供cuFile.h,直到可能合并到cuda.h中。 外部库依赖:libmount-dev libnuma-dev | 与libcufile.so分开提供。 |
CUDA运行时+工具包 | cufile.h中流API使用cudaStream_t的兼容性。 | 无 | cufile.h保持与cuda.h和cuda_runtime.h不同。 |
nvidia-fs驱动 | 内核nvfs_前缀 | 提供nvidia-fs.ko GPLv2。 cuFile使用Linux内核版本4.15.0.x及更高版本中的内核设施。 cuFile依赖MLNX_OFED版本(5.1及更高)以支持基于RDMA的文件系统。GPUDirect合作伙伴可能依赖Mellanox Connect X-5或更高版本的主机通道适配器。 | 相对于NVIDIA驱动可单独提供(直到可能合并),但可能会共同安装。 |
1.4.2 在容器中使用GPUDirect Storage
GDS有用户级和内核级组件。容器仅包含用户级代码,并依赖已安装在主机上的内核级组件。应用程序可以使用GDS的头文件和用户级库进行开发,并在容器中分发。当适当的驱动和供应商启用的内核软件未安装或未正确配置时,GDS的兼容模式使cuFile API能够继续维持功能操作,性能影响最小化。
有关容器中使用GDS的示例,请参见https://github.com/NVIDIA/MagnumIO/tree/main/gds/docker。
1.5 声明
本文档仅供参考,不应视为对产品特定功能、条件或质量的保证。NVIDIA Corporation("NVIDIA")对本文档所含信息的准确性或完整性不作任何明示或暗示的陈述或保证,并对其中的任何错误不承担责任。NVIDIA对使用此类信息的后果或因使用可能导致的任何专利或其他第三方权利的侵犯不承担任何责任。本文档不是开发、发布或交付任何Material(定义见下文)、代码或功能的承诺。
NVIDIA保留随时更正、修改、增强、改进和以其他方式更改本文档的权利,恕不另行通知。
客户应在下订单前获取最新的相关信息,并应验证此类信息是最新和完整的。
NVIDIA产品的销售受下订单时提供的NVIDIA标准销售条款和条件的约束,除非由NVIDIA和客户授权代表签署的个别销售协议另有约定("销售条款")。NVIDIA在此明确反对将任何客户的一般条款和条件应用于购买本文档中引用的NVIDIA产品。本文档不直接或间接形成任何合同义务。
NVIDIA产品并非设计、授权或保证适用于医疗、军事、航空、航天或生命支持设备,也不适用于NVIDIA产品故障或故障可合理预期导致人身伤害、死亡或财产或环境损害的应用。NVIDIA对将NVIDIA产品包含和/或用于此类设备或应用不承担任何责任,因此此类包含和/或使用由客户自行承担风险。
1.6 OpenCL
OpenCL是Apple Inc.的商标,经许可授予Khronos Group Inc.使用。
1.7 商标
NVIDIA、NVIDIA徽标、CUDA、DGX、DGX-1、DGX-2、DGX-A100、Tesla和Quadro是NVIDIA Corporation在美国和其他国家的商标和/或注册商标。其他公司和产品名称可能是与其相关联的各自公司的商标。
原文链接:https://docs.nvidia.com/gpudirect-storage/overview-guide/index.html-paths-and-staging
高端微信群介绍 | |
创业投资群 | AI、IOT、芯片创始人、投资人、分析师、券商 |
闪存群 | 覆盖5000多位全球华人闪存、存储芯片精英 |
云计算群 | 全闪存、软件定义存储SDS、超融合等公有云和私有云讨论 |
AI芯片群 | 讨论AI芯片和GPU、FPGA、CPU异构计算 |
5G群 | 物联网、5G芯片讨论 |
第三代半导体群 | 氮化镓、碳化硅等化合物半导体讨论 |
存储芯片群 | DRAM、NAND、3D XPoint等各类存储介质和主控讨论 |
汽车电子群 | MCU、电源、传感器等汽车电子讨论 |
光电器件群 | 光通信、激光器、ToF、AR、VCSEL等光电器件讨论 |
渠道群 | 存储和芯片产品报价、行情、渠道、供应链 |
< 长按识别二维码添加好友 >
加入上述群聊

带你走进万物存储、万物智能、
万物互联信息革命新时代