
先介绍一下主角:美光(Micron)是美国的存储芯片公司,做 DRAM 内存、NAND 闪存,也做 AI 芯片旁边的 HBM 高带宽内存。
这次,美光总裁兼首席技术与产品官 Scott DeBoer 开了一场技术与产品网络研讨会,公开多代技术路线图,从 DRAM、HBM 一直讲到 NAND,时间轴拉到 2030 年。
美光官方帖
https://x.com/MicronTech/status/2112932225885044826
为什么内存成了 AI 的瓶颈
美光开场就给了几个数字:从 H100 到 B300,每颗 GPU 配的 HBM 容量涨了 3.6 倍(80GB 到 288GB);AI 的上下文长度每年增长约 30 倍;训练服务器的内存三年翻倍;L4 以上的自动驾驶车,DRAM 用量是今天 L2+ 车的 10 倍以上。
它的判断很直接:内存已经成了 AI 的瓶颈,算力再强,数据喂不进去也白搭。

每一波 AI 都在推高内存需求(图源:美光研讨会幻灯片)
HBM:从“放在旁边”到“叠在上面”
美光把 HBM 的演进分成三步:
• 标准 HBM:行业通用规格,内存摆在 GPU 旁边,通过中介层连接
• 定制 HBM:和客户一起设计底层逻辑芯片(base die),加入差异化功能,从 HBM4E 开始提供
• 垂直 HBM(vHBM):内存直接叠在计算芯片上,内存和计算之间的路径最短
目的只有一个:缩短内存到计算的距离,每瓦电换更多 token。

标准 HBM、定制 HBM、垂直 HBM 三种形态(图源:美光研讨会幻灯片)
路线图上的时间点(官方注明为目标量产时间,属方向性规划,可能调整):
• HBM4:已在大规模量产,单颗堆栈带宽约 2.8 TB/s
• HBM4E:2027 年,已向重点客户送样,定制 HBM 从这一代起步
• vHBM 1:2028 年,同年还有 HBM5;之后是 HBM5E、HBM6 和 vHBM 2、vHBM 3
• vEIM(垂直边缘推理内存):面向终端设备,首代目标 2 TB/s 带宽、每比特能耗低于 1 皮焦
要把内存叠上去,靠的是封装:混合键合(hybrid bonding)提高堆叠密度、缩小互连间距,再加上更好的散热设计。

HBM、vHBM、vEIM 产品路线图(图源:美光研讨会幻灯片)
DRAM:坚持 6F²,4F² 不走,下一步是 3D
这是这次最有态度的一页。DRAM 的单元布局有 6F² 和 4F² 两种思路,后者理论上更省面积。美光的说法是:研究了二十多年 4F²,结论是“没有可行的微缩路径”,复杂度和成本都太高,所以不做。
美光的路线是继续把 6F² 做下去,靠 EUV 光刻、晶圆键合、High-NA EUV 和新材料再推几代,同时研发 3D DRAM,像当年 NAND 从平面转向 3D 那样往上叠。官方注明这张图只是方向,不代表具体时间。
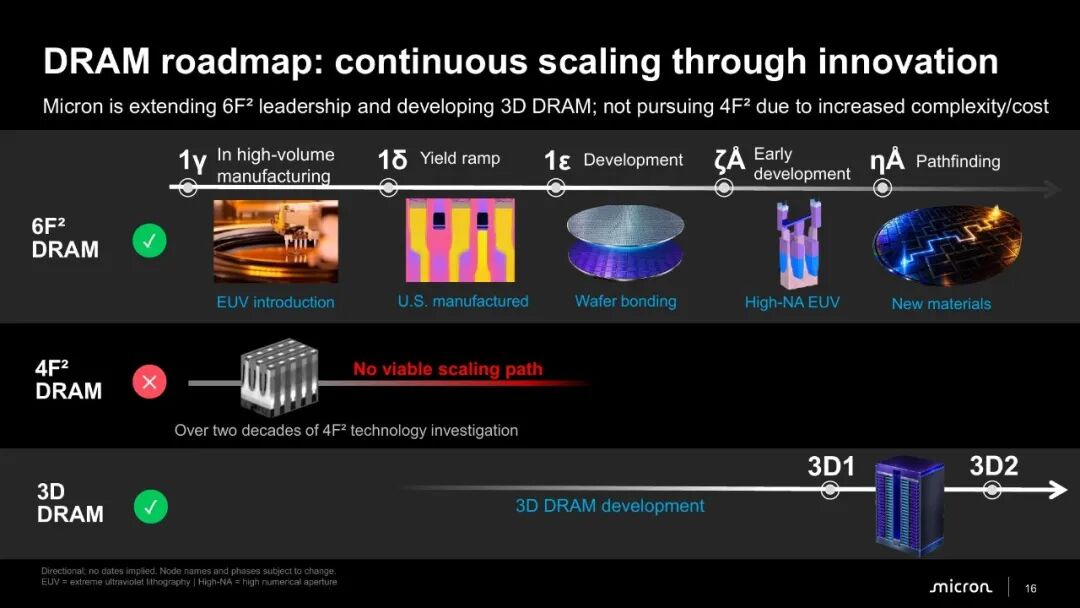
DRAM 路线:延续 6F²、研发 3D DRAM,不走 4F²(图源:美光研讨会幻灯片)
近一点的节点是 1δ(1-delta),美光称其为全球最先进的 DRAM,2027 年下半年爬坡,在美国制造。相比当前的 1γ,比特密度提升约二十几个百分点,会用来做 HBM5、vHBM 和 vEIM。
NAND 也有新一代
闪存方面,下一代 G11 NAND 采用晶圆对晶圆键合,超过 400 层,2027 年下半年量产爬坡;比特密度约为 G9 的 2 倍,I/O 速度最高提升 1.5 倍,每比特传输能耗降低 25% 以上。

G11 NAND(图源:美光研讨会幻灯片)
怎么看
这份路线图透露的趋势很清楚:AI 芯片的竞争正在变成“算力 + 内存 + 封装”一起比。HBM 不再只是一颗标准件,而是要和 GPU 厂商一起定制,最后干脆叠到计算芯片上面。至于 DRAM 本身,美光明确选择 6F² + 3D DRAM,不走 4F²。
说明:路线图时间均为美光官方给出的目标,官方注明可能调整。本文图片均为美光官方幻灯片及官方帖配图,非 AI 生成。
相关链接
美光官方帖
https://x.com/MicronTech/status/2112932225885044826
美光投资者关系:技术与产品研讨会(含回放)
https://investors.micron.com/events-and-presentations/event-details/2026/Technology-and-product-webinar/default.aspx
研讨会幻灯片 PDF
https://s25.q4cdn.com/621799436/files/doc_downloads/2026/10/MU-TP-Webinar.pdf



