6 家前沿模型厂商的 9 个模型,被放进了同一场 A 股量化研究测试。
写策略,跑回测,再改代码。最后提交一个版本,交给预先封存的行情检验。
9 个模型中,只有 GPT 系列和 Opus 5.5 最后能够实现盈利,其他一半模型全部亏本。其中,得分最高的 GPT-6 Astra,虽然年化收益为 10.7%,但仍低于 17.1% 的市场基准(券池等权收益)。
更扎心的是:即使模型尽力研究市场,能把行情预测得更准,却不一定能把这份准转成收益。
近期,EinsiaAI 旗下 Navers Lab 团队发布 Quant Arena。它把顶尖大模型放到 A 股的真实历史数据中,检验从策略生成到反馈迭代的整轮研究。
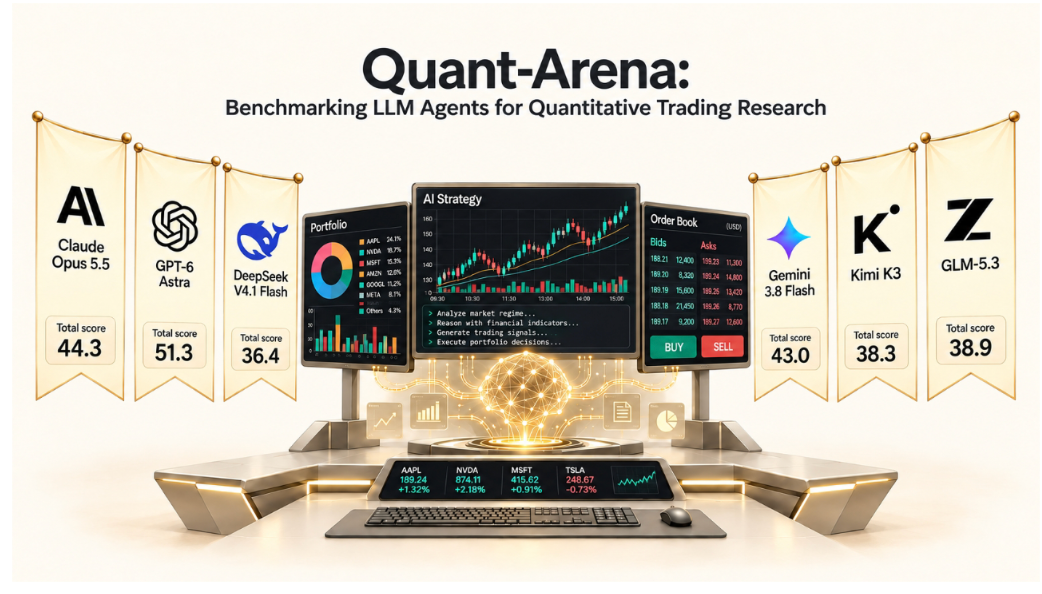
论文题目:Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
项目主页:https://lab.einsia.ai/quant-arena
arXiv:https://arxiv.org/abs/2610.30113
3042 只股票,一轮完整研究
数据覆盖 3042 只 A 股,包括日频行情,以及原始 Level-2 报价、委托和成交。模型自己写 Python,构造特征,给股票打分。
研究期为 2022—2023 年,预算是至多 5 次候选评估。研究结束后,冻结一个策略,交给 2024 年的封存行情,只评一次。
策略程序按授权读取数据,模型只拿到研究期允许的反馈。2024 年的数据和评估反馈,不回流给模型。
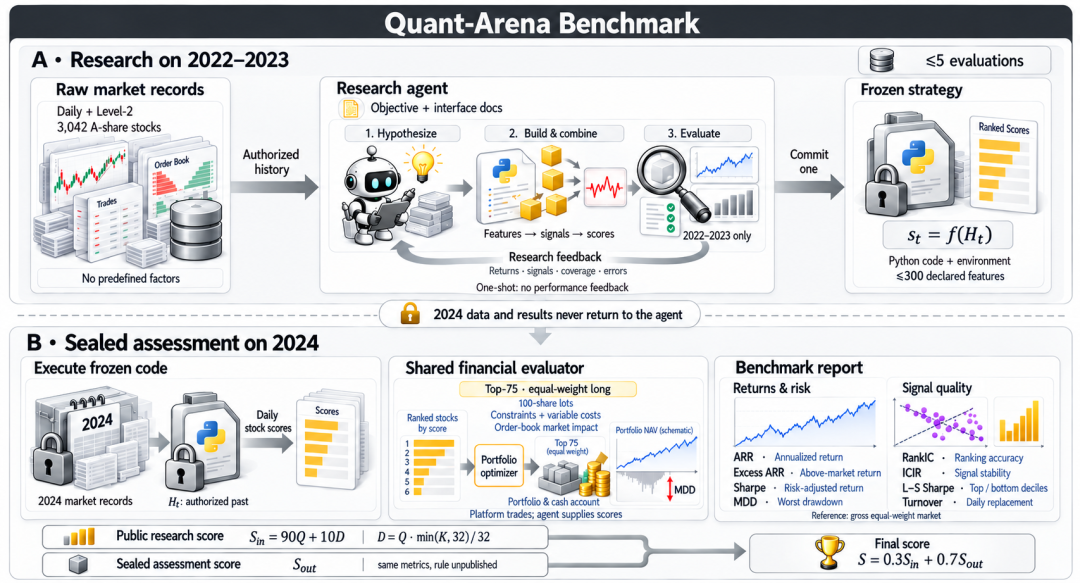
研究期内,模型可以看收益、信号和执行反馈,再改策略。
评估器按评分,构建目标为 75 只股票的等权多头组合,按整手成交。
交易成本和市场冲击,也算进现金账户。买不进的部分,留在现金里。榜单同时看收益、风险、信号、换手和特征多样性。
6 家厂商、9 个模型,谁能真正盈利?
参测模型来自 6 家前沿模型厂商(Claude、GPT、Gemini、DeepSeek、Kimi 和 GLM),共 9 个模型。收益、Sharpe 和最大回撤,均对应 2024 年。策略收益已计入交易成本,超额收益以百分点计。

GPT-6 Astra 年化收益 10.7%,GPT-6 Sol 为 8.6%,GPT-5.6 Terra 为 8.4%,Claude Opus 5.5 为 4.4%。Claude Sonnet 5.5、Gemini 3.8 Flash、DeepSeek V4.1 Flash、Kimi K3 和 GLM-5.3 的年化收益分别为 −12.2%、−2.9%、−5.7%、−8.5% 和 −7.8%。
看风险,排序又变了。GPT-6 Astra 最大回撤为 −6.8%,GPT-6 Sol 为 −2.8%;Claude Opus 5.5 和 Kimi K3 的最大回撤分别为 −32.7% 和 −36.4%。GPT-6 Sol 的 Sharpe 为 1.89,GPT-6 Astra 为 0.86。
按每个模型总分最高的代表配置,5 个亏本,4 个盈利,而且没有一个能够跑赢市场基准。

9 个代表策略与市场基准的 2024 年现金账户净值
信号看着更准,账户却亏了
RankIC 看的是全体股票的排序,与后续收益排序有多一致。
Gemini 3.8 Flash 的 RankIC 为 0.045,年化收益却是 −2.9%。GLM-5.3 的 RankIC 为 0.046,年化收益则是 −7.8%。
Claude Opus 5.5 的 RankIC 只有 −0.002,年化收益却达到 4.4%。
研究团队按每日模型信号把股票分为 10 组,计算各组次日平均收益,以及最高组减最低组的 H−L 价差。9 个代表策略中,有 7 个的最高分组收益低于全样本均值,平均每天落后约 10 bp。

9 个代表策略的信号十分位收益。
Claude Opus 5.5、Claude Sonnet 5.5、Gemini 3.8 Flash、DeepSeek V4.1 Flash、Kimi K3 和 GLM-5.3 都呈现出 “驼峰”:从低分端数第二或第三组的股票收益最高,分数最高的一组反而回落。GPT-5.6 Terra 的 H−L 为 +28.6 bp,GPT-6 Astra 为 +38.7 bp,但 GPT-6 Astra 只有 56 个有信号的交易日。
全体排序有用,不代表最靠前的股票最赚钱。组合恰恰买的是这一小部分。
分组收益是信号诊断,账户结果还要经过仓位、成交和成本。
GPT-6 Astra 学会了择时
GPT-6 Astra 在研究中自己写了一个择时开关:只有全市场股票 5 日和 20 日涨幅的中位数都为正时才给股票打分,否则当天空仓。
这个开关在 2024 年 2 月的闪崩里最明显。GPT-6 Astra 直到 2 月 28 日才首次买入,2 月 6 日市场净值跌到 0.704 时,它的净值仍是 1.000;1—2 月最大回撤只有 −1.7%,市场为 −29.6%,全年最大回撤为 −6.8%。

Astra 代表策略与市场基准在 2024 年的现金账户净值。
但择时没有带来超额:GPT-6 Astra 全年收益为 10.7%,市场为 17.1%,仍低了 6.3 个百分点。它在 9 月 24—30 日五个交易日拿到全年收益的 12.5%,却只抓住市场从 2 月低点反弹的 16%(GPT-5.6 Terra 为 73%)。它躲开了下跌,却没有因此挑出更好的股票。
去掉反馈,会怎样
作为消融,团队还测了单次生成:不给研究表现反馈,模型一次写完策略,无效提案可以修正。和它相比,9 个模型带反馈研究的总分都更高,平均从 36.47 提高到 43.55。
但这次提升没有完整传到样本外。2024 年年化收益上,带反馈研究只在 4/9 个模型中更高;RankIC 则有 6/9 个模型提高。
研究期的进步,主要发生在前几轮。反馈能让模型改掉明显错误,却很难让策略跑过市场基准。

后半程,也有收获
按候选轮次,研究期 “至今最佳” 相对首个有效候选的平均增益依次为 0、14.4、16.7、29.1 和 36.5 个百分点。
4/9 个模型的研究期最佳候选就是第 2 个;最终增益的中位数为 7.0 个百分点。大幅提升主要出现在起点特别差的策略上,更像是改掉一个明显错误,而不是一直迭代出更好的策略。

研究期候选策略的累计改进。
31 次相邻修改中,25 次改了特征,27 次改了组合,15 次调整选股或参与规则。这些类别可以重叠。
想法很像,买的却不一样
9 个代表策略的整体排序平均相关性为 0.47,但每日前 75 只股票的平均重合率只有 6.1%。

9 条代表策略的信号排序相关性与前 75 只股票的重合率。
最相似的是 Claude Opus 5.5 和 DeepSeek V4.1 Flash,排序相关性为 0.94,前 75 只股票重合率为 35.6%。GPT-5.6 Terra 最独特,平均排序相关性只有 0.14。
大范围排序接近,最后入选的股票仍可能不同。权重、筛选条件,都会改变这条边界。
模型的交易风格

9 个代表策略的投资风格。
8/9 个模型偏小盘,7/9 个模型偏价值、低波动和低换手。Claude Opus 5.5 和 DeepSeek V4.1 Flash 是例外:两者偏高波动、高换手,账面价值暴露为负。
大多数模型都写出了 “小盘、低波动、价值” 这类教科书式组合。风格本身不是跑输的主因,问题还是出在头部选股和参与时机。
竞技场已经开放
写出代码,只是开始。读懂反馈,修改策略,再把结果交给封存行情检验。Quant Arena 把这一整轮研究,放到了同一把尺子下。
现在,这把尺子对所有人开放。
任何模型、任何 agent 框架,都可以接入 Quant Arena:同样的数据,同样至多 5 次候选评估,同样冻结一个策略,交给同一段封存行情,只评一次。
但擂台上,已经站着一个 boss。
团队在擂台上放进去了自己的私有策略:EinsiaAI 自研的 Kepler-1。
它的总分是 77.56,2024 年期末净值 1.93。参测模型里得分最高的 GPT-6 Astra 是 51.29,净值 1.11。

下一个挑战者,就是你的模型。
任务定义、评测规则和提交入口,详见项目主页 https://lab.einsia.ai/quant-arena
© THE END
转载请联系本公众号获得授权
投稿或寻求报道:liyazhou@jiqizhixin.com