

官方演示视频截帧:Sage-A1.5 在 MacBook 上本地运行
上海人工智能实验室的 InternScience 团队开源了 Sage-A1.5:一个 35B 参数的 MoE 智能体模型,每个 token 只激活约 3B,权重按 Apache-2.0 发布。
它不是又一次刷榜聊天模型,主打「长程干活」——拆任务派给子智能体并行跑,跑到一半自己停下来复查,再去做开放式科研探索。
权重、量化版和部署说明都已放出,四个入口如下:
Hugging Face
https://huggingface.co/InternScience/Sage-A1.5
魔搭 ModelScope
https://modelscope.cn/collections/InternScience/Sage-A15
Gitee
https://gitee.com/hf-models/Sage-A1.5
AtomGit
https://atomgit.com/collections/InternScience/Sage-A1.5
先说结论:它是什么
• 规模:总参数约 36B(Hugging Face 显示 BF16 约 359 亿参数),官方称 35B-A3B,即每 token 激活约 3B。
• 底座:基于 Qwen3.6(Qwen3.6-35B-A3B)和自家上一代 Agents-A1 继续训练。
• 上下文:官方启动命令给到 262,144(约 256K)。
• 版本:BF16 原版,另有 FP8、Q4_K_M / Q8_0 / F16 GGUF 量化版。
• 许可:Apache-2.0。
谁做的
模型卡写明「based on Qwen3.6 and Agents-A1 from Shanghai AI Laboratory」。
技术报告(arXiv 2610.28578,10 月 20 日提交)署名为 Sage-A1.5 Team,作者名单里有 Lei Bai、Bowen Zhou、Dahua Lin 等。
InternScience 是 Hugging Face / 魔搭上的发布账号,前作 Agents-A1、MLEvolve、Agents-K1 也挂在它名下;Alpha-Innovator 是官方放项目主页与部署资料的组织账号。
翻源码:官方没开训练代码
先说实话:公开资料主要是模型权重、项目主页与案例展示,外加一个本地部署脚本包;训练代码和数据都没开。
真正能「读源码」的地方,是 Hugging Face 上的 config.json、chat_template.jinja,以及部署包里的脚本。下面按这三样讲。

config.json 的 text_config 节选(layer_types 实为 40 项,此处折叠)
架构:混合注意力 + 256 专家 MoE。model_type 是 qwen3_5_moe。40 层里每 4 层只有 1 层是标准全注意力,另外 3 层是线性注意力——这是它敢把上下文开到 256K 还不太吃显存的原因之一。
FFN 部分有 256 个专家,每个 token 选 8 个,再加一个共享专家,所以总参数 35B、实际算力开销接近 3B 模型。
另外还带 1 层 MTP(多 token 预测)头,权重单独放在 model-mtp.safetensors,可用于投机解码加速。架构名是 Qwen3_5MoeForConditionalGeneration,并带图像/视频预处理配置。
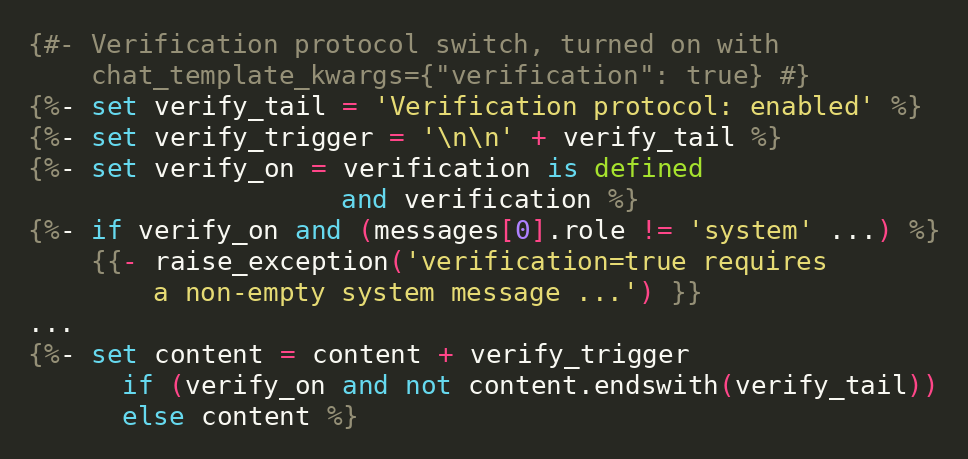
chat_template.jinja 中「验证模式」开关(节选)
核心机制之一:「验证模式」是一个模板开关。官方说的 Agentic Verification——推理途中停下来,回顾哪些已确认、哪些失败了,再换方向——在代码里落地得很朴素。
请求时传 chat_template_kwargs={"verification": true},模板就会在 system 消息末尾追加一行「Verification protocol: enabled」。注释写明训练时用的就是这串后缀,必须逐字一致。
它还做了两道校验:传字符串 "true" 会报错,要求用 JSON 布尔值;没有非空 system 消息也会报错。也就是说,这个能力是训练进模型的,默认关闭,靠一句触发词打开。
核心机制之二:子智能体编排。报告里的 Agentic Orchestration,是让主智能体把任务拆给多个上下文互相隔离的子智能体并行做,再汇总证据。调度框架(harness)没有开源,公开的是模型本身和案例展示。
怎么跑:单卡起服务,Mac 也有示例

上:vLLM 带工具调用的启动命令;下:官方部署包 llama.cpp 示例
README 给的 vLLM / SGLang 命令都是 tensor-parallel 1,也就是单卡起服务,开 262K 上下文;推理解析用 qwen3,工具调用解析用 qwen3_coder。
官方推荐采样:temperature 0.85、top_p 0.95、top_k 20、presence_penalty 1.1。
部署包里还有 llama.cpp(GGUF Q4_K_M + mmproj)、昇腾 NPU、AMD ROCm 的模板,以及把本地服务接到 Claude Code 的示例。
官方也很克制:昇腾和 AMD 只是「条件模板」,没在目标硬件上验证;部署包 README 明确写着「资料不足以确认 NPU / AMD 实测支持、最低内存或 tokens/s」。
BF16 权重本身约 72GB,24GB 消费卡跑原版不现实,想本地玩建议直接上 Q4_K_M GGUF。
工具调用示例声明了三个工具:google_search、read_page、PythonInterpreter——搜索、读网页、跑 Python。搜索服务需要你自己接。
成绩:35B 档里很能打

官方评测图(来源:Hugging Face 模型卡)
对比对象是同档的 A1、Ornith-1.5,以及更大的 Kimi-K3、GLM-5.3、GPT-5.6-sol。
按官方图:SWE-bench Pro 61.2(比 A1 的 43.6 高 17.6),MLE-Lite 65.2(A1 为 43.9);PinchBench 90.0、IFBench 81.6、FrontierScience-Olympiad 81.0、CMT 80.0 均为图中最高。
模型卡文字还给出 XBench-DS-2510 92.0、GAIA 95.1、HLE(带工具)55.1。
短板也在图上:Scicode、CritPt、ALE-CLI 明显落后于大模型,SWE-Pro 也还差 GPT-5.6-sol 几分。
另外 BrowseComp 一项,图里标 82.8,模型卡正文写 81.7,以官方后续更正为准。
以上分数均为官方自报,尚未见第三方复现。
我们怎么看
Sage-A1.5 的看点不在单项分数,而在「3B 激活就能做长程智能体」:单卡能起,Mac 能跑,验证模式一个开关就开。
报告自己也承认局限:编排和验证训练仍以搜索、研究综述类任务为主,超长轨迹上下文开销不小;科学案例用的是计算模拟和历史数据回放,不是真实实验。
想搭本地科研助手、又不想把资料发到云端的同学,值得一试。
相关链接
Hugging Face
https://huggingface.co/InternScience/Sage-A1.5
魔搭 ModelScope
https://modelscope.cn/collections/InternScience/Sage-A15
Gitee
https://gitee.com/hf-models/Sage-A1.5
AtomGit
https://atomgit.com/collections/InternScience/Sage-A1.5
技术报告 arXiv 2610.28578
https://arxiv.org/abs/2610.28578
扫码加入 Sage-A1.5 交流群(二维码 10 月 29 日前有效)




