在 OS 上做运维,需要做相当多的事情。比如需要查看机器的负载、内存、磁盘,还有关键服务在不在。要是服务有问题,下一步通常就是去查 systemd 和日志。等到要装软件、做升级,就绕不开 RPM、依赖和升级日志了。如果构建或升级失败了,还需要查看 CI 日志也得翻。这都得花费不少时间。
然而这些工作,现在已经有不少被人写成 Agent 和 Skill 了,并且在 GitHub、AtomGit(GitCode)和 OpenAtom openEuler(简称:“openEuler”或“开源欧拉”)SkillHub 上都能找到。不过,其中大多不能直接拿来用。有的并不是一条可以安装的技能,而是一个完整产品,或者只是一份清单。有的就算写成了技能,也常常是按别的环境写的,其中命令、软件包和日志位置对不上 openEuler。过多的混杂 Agent 和 SKill 依旧需要花费大量时间进行筛选和整合。
Scout Agent 正是为解决这些问题而设计。它能够从现有资源中筛选与 openEuler 运维场景相关的候选 Agent 和 Skill,并说明各项资源与 openEuler 运维需求的关联依据,帮助运维人员快速识别具有复用价值的能力。在此基础上,运维人员可以结合目标 openEuler 版本及具体业务环境,进一步完成适配、验证与整合,降低资源筛选成本,提升运维能力的复用效率。
https://atomgit.com/openeuler/witty-agents/tree/master/scout-agent

Scout Agent 会到 GitHub、AtomGit(GitCode) 和 openEuler SkillHub 上去找 Agent / Skill。它要留下的,是比较热、并且和 openEuler 运维有关的条目。这些条目会放进候选池,方便社区版、商业衍生版和自用版本的运维人员继续筛选,再按自己的版本做微调、做整合。
使用时,同一套命令可以反复执行。scout discover用来开始一轮巡检,scout serve 用来打开审查页。模型地址、访问令牌、来源是否打开、热度门槛,都写在配置里。每一轮会单独留下候选清单和报告,之后要核对、要整合,也能找到对应的一批。
巡检时,三个网站上的内容会先被取回来,整理成同一种格式,再去掉重复的和热度明显不够的。然后由大模型判断,它是不是一条可以安装的 Agent 或 Skill,以及和 openEuler 的运维有没有关系。比如查看服务和日志、构建 RPM、核验漏洞、查看升级和构建情况,也包括内核、容器和安全加固。判断通过的才会进入候选池,同时写进 Markdown 报告和审查页。
扫描这一步只是把条目取回来:GitHub、AtomGit、openEuler SkillHub 负责采集,并不在这里决定哪一条入选。
热度是一条硬性要求:代码仓默认关注 Star 在 1000 到 50000 之间、并且仍在更新的项目。这个范围可以在配置里调整。另外,很早以前比较热、现在已经没什么人维护的仓库,不会只因为名字里有 agent 就留下来。
大模型负责看内容本身:它会判断这是不是可以安装的 Agent 或 Skill,和 openEuler 运维是否相关,例如 systemd、内核与驱动、RPM 和 dnf、升级日志、CVE 验证、容器、安全加固、构建发布。模型会给出 OS 相关分、入选理由和风险。分数不够的不会进入候选池。如果和 openEuler 更贴近,还会有一个相关分供参考,但不会只靠这一项就入选。
03 巡检流程:从多源采集到候选筛选
目前进行了三路采集:GitHub、AtomGit、openEuler SkillHub。
GitHub 会按照配置好的检索条件,查找带有 Skill 结构的仓库,以及和 linux、systemd、kernel、rpm、容器相关的项目,并读取 README,供后面判断。AtomGit 用来覆盖国内代码托管上的同类仓库。SkillHub 会翻看列表,同时用 systemd、rpm、kernel、ebpf、dnf、container、selinux 这些词进行搜索。
三个网站给出的字段并不一致,因此需要先整理成同一张表,包括名称、作者、链接、摘要、Star、下载量、更新时间和一段原文。如果同一个仓库在 GitHub 和 SkillHub 上都出现了,会合并成一条。这样后面做微调的时候,处理的是同一条能力,比如构建 RPM 或核验 CVE,而不用把同一条内容重复筛选一遍。
在交给大模型之前,还会先按规则去掉一批。Star 不在范围内、很久没有更新的,以及 awesome 列表、产品 SDK 这类不适合作为一条运维技能来整合的项目,都会被挡下。因为这类清单解决不了 openEuler 上服务起不来、软件包构建失败的问题,继续看下去只会多花时间。被挡下的原因会保留,需要时可以回看。
通过热度要求之后,才进行入选判断。模型会确认它是 Agent 还是 Skill,并给出 OS 相关分。分数达到要求、又适合放进技能管理平台的,记为入选;其余记为未入选,理由一并保留。
判断时看的是,它是否对应一项具体工作。比如采集 openEuler 的系统信息,构建和复盘 RPM,验证 CVE 修复,分析升级日志,诊断构建失败。不过,入选并不等于可以直接拿来用。其中的命令、路径和发布步骤,往往还要按社区版、商业版本或自用版本再微调,不同版本的改法也不完全一样。
一轮结束后,会生成入选清单、未入选清单,以及一份按来源整理的 Markdown 报告,方便后续筛选和整合。
前端构建完成后,执行 scout serve,在浏览器打开 http://127.0.0.1:8787/,进入「候选审查」。

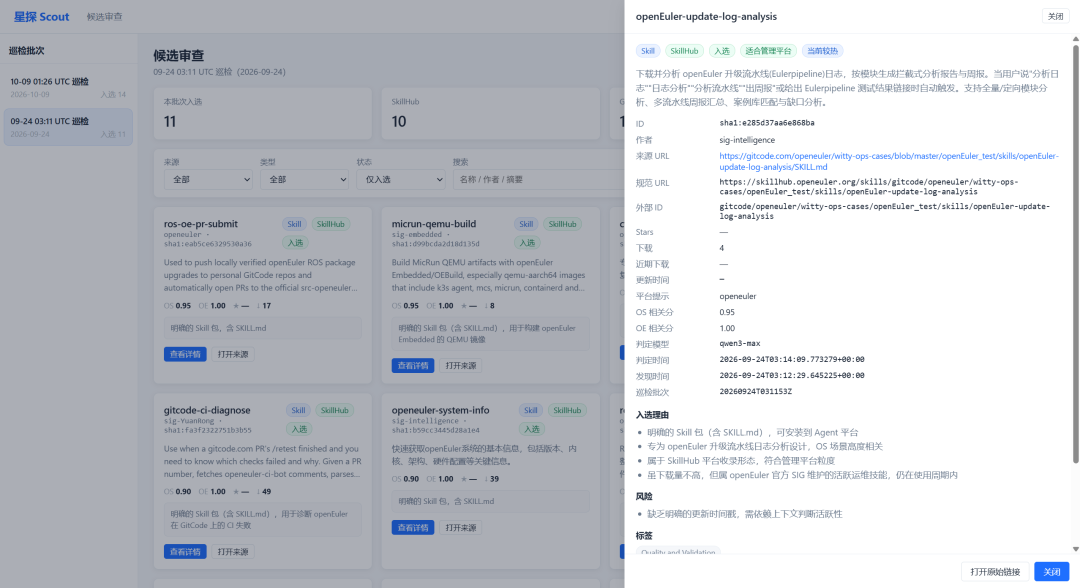
页面左边是历次巡检,可以看到时间和这一批入选了多少条。右边是这一批留下来的候选,运维人员可以在这里继续筛选。
基本信息:右上方有四张数字——本批次入选、SkillHub、GitHub、AtomGit。如果需要再跑一轮,可以点「重新巡检」。巡检过程中会有提示,结束后会出现新的一批。
筛选:可以按来源(SkillHub / GitHub / AtomGit)、类型(Skill / Agent)、状态(仅入选 / 仅未入选 / 全部)进行过滤,也可以用名称、作者或摘要,在这一批结果里查找。比如先看和软件包有关的,或者只看已经入选的,这样能少花一些来回查找的时间。
详细信息:卡片上有 OS 相关分、Star、下载量,还有一句入选理由。点开以后,可以看到作者、原始链接、更新时间、完整理由、风险、标签和原文摘录。运维人员可以据此判断,这条技能是在查看系统信息、构建 RPM、验证 CVE,还是在分析升级和构建日志,然后再打开仓库,看接到具体版本上还需要微调哪些地方。
在项目目录中准备 Python 环境,并安装Scout Agent:
python3 -m venv .venvsource .venv/bin/activatepip install -e .
然后复制一份示例配置,填上大模型的接口地址、密钥和模型名,以及 GitHub Token。AtomGit 的 Token 可以按需要再填写。热度范围、回溯天数、每个来源获取多少条、哪个来源需要打开,都在 config.toml 里修改。
cp config.example.toml config.toml配置完成后,可以开始一轮巡检:
scout discover如果这一轮先不调用大模型,只需要查看扫描和热度过滤的结果,可以加上 --skip-llm:
scout discover --skip-llm
巡检结束后,终端会输出这一轮的 run_id、入选条数,以及候选文件、未入选文件和报告的路径。也可以按日期查看候选:
scout show candidates --date 2026-10-09如果要打开前面的审查页,需要先构建前端,再启动服务:
cd web && npm install && npm run build && cd ..scout serve
这些结果分别放在三处。data/candidates/ 是入选和未入选清单,data/reports/ 是 Markdown 报告,data/raw/ 是原始扫描缓存。
下面是 2026 年 10 月 9 日的一轮巡检结果。这一轮留下 14 条;除此之外,预过滤淘汰了 74 条,未入选的还有 97 条。

从这些结果可以看出,一次升级里往往会连续碰到多件事。需要先查看系统信息,然后构建、复盘并引入软件包;升级之后还要查看日志;如果构建失败,就要诊断 CI;有的场景还需要在容器里验证;安全方面,则要确认 CVE 是否已经修复。Scout Agent这一轮是把这些技能分别找出来的,还没有整合到一起。不过,这些条目的 OS 相关分都在 0.90 以上,和 openEuler 的相关程度也比较高,后续可以按社区版、商业版本或自用版本继续微调。同一轮里还有 ROS 软件包升级,以及升级后提交 PR,这些和 openEuler 的发布流程有关。
没有留下的条目,也可以看出筛选时在看什么。比如 Star 达到 39821 的 awesome-copilot 是一份清单,对 openEuler 的服务排查和 RPM 构建帮助不大,继续整合只会增加工作量。Star 只有几百的一批小仓库,则是因为热度不够被去掉的。
Scout Agent 要处理的是 openEuler 运维里那些已经写成 Agent 和 Skill、但仍然比较混杂、不能直接使用的内容。社区版需要这些能力,基于 openEuler 的商业版本和自用版本也同样需要,只是落到具体环境时,还要再做微调和整合。
有了巡检结果之后,运维人员不必再每天到网站上逐条筛选。每一批都保留了编号、来源、分数和理由。打开一条,可以看到它和 openEuler 的哪项工作有关,也可以回到仓库里确认,命令、路径和发布步骤还需要改哪些地方。
目前 Scout Agent 已经可以完成发现和筛选。后续还可以加上人工审查,按不同版本做适配,并把多条技能整合到一起,使得整个运维更加方便简单。


Witty 是 openEuler 的智能运维入口,支持用户通过自然语言处理各类运维问题,内置日志检测、知识库、集群管理、性能调优等全套运维能力套件。基于上述运维套件,Witty 进一步构建问答、故障诊断、性能调优多类智能 Agent,覆盖单机、集群、超节点多种部署场景。本专项旨在演示 Witty 智能运维入口的基础能力,并深度拆解各类智能体,剖析其内部工作原理。
-END-
供稿 | 邹柳石
编辑 | 丘云
校审 | 赵家麒、郑振宇、刘彦飞

关注我们,了解更多
▼